10 月开源小模型扎堆,家用机器到底能跑哪个


上周有朋友把一台小主机的配置单发给我,就一句话:这玩意儿能不能自己跑个模型,别老花钱调 API。我没直接答,因为这问题的答案,这半个月变化有点大。
十月才过一半,模型圈发的东西已经比往年同月密。有意思的是两条相反的线同时在走:旗舰继续往上堆,另一头在拼命往小里压。前者是新闻,后者才跟你桌上那台机器有关。
这半个月到底发了什么
按时间顺一遍,只挑跟「能不能自己跑」有关的。
10 月 1 日,Google 发 Gemini 4 Argon。输出 token 上限从上一代的 6.4 万提到 100 万,DeepSWE v1.1 拿到 77.9%。定价还是每百万输入 2 美元、输出 10 美元,没涨。这属于云端旗舰那条线,跟你家机器没关系,但它是后面所有对比的标尺。
10 月 8 日,OpenAI 把 GPT-6 全量推给所有档位;同一天 Anthropic 发 Claude Haiku 5.5,官方说运行成本比上一代低约 75%。这一代最值得看的是它的成绩分布:OSWorld 2.1 离线子集 72.4%,上一代 Haiku 4.5 只有 15.7%,差得离谱;可同一个模型在 Terminal-Bench 4.0 上只有 39.2%,而 Sonnet 5.5 是 70.6%。一个便宜了四分之三的模型,在桌面操作上突飞猛进,在终端任务上还差一大截。
10 月 9 日,Underdog AI 放出 Saluki 27B。它把 Qwen 3.8 27B 做成 2-bit 压缩,文件 7.89GB,官方说保留原版 96% 的基准能力,在工具调用上甚至超过原版,许可证是 Apache 2.0。7.89GB 是什么概念——一台 16GB 内存的小主机能塞进去。
10 月 13 日有两条。面壁的 MiniCPM-V 4.7,35B-A3B 是该系列第一个 MoE,官方演示在 iPhone 17 Pro Max 上用 3GB 内存跑到每秒 13 个 token 以上;同一天 Meta 的超级智能实验室发了 Muse Wonder,顺带把 816B 的 Muse Spark Open 权重也放了。
10 月 17 日,DeepSeek 发 V4.1-Flash-1017,权重上了 Hugging Face 和魔搭;顺手把自家 Search 和 Fetch API 开放给所有开发者,每千次 0.75 美元,API 用户到 10 月 31 日免费。英伟达那边则放出 Nemotron 3.5 Super VL,120B 开源,每个 token 只激活 12B,权重、训练数据、配方一起给。
我的判断:主线是「更小」,不是「更强」
三点,按我觉得的重要性排。
一、能力密度成了新指标
过去两年大家比参数、比榜单分数。这个月冒出来的说法是「每 GB 能装多少能力」,Saluki 官方给的是 7.5 倍智能密度。这个数怎么算的我不知道,别当定论,但方向我认同:模型文件小到能放进家用机器,「本地部署」这四个字才立得住。27B 压到 7.89GB,代价是精度,不是免费午餐。
二、便宜不等于能干,而且落差在任务之间
Haiku 5.5 那组数字是这半个月最好的教材。同一个模型,桌面操作 72.4%,终端任务 39.2%。所以「哪个模型好」这问题没有脱离任务的答案。群里那些「某某吊打某某」,多半是拿一个任务的分数去比另一个任务的分数。
三、家用场景的瓶颈不是显存
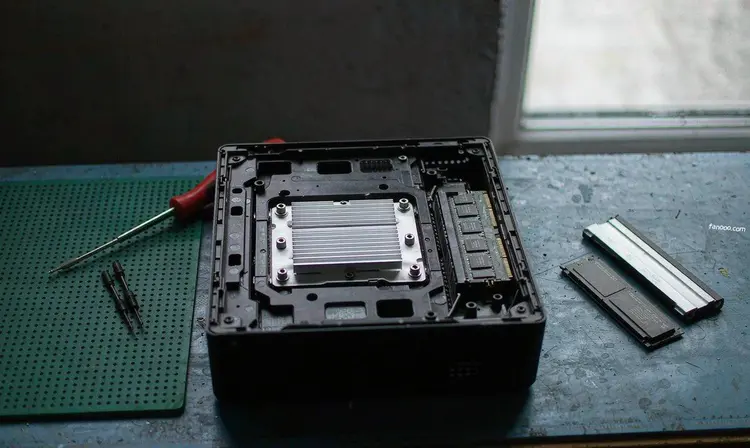
这点我踩过。7.89GB 的模型能进 16GB 内存,但一开长上下文,速度掉得比 benchmark 难看多了。真正卡住你的是内存带宽和上下文长度,不是「装不装得下」。厂商演示的 13 token/s 是跑短对话,你让它读一份两万字的文档再总结,体验完全是另一回事。
家里这台机器,怎么用才不亏
我的建议是分层,别指望一个模型通吃。
本地小模型干脏活。分类、摘要、格式整理、定期抓取后写进表格、文件重命名这类。这些活对「聪明」要求低,对稳定和不花钱要求高,跑在本机最合适。一个月几万次调用,用 API 其实也不贵,但数据不出门这件事,API 给不了。
便宜的小旗舰干路由。先让小模型判断这条请求值不值得上大模型,能省掉一大半调用。Haiku 5.5 这种降价 75% 的模型,干这个正好。
旗舰干硬活。写代码、长文档推理、多步骤规划。这些任务上省下来的钱,最后基本都会以返工的形式还回去。
硬件门槛说两个实数:16GB 内存的小主机,跑 27B 的 2-bit 量化是可行的,但别指望同时开一堆服务;8GB 的老机器,老实跑 7B 到 9B,别硬上。想认真折腾的,内存比 CPU 重要,这个道理在NAS 存储分层那篇里其实说过一遍。
如果你本来就在考虑买一台本地 AI 机器,先看这篇——分清哪些能力你真用得上,比对着参数表纠结有用。预算卡得紧的,全闪小机器那篇里算过一笔账,可以对照着看。
一个提醒,和一点不确定
开源权重不等于随便商用。Saluki 是 Apache 2.0,宽松;但很多厂商说的「开放权重」是自定义许可,限制商用、限制再分发,有的连输出用途都要管。用之前把许可证原文读一遍,别只看「开源」两个字。
还有我不确定的地方:这些 benchmark 我没法逐个复现,2-bit 量化在长上下文和多轮工具调用上的实际衰减,公开数据还不够。厂商演示的永远是最好的那一面,真实工作流跑一轮才知道。所以我现在的态度是——值得试,但别急着把付费 API 停掉。
真要动手,先拿一个你每天都要做的重复任务去试,跑两周,跟你现在的做法比时间和出错率。这比看一百篇评测有用。
文中产品与数字来自 2026 年 10 月的公开报道(腾讯新闻、IT时代网、HeadsUpAI、AI FrontPage 等),具体参数、许可证与价格请以厂商官方发布为准。