n8n 是什么?零基础入门、应用场景与学习路线


如果你在网上搜「n8n 是什么」,多半会看到这样的答案:一个开源的工作流自动化工具,可以把不同的应用连起来。这句话不算错,但等于没说——它没告诉你这东西到底替谁干活、替你省的是哪一段时间。
换个大白话的说法:n8n 是一个把你自己反复手动做的事情,变成一条能自己跑起来的流水线的工具。
这篇是整套课程的第一篇,目标只有一个:让你在动手之前,先弄清楚它是什么、能干什么、值不值得学。看完全文,你应该能回答一个问题——我手上哪件事,适合交给它。
适合谁看,看之前需要准备什么
完全没有自动化经验也能看。不需要会编程,不需要买服务器,甚至不需要先装软件。这篇只讲概念和判断,动手部分在下一篇。
如果你已经用过 Zapier 或者写过脚本,可以重点看第三、四节,那里讲了它们的实际差别,能帮你判断要不要换。
先看它跑起来的样子
概念讲再多不如看一眼。下面这张图,是我在一台服务器上做的第一个练习工作流,三个方块,从左往右跑了一次,耗时 233 毫秒。
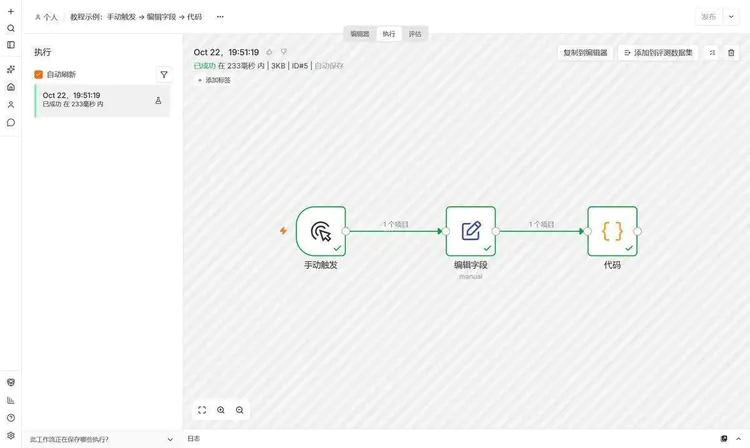
图里的三个方块叫节点。最左边带闪电标记的是起点,叫触发器,表示「这件事从哪开始」;中间那个叫编辑字段,负责造两个字段出来;最右边是代码节点,跑了一小段 JavaScript。
方块之间的箭头是数据流动的方向。整个这一条,从起点到终点,就叫工作流。
这条流水线干的活很傻:造出「福州」和「27」两个值,拼成一句话。但把它换成真实业务,就是把「打开网页抄数据、粘到表格、再发个邮件」这一串动作,交给机器。结构是一样的。
三个词就够了:节点、连线、工作流
- 节点(Node):一个具体动作。发一个 HTTP 请求、读一行表格、判断一个条件、跑一段代码,都是一个节点。我这台实例的节点列表里能翻到近千个,覆盖各种常见系统。
- 连线:决定谁先谁后。数据顺着线往下走,可以分叉、可以汇合。
- 工作流(Workflow):节点加连线,组成一件事的完整流程。它才是你在 n8n 里做的「产品」。
真正的门槛不在这三个名词,而在一个概念上:数据在节点之间是怎么传的。
n8n 里的数据永远是一个「条目数组」。上一个节点查出来 10 行数据,传到下一个节点就是 10 个条目,下一个节点会对这 10 个条目各执行一遍,而不是只处理第一行。想通这一点,后面大部分「为什么我的输出是空的」的问题,你自己就能查出来。
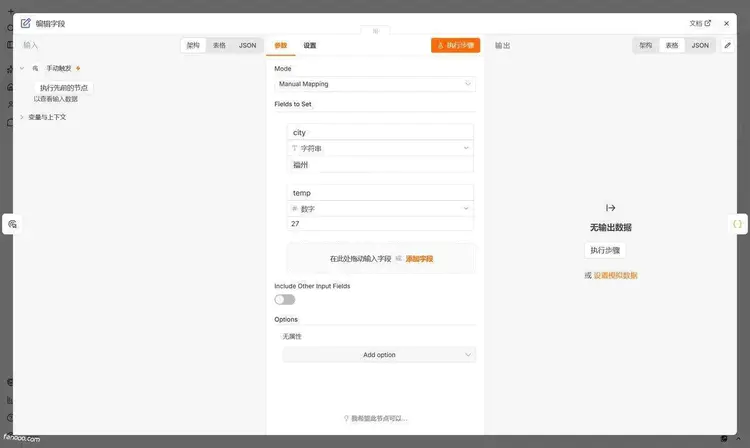
这个面板是 n8n 2.x 改过的。左边输入、中间参数、右边输出,调试的时候不用来回切标签,比 1.x 顺手很多——网上大量中文教程还停在 1.x 的界面,照着做会对不上位置,这是新手最容易懵的地方之一。
还有个小细节:我这台实例装的是简体中文,但你会发现参数名依然是英文,Mode、Fields to Set、Include Other Input Fields 这一串。n8n 的中文只翻了外壳,节点参数没翻,看到英文别慌,对照着填就行。
它到底解决什么问题
办公室里大部分重复劳动,本质是同一件事:把数据从 A 搬到 B,顺便改个样子。
举个例子。客户在网站上填了一张表单 → 你把信息抄进表格 → 给销售发条消息 → 三天后提醒他跟一次。四步,每步都不难,一天做二十遍就烦,而且一定会漏。
n8n 干的就是这个:按时、按条件、不出错地把数据送到该去的地方,再顺手通知该知道的人。
这个定位要记牢。它不生产数据,也不替你做判断。想清楚这一点,你就不会指望它「帮我分析一下这个月的销售情况」——那种活它做不了,得靠数据库和脚本。
和 Zapier、Make、自己写脚本比,差在哪
| n8n | Zapier | Make | 自己写脚本 | |
|---|---|---|---|---|
| 部署方式 | 云版或自托管 | 只有云 | 只有云 | 自己决定 |
| 计费逻辑 | 自托管不按次收 | 按任务数 | 按操作数 | 只算服务器 |
| 自由度 | 高,可写代码 | 中 | 较高 | 最高 |
| 上手难度 | 中 | 最容易 | 偏陡 | 看人 |
| 谁负责维护 | 自己 | 平台 | 平台 | 自己 |
说点实际感受。Zapier 最省事,注册完就能用,代价是按任务数计费,量一上来账单很难看,而且遇到稍微绕一点的数据处理就得想办法绕路。Make 的可视化更强,能画出真正的分支和循环,价格也温和,就是界面学习成本高一些。
n8n 的差别在两点:能自己部署,数据在自己机器上;不按任务数收费,跑多少次都不额外掏钱,成本只剩服务器。代价也很实在——升级、备份、半夜出故障,都得你自己处理。这不是小事,后面会专门讲运维。
至于自己写 Python 脚本:它更灵活,但没有界面,改个条件就得改代码,出了问题也没有执行记录可以回看。我的分工是这样的——一次性的、逻辑绕的数据处理写脚本;需要长期定时跑、要给人看进度、要接好几个外部系统的,放 n8n 里。
顺带说一句 n8n 的授权。它不是标准开源协议,用的是 fair-code 的 Sustainable Use License。自己用、公司内部用都没问题;但如果想把 n8n 包一层卖给客户,得先看清楚条款,别想当然。
哪些事适合交给它,哪些别交
适合的,基本都长这样:
- 定时汇总:每天早上把几个来源的信息抓回来,去重后生成一份早报
- 事件触发:有人提交表单、发来邮件、订单状态变了,自动分类、入库、通知
- 系统同步:表格、数据库、CRM 之间对账,差异单独列出来
- 内容流水线:抓取、清洗、AI 改写、人工审核、定时发布
- 监控告警:网站挂了、接口报错、数据异常,第一时间有人知道
- AI 相关的活:把大模型接进业务流程,做分类、抽取、问答
不适合的也要说清楚,省得你走弯路:
- 毫秒级的高频实时交易,它不是为这个设计的
- 复杂计算和算法,直接写代码更省事
- 一个月才跑一次、手工十分钟的流程,做成工作流反而更难维护
n8n 和 AI 是什么关系
这两年 n8n 火,很大程度是因为 AI。它内置了接大模型的节点,也有一整套做 Agent 的节点:给模型配工具、配记忆,让它自己决定先调哪个。
但分寸要拿捏。工作流是确定性的:条件满足走左边,不满足走右边,跑一百次结果一样。模型不是这样,同一个提示词,今天分类对了,明天可能就错。
我的原则是:确定性的事交给节点,模糊的事交给模型,涉及钱和承诺的环节一定留人工复核。这条原则会贯穿后面所有 AI 相关的文章。
要花多少钱
两条路,成本结构完全不同。
用官方云版:按月付费,省掉安装和维护,价格以官网为准(会调整,我不写死数字)。自己部署:软件本身不花钱,成本是一台服务器,2 核 4G 跑日常任务绰绰有余,一年几百块的机器够用。真正贵的是时间——装、配、升级、排错都得自己来。
云端还是自托管,怎么定
判断标准其实只有一条:这批数据能不能出你的机器。
处理客户名单、订单、病历这类数据,建议自托管。只连公开信息、做个 RSS 提醒,云端更省心。自托管还有两个国内特有的坑:服务器访问境外 API 可能不通,需要单独处理网络;反过来,云端版也进不了你公司内网的系统。这一条比价格重要得多,别等做完才发现取不到数据。
学它需要什么基础
会复制粘贴、看得懂表格,就能开始,第一阶段完全不需要写代码。
但往中段走会撞上两堵墙:一是 JSON,数据长什么样、怎么取其中一层;二是 HTTP,请求、响应、状态码分别是什么意思。这两样不必精通,但绕不过去。再往后做 AI 和 Agent,就要求你能读懂报错,能自己判断是数据问题还是配置问题。
从零到能用,路线怎么走
我把整个过程拆成了 8 个阶段,每个阶段都有明确的产出物,写在学习路线那一页。这里只给三个顺序上的提醒:
- 先把 n8n 装稳,再做工作流。数据卷没配好,容器一删工作流全没,这种事我见过不止一次。
- 先把手头一个小流程跑通,再去学新节点。光看文档不产出,一周就忘干净。
- 别急着上 AI。数据流和错误处理没弄明白,接上模型只会让问题更难查。
新手最容易走偏的四个地方
追新节点。节点库里有近千个节点,用不上的都是噪音。真正高频的就那二十来个:触发、HTTP、编辑字段、IF、Switch、Merge、循环、代码。
只跑成功路径。接口会超时、会限流、会返 500。第一次上生产就吃亏的人,基本都栽在这。
不看执行记录。报错先翻执行记录里第一个变红的节点,比在群里问人快得多。
把 n8n 当低代码平台。它能写代码,但强项是协调,不是计算。重活交给脚本或数据库。
安全提醒
自托管的 n8n 相当于把你一批系统的钥匙放在这台机器上。三件事必须做到:绑域名上 HTTPS,别把 5678 端口裸奔在公网;给 n8n 用的 API Key 只开够用的权限;备份时别漏了 n8n 的加密密钥——密钥丢了,数据库里的凭据就解不开,光有数据也恢复不出来。
小结
n8n 是把重复操作变成流水线的工具。它的价值不在节点数量,而在于你把「这件事该怎么做」写下来之后,它每天照着做,不会忘也不会漏。
学习的顺序是三句话:装稳、跑通一个、再往外扩。
下一篇讲具体怎么装:n8n 怎么安装,新手本地部署与首次运行完整教程。装完再回来跑一遍上面那条三节点的工作流,会顺很多。
参考资料
最后更新:2026 年 10 月 22 日,用的是 n8n 2.43.7。你那边版本要是比这新,界面可能又挪了位置。