Como verificar erros de inicialização do n8n e ocupação de portas


O n8n no servidor não sobe, o que é um tipo de falha relativamente fácil de investigar — ele sempre deixa uma linha de erro. O problema é que essa linha de erro frequentemente aponta na direção errada. Para escrever este artigo, usei python para iniciar um http.server e ocupar a porta, e o n8n mesmo assim me disse "será que já existe outro n8n em execução".
A seguir, divido as falhas de inicialização em quatro categorias conforme "em qual linha o log para", cada uma com um comando que pode ser executado imediatamente. Os textos originais dos erros foram todos gerados na minha própria máquina com 2.43.7, sem alterar uma única palavra.
Escrito para quem faz self-hosting: vale para instalação global via npm, execução em Docker e gerenciamento por systemd. Quem usa a versão cloud pode pular, lá a inicialização não depende de você. O único pré-requisito é conseguir entrar no shell da máquina ou visualizar os logs do container.
- A inicialização é um fluxo em quatro etapas, e em qual etapa o log para determina o que investigar
- Porta ocupada: três comandos, mais uma mensagem enganosa
- Não sobe mesmo com a porta livre: endereço errado, permissões insuficientes
- ECONNREFUSED: quem exatamente está te recusando
- A linha "SQLite package has not been found installed"
- O diretório .n8n não permite escrita
- Minha ordem real de investigação
- Como saber se realmente subiu
- Aquela mensagem "serviço recusou a conexão" na interface
- Consulta rápida de seis textos originais de erro
- Três lembretes de segurança
A inicialização é um fluxo em quatro etapas, e em qual etapa o log para determina o que investigar
Primeiro, lembre-se de como é uma inicialização normal, caso contrário, ao ver um log pela metade, você não saberá qual parte está faltando. Esta é uma inicialização completa na minha máquina, começando de um diretório vazio:
No encryption key found - Auto-generating and saving to: /data/n8n/.n8n/config
Initializing n8n process
n8n ready on 127.0.0.1, port 5678
Migrations in progress, please do NOT stop the process.
Starting migration InitialMigration1588102412422
Finished migration InitialMigration1588102412422
Editor is now accessible via:
A linha "No encryption key found" só aparece na primeira inicialização, depois a chave já está gravada em .n8n/config e não é mais impressa. A chave e o banco de dados são um par; se a chave for trocada, todas as credenciais armazenadas no banco não poderão ser descriptografadas — isso é assunto de outro artigo. Aqui basta lembrar que pertence à primeira etapa da inicialização.
Dividi todo o fluxo em quatro blocos, e a forma do erro de falha de cada bloco é completamente diferente:
| Ordem | O que está fazendo | Erro típico quando esta etapa falha |
|---|---|---|
| 1 | Ler arquivo de configuração, carregar ou gerar chave de criptografia | EACCES: permission denied, mkdir、Failed to load command "start" |
| 2 | Conectar ao banco de dados, com 5 tentativas automáticas | Initial database connection attempt N failed: connect ECONNREFUSED、SQLite package has not been found installed |
| 3 | Iniciar listener HTTP | n8n's port 5678 is already in use、n8n webserver failed, exiting listen EADDRNOTAVAIL |
| 4 | Executar migração do banco de dados, iniciar task runner | Migrations in progress Depois disso, nenhuma linha mais Finishede o processo desaparece |
Há um detalhe particularmente fácil de julgar erroneamente:n8n ready on 127.0.0.1, port 5678 não é igual a poder usar. Ele aparece em Migrations in progress Antes, a porta já estava aberta, a base de dados ainda estava a ser atualizada. Neste momento, o editor não abre, o que é normal; espera que a migração termine.
No quarto parágrafo há ainda uma coisa que só existe na 2.x: o nó Code não corre no processo principal, o n8n inicia outro n8n task-runner. Usa ps para ver a relação pai-filho e consegues perceber.
# ps -o pid,ppid,etime,cmd -p 1053,7782
    PID    PPID   ELAPSED CMD
   1053       1  6-09:37:45 n8n start
   7782    1053  6-09:33:32 n8n task-runner
O processo principal está lá, o runner não, a interface principal abre, mas ao executar o nó Code dá erro. Quando vires este sintoma, não penses no código, primeiro ps vê se o runner está lá.
Porta ocupada: três comandos, mais uma mensagem enganadora
Primeiro vê o que o próprio n8n diz. Quando colide com a porta, não despeja uma pilha de erros, apenas uma frase em linguagem humana, e depois o processo termina com código de saída 1:
n8n's port 5678 is already in use. Do you have another instance of n8n running already?Esta frase desvia oitenta por cento da atenção para «outro n8n». A realidade é: o que está a ocupar a porta pode ser qualquer coisa. Eu usei python3 -m http.server 5693 ocupei a 5693, e apontei o n8n para a 5693, e ele diz a mesma frase. Adivinhar não serve, investiga.
# ss -ltnp 'sport = :5678'
State  Recv-Q Send-Q Local Address:Port Peer Address:Port Process
LISTEN 0      511        127.0.0.1:5678      0.0.0.0:*    users:(("n8n start",pid=1053,fd=24))
ss Vem incluído no Debian, Ubuntu e CentOS, a saída é a mais limpa e dá diretamente o pid. Se não quiseres memorizar a sintaxe de filtragem,lsof também dá, só que o nome do processo virá com escape:
# lsof -i :5678 -sTCP:LISTEN
COMMAND    PID USER   FD   TYPE DEVICE SIZE/OFF NODE NAME
n8nx20st 1053 root   24u  IPv4  33852      0t0  TCP localhost:5678 (LISTEN)
n8nx20st Não é lixo,x20 é um espaço, o nome verdadeiro é n8n start. Da primeira vez que vires, vais pensar que é um programa desconhecido, não entres em pânico. Se quiseres apenas o pid,fuser o mais simples:
# fuser -n tcp 5678
5678/tcp:             1053
Obter o pid,ps -o pid,etime,cmd -p <pid> ver há quanto tempo está a correr. Este passo permite distinguir duas situações completamente diferentes.
Uma é um processo antigo próprio que não morreu.No systemd fizeste stop , ou docker rm , e o processo continua pendurado em segundo plano. Um etime a mostrar várias horas de n8n é basicamente isso. A abordagem limpa é primeiro systemctl stop n8n, depois usar kill, não kill -9logo de início — uma migração interrompida a meio por um kill forçado pode deixar a base de dados num estado de semi-atualização, e isso só se resolve restaurando um backup.
A outra é outro serviço a ocupar a tua port.Em servidores cloud, ports como 8080 e 3000 serem silenciosamente ocupadas por um painel ou por um pequeno serviço Node é muito comum. Nesse caso só há dois caminhos: o outro ceder o lugar, ou tu mudares de port.N8N_PORT=5679 Mudar leva um minuto, mas não alteres só num sítio — o reverse proxy,WEBHOOK_URL、N8N_EDITOR_BASE_URL e as ports fixas escritas lá vão errar junto, e é assim que os webhooks deixam de ser recebidos.
Há ainda outra situação que parece conflito de port, mas é na verdade um problema de endereço de escuta. O valor por omissão de N8N_LISTEN_ADDRESS do n8n é ::, dual-stack, também cobre o IPv4. Portanto, outros ocuparam apenas 127.0.0.1:5678, se você iniciar o n8n com os valores padrão, ele também não sobe. Testei na prática: o python estava vinculado apenas a 127.0.0.1:5694, o n8n iniciou no 5694 com o endereço padrão e o erro exibido ainda era "port 5694 is already in use".
A propósito,:: ativar tudo traz outro problema: o n8n fica diretamente exposto em todas as interfaces de rede, incluindo a pública. Na minha máquina a configuração é o contrário, escuta apenas localmente e o exterior fica a cargo do nginx.
Environment=N8N_HOST=127.0.0.1
Environment=N8N_LISTEN_ADDRESS=127.0.0.1
Environment=N8N_PORT=5678
Environment=N8N_PROTOCOL=http
Mesmo que a porta não esteja ocupada, ele não sobe: endereço errado, permissões insuficientes
A porta está livre, por que ainda não sobe. Duas causas são as mais comuns, e os erros nem parecem da mesma família.
A primeira, o endereço de escuta não existe na máquina local. Trocou-se o datacenter, reconstruiu-se a instância, o DHCP renovou o lease e mudou o IP, então aquele IP antigo no arquivo de configuração não é mais reconhecido:
n8n webserver failed, exiting listen EADDRNOTAVAIL: address not available 10.9.9.9:5679Isto foi o que eu obtive ao escrever N8N_LISTEN_ADDRESS como 10.9.9.9, essa máquina não tem esse endereço na interface de rede. Ao ver EADDRNOTAVAIL não fique verificando a porta, vá ip addr ver quais IPs a máquina realmente tem, ou simplesmente escreva 127.0.0.1。
A segunda, permissões. Portas menores que 1024 exigem root, ou exigem CAP_NET_BIND_SERVICE essa capability. Esse erro é lançado pelo Node, não é empacotado pelo n8n, então vem com um trecho de node:events de stack:
node:events:505
    throw er; // Unhandled 'error' event
    ^
Error: listen EACCES: permission denied 0.0.0.0:80
    at Server.setupListenHandle [as _listen2] (node:net:2306:21)
Não recomendo iniciar o n8n na 80 só para simplificar. Uma camada de reverse proxy oferece muita coisa: renovação de certificado, gzip, rate limiting, whitelist de IP, tudo isso dá menos dor de cabeça do que o esquema próprio do n8n, e para alterar a configuração não é preciso reiniciar o n8n. Se realmente for usar a 80 diretamente, então conceda as permissões adequadamente. Na minha máquina o root está executando, por conveniência; em máquinas compartilhadas por várias pessoas não recomendo fazer isso — o n8n armazena as credenciais de todos os seus serviços de terceiros, e quando as permissões do processo são ampliadas, o que pode ser levado também é ampliado.
ECONNREFUSED: quem exatamente está te recusando
Este erro é na verdade emitido pelo n8n na segunda etapa da inicialização: ele tenta conectar ao banco de dados, a porta do outro lado não responde, e o kernel retorna um RST. O n8n tenta novamente 5 vezes, com intervalos de 1 segundo, 2 segundos, 4 segundos, 8 segundos e 16 segundos, cerca de 31 segundos no total, e então desiste e sai.
Initial database connection attempt 1 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 1000ms
Initial database connection attempt 2 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 2000ms
Initial database connection attempt 3 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 4000ms
Initial database connection attempt 4 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 8000ms
Initial database connection attempt 5 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 16000ms
There was an error initializing DB
There was an error initializing DB
Error: There was an error initializing DB
    at Start.exitWithCrash (/usr/lib/node_modules/n8n/src/commands/base-command.ts:361:28)
O trecho acima foi gerado por mim ao alterar DB_TYPE para postgresdb e apontar a porta deliberadamente para 5433, onde ninguém está escutando, copiado exatamente como está.There was an error initializing DB Rodar duas vezes seguidas também é verdade, não foi erro de copiar e colar, não duvide de si mesmo ao ver linhas repetidas.
É preciso entender corretamente a retentativa: é uma retentativa de "conectar ao banco na inicialização", não de "esperar para sempre". Ao ver attempt 1, não se apresse em reiniciar, espere 31 segundos; ao ver 5 falhas consecutivas, é realmente inacessível, reiniciar cem vezes dará no mesmo.
A porta no endereço é a única pista útil.DB_POSTGRESDB_PORT O padrão é 5432, reportar 5433 indica que você mesmo configurou, provavelmente copiou uma configuração e esqueceu de alterar; reportar 127.0.0.1:5432 Mas você claramente instalou o banco em outra máquina, o que indica que a variável de ambiente não teve efeito — no systemd Environment= uma linha errada, no Docker -e faltando uma, ambos causam isso.
O caso mais traiçoeiro é dentro do container. O n8n roda no container, a configuração escrita como DB_POSTGRESDB_HOST=127.0.0.1, este 127.0.0.1 é o loopback do próprio container, não do host. O banco roda no host, de dentro do container não há como conectar, e o erro reportado ainda é ECONNREFUSED, parecendo exatamente igual a "banco não iniciado". Ou coloque o banco também no compose, usando o nome do serviço como host; ou faça o container reconhecer o endereço do host.
Verificar a conectividade do lado de fora é muito mais rápido do que adivinhar nos logs do n8n:
# nc -vz 127.0.0.1 5678
Connection to 127.0.0.1 5678 port [tcp/*] succeeded!
# nc -vz 127.0.0.1 5433
nc: connect to 127.0.0.1 port 5433 (tcp) failed: Connection refused
Se o nc conecta mas o n8n ainda não consegue, o problema está nas credenciais e no nome do banco, vá ver os logs do próprio postgres, não fique rodeando no lado do n8n.
Aquele "SQLite package has not been found installed"
Este é o erro mais facilmente mal interpretado na segunda parte da inicialização, e eu mesmo já caí nele. Ele aparece no cenário padrão de SQLite — ou seja, quando a maioria das pessoas instala o n8n pela primeira vez. O log é assim:
Initial database connection attempt 1 failed: SQLite package has not been found installed. Try to install it: npm install sqlite3 --save. Retrying in 1000ms
Initial database connection attempt 2 failed: SQLite package has not been found installed. ...
...
Error: There was an error initializing DB
DriverPackageNotInstalledError: SQLite package has not been found installed. Try to install it: npm install sqlite3 --save.
    at SqliteLibrary.loadLibrary (/usr/lib/node_modules/n8n/node_modules/@n8n/typeorm/dist/driver/sqlite-pooled/SqliteLibrary.js:30:19)
É fácil se deixar levar pelo trecho final da stack e pensar que "falha ao inicializar o DB" significa que o banco de dados quebrou. Mas a primeira linha já deixa claro:sqlite3 Este módulo nativo não está presente. Ao instalar o n8n via npm, um módulo nativo é compilado junto; ambiente de compilação incompleto, atualização de versão major do Node, ou instalação de pacotes com --ignore-scripts, tudo isso pode fazer esse trecho faltar. Este log estava entre dois registros de inicialização bem-sucedida na minha máquina; na época não anotei qual passo resolveu, só sei que não tem relação com o banco de dados em si.
Há três caminhos de correção, ordenados do menor para o maior custo: instalar o ambiente de compilação (python3、make、g++) e reinstalar o n8n; ou ativar N8N_REINSTALL_MISSING_PACKAGES=true, para que ele mesmo instale os pacotes faltantes na inicialização, seja no Dockerfile ou no systemd; se não quiser mexer nisso, troque para a imagem Docker, onde esses módulos nativos já vêm compilados. A frase npm install sqlite3 --save no erro é para o cenário de "n8n instalado como dependência local"; copiá-la literalmente em instalação global pode não funcionar.
Registrando de passagem o requisito de versão: o n8n exige Node 20.19 até 24.x; fora dessa faixa, o Node apresenta vários problemas estranhos com módulos nativos. A minha máquina está com 24.21.0.
O diretório .n8n não é gravável
Falha na primeira parte da inicialização, com o erro contendo EACCES 和 mkdir, indica que ele não consegue nem criar o próprio diretório de dados..n8n O diretório guarda arquivos de banco de dados, chaves de criptografia e configuração; se o diretório não for gravável, ele simplesmente não sobe:
No encryption key found - Auto-generating and saving to: /root/n8n_noperm/.n8n/config
Error: Failed to load command "start"
Error: EACCES: permission denied, mkdir '/root/n8n_noperm/.n8n'
    at mkdirSync (node:fs:1410:26)
    at InstanceSettings.loadOrCreate (/usr/lib/node_modules/n8n/node_modules/n8n-core/src/instance-settings/instance-settings.ts:353:12)
Aqui tem uma pegadinha:Ele primeiro imprime "sem chave, gerando e salvando em determinado caminho", e só depois falha. Olhando apenas para a linha anterior, parece que tudo correu bem, mas na verdade nada foi escrito. O critério é um só — se depois houver Editor is now accessible via, se não houver, é porque não subiu.
Este trecho foi executado por mim com o usuário nobody, com o diretório de destino em /root e impresso abaixo, ninguém consegue escrever. Na operação real, o mais comum é Docker: o n8n dentro do container roda com o usuário node de uid 1000, e no host, se o diretório que você mkdir for root 700, ao montar dá esse erro. A correção é acertar o proprietário do diretório no host, não encher de permissões:
chown -R 1000:1000 /srv/n8n-datachmod 777 conseguir fazê-lo subir, eu não recomendo. Naquele diretório há arquivos de chave de criptografia, qualquer usuário na mesma máquina pode ler, o que equivale a pendurar a chave de todas as credenciais de terceiros do banco na maçaneta da porta.
Minha ordem real de troubleshooting
Quando houver problema, não comece a ler da primeira linha do log, siga esta ordem, em cinco minutos você localiza o segmento:
- Veja o status do serviço.
systemctl status n8nOudocker ps -a. O importante não é se está active ou failed, mas simRestartvezes eRestarting (1) 3 seconds agoesse tipo de ciclo. Ciclo significa que ele está reiniciando e morrendo repetidamente, vá ver o log, não fique mexendo no systemd. - Encontre o log.Tente primeiro
journalctl -u n8n -n 50. A minha retorna-- No entries --, porque a unit redireciona a saída para um ficheiro:StandardOutput=append:/data/logs/n8n.out.log. Neste caso, bastatail -100 /data/logs/n8n.out.log. Docker édocker logs --tail 100 n8n。 - contar quantas vezes reiniciou.
grep -c 'n8n ready on' /data/logs/n8n.out.log, a minha é 30. O log é escrito em modo append, o histórico está todo lá, o mesmo erro a repetir-se significa arranque em ciclo. - Verifique a porta.
ss -ltnp 'sport = :5678', compare com a lista acima. - Verifique a saúde.
curl -s http://127.0.0.1:5678/healthz. Se o processo estiver vivo, responde{"status":"ok"}, isto não depende da base de dados.
O journalctl do passo 2 retorna vazio, o que facilmente leva a pensar que o serviço não escreveu log nenhum. O serviço é claramente gerido pelo systemd, mas o log está no ficheiro. Por isso, primeiro systemctl cat n8n verifique se há redirecionamento, é mais rápido do que andar às voltas nos logs.
No lado do Docker, são mais dois passos:docker ps -a A coluna STATUS mostrará Restarting (1) 3 seconds ago, o número entre parênteses continua a subir significa reinícios repetidos; se as portas não corresponderem, verifique primeiro docker port n8n, ele listará as portas do host e as portas do container. A minha instalação é via npm, os erros originais dentro do container não os testei pessoalmente, estas linhas são escritas com base no comportamento comum do docker.
Como saber se realmente arrancou
A porta estar à escuta não significa que consiga trabalhar. O n8n tem dois endpoints de verificação prontos, cuja diferença é muito prática:
# curl -s -o /dev/null -w '%{http_code}n' http://127.0.0.1:5678/healthz
200
# curl -s http://127.0.0.1:5678/healthz
{"status":"ok"}
# curl -s -o /dev/null -w '%{http_code}n' http://127.0.0.1:5678/healthz/readiness
200
/healthz 200 apenas indica que o processo consegue responder, não verifica a base de dados./healthz/readiness é que «a base de dados está ligada e as migrações também terminaram». Nos primeiros segundos após o reinício, o primeiro pode já estar em 200, o segundo ainda não acompanhou, ou seja, as migrações ainda estão a correr. Ao escrever scripts de monitorização use readiness, não use healthz — só o primeiro reflete «se esta máquina consegue receber tráfego».
Depois de ambos estarem em 200, faça uma verificação real:
- Abra o editor, consiga fazer login, consiga ver a lista de workflows, sem ecrã branco a rodar.
- Execute um workflow qualquer com um nó Code, com sucesso. Este passo valida o task runner, que como foi dito antes é frequentemente ignorado.
- Publique (publish) o workflow, deixe-o correr realmente uma vez, no registo de execuções deve ver-se esta execução de produção com estado de sucesso.
Não omita o terceiro ponto. Algumas implementações têm o editor totalmente normal, mas na hora não executam, a causa está no worker em modo de fila que não se ligou, este tipo de problema só se expõe ao correr realmente uma vez.
Aquela frase «serviço recusou a ligação» na interface
Quando o arranque falha nem sequer consegue entrar na interface, por isso esta secção fala de outra situação — o n8n arrancou, mas o que está ligado no workflow não arrancou. A direção de diagnóstico destas duas falhas é completamente oposta, não as confunda.
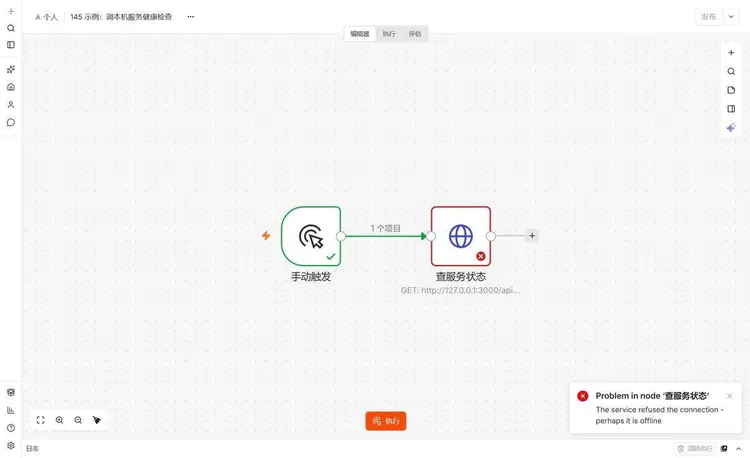
Depois de uma execução falhar, o nó no canvas fica vermelho e aparece no canto inferior direito Problem in node '查服务状态', e abaixo uma linha de texto pequeno The service refused the connection - perhaps it is offline. Essa frase é a tradução em linguagem humana feita pelo n8n, ela não diz a porta nem o protocolo.
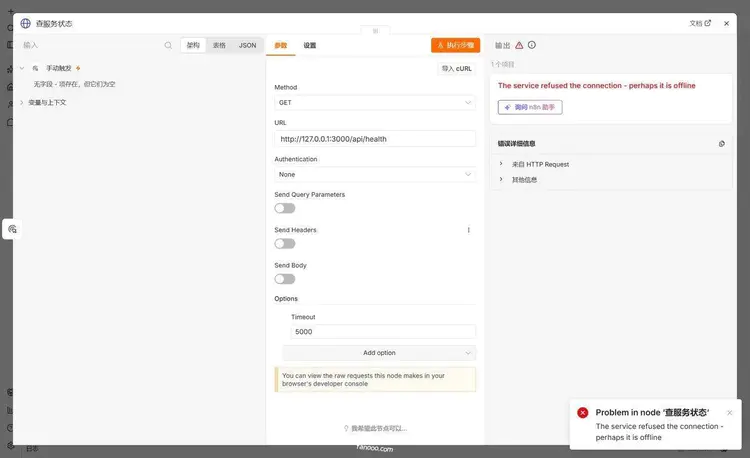
Dê duplo clique no nó, vá até o painel de saída à direita e role para baixo, há um 「Detalhes do erro」 recolhido, clique para ver a informação original.
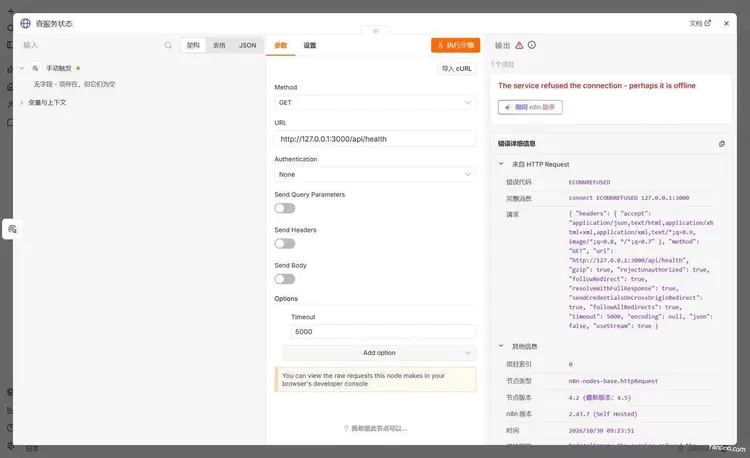
A linha 「Código de erro」 é ECONNREFUSED, a 「Mensagem completa」 é connect ECONNREFUSED 127.0.0.1:3000. Até aqui bate com aquele erro da inicialização, o mesmo código de erro, só que desta vez ocorreu dentro do nó. Pegue essa porta e vá para nc -vz, para saber na hora se conecta ou não.
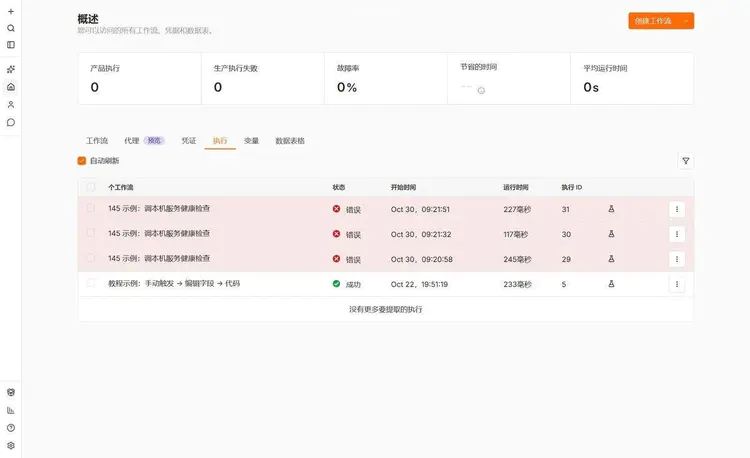
No histórico de execução há outro critério gratuito: o tempo de execução. As minhas três foram 227, 117, 245 milissegundos. Só fica tão rápido assim quando nem o handshake TCP aconteceu; se o outro lado conectou mas retornou 500, ou deu timeout, o tempo seria de centenas de milissegundos a vários segundos, ou até bater no timeout que você definiu. Erro em menos de duzentos milissegundos, pense direto em 「porta/endereço/serviço não iniciado」, pensar em 「conteúdo retornado pela interface incorreto」 é perda de tempo.
Consulta rápida das seis mensagens de erro originais
| Mensagem de erro original | Onde está travando | Direção de tratamento |
|---|---|---|
n8n's port 5678 is already in use... |
Terceiro parágrafo, port | ss -ltnp 'sport = :5678' Encontrar o pid, parar o antigo ou trocar a port |
n8n webserver failed, exiting listen EADDRNOTAVAIL |
Terceiro parágrafo, endereço | O IP na configuração não existe na máquina local,ip addr Verificar |
Error: listen EACCES: permission denied 0.0.0.0:80 |
Terceiro parágrafo, permissões | ports abaixo de 1024 exigem privilégio, trocar a port ou adicionar capabilities |
Initial database connection attempt N failed: connect ECONNREFUSED |
Segundo parágrafo, banco de dados | Aguardar as 5 tentativas de retry, depois nc -vz host port |
DriverPackageNotInstalledError: SQLite package has not been found installed |
Segundo parágrafo, dependências | 补 sqlite3, ou reinstalar o n8n |
EACCES: permission denied, mkdir '/.../.n8n' |
Primeiro parágrafo, diretório | O owner do diretório de dados está incorreto, alterar o owner, não usar 777 |
Três lembretes de segurança
Os listeners temporariamente ampliados durante o troubleshooting, lembre-se de revertê-los.Para dar uma olhada de fora se subiu ou não, altere N8N_LISTEN_ADDRESS para 0.0.0.0 ou adicione uma -p 5678:5678, e esqueça depois de ver. O editor do n8n na internet pública é só uma tela de login, um script de varredura consegue testar milhares de vezes por dia. A minha máquina só escuta em 127.0.0.1, a rede pública passa pelo nginx na 443, esse é o estado normal, não mude para um estado temporário por causa de troubleshooting e deixe assim.
Passe um pente fino antes de postar os logs.O log de inicialização contém a URL completa do webhook, e o caminho do webhook em si é uma credencial, quem obtiver o caminho consegue injetar dados no seu workflow; o stack trace contém caminho de instalação, endereço de rede interna, hostname do banco de dados. Antes de postar em grupos ou enviar para fóruns pedindo ajuda, substitua esses dados, e só depois poste.
Não escreva a senha do banco de dados na linha de comando.docker run -e DB_POSTGRESDB_PASSWORD=xxx Ela ficará no shell history e também aparecerá na saída de docker inspect , qualquer pessoa na mesma máquina que possa executar comandos docker conseguirá vê-la. Use --env-file, ou o EnvironmentFile=do systemd, permissão de arquivo 600. A unit que postei anteriormente é escrita exatamente assim, a senha está em /etc/n8n/instance-ai.env , não na unit.
Resumo
Falhas na inicialização parecem variadas, mas na verdade são quatro etapas: chave, banco de dados, escuta, migração. A linha onde o log para determina qual comando você deve executar; adivinhar não adianta — aquela frase "será que já existe outro n8n rodando" é feita justamente para enganar.
Três comandos são suficientes:ss -ltnp 'sport = :端口' Encontrar o ocupante,nc -vz host 端口 Verificar a conectividade,curl /healthz/readiness Verificar a prontidão. O resto é consultar a tabela deste artigo conforme o texto original do erro.
Uma última lição de experiência:n8n ready on 和 Editor is now accessible via O trecho entre eles é o que mais facilmente se assume como já resolvido. Reiniciar antes de a migração terminar, ou simplesmente cortar a energia, é o tipo de "pequena operação" de maior custo que já vi.
Continuando adiante
O artigo anterior é"O primeiro workflow: gatilho manual → editar campos → código", para montar um fluxo do zero consulte aquele artigo. Se ainda não instalou, veja"Como instalar o n8n", se a interface não é familiar, consulte"Tour pela interface". Registros esporádicos de falhas eu organizei emSolução de problemaspágina, o índice do curso completo está emaqui。
Materiais de referência
- Monitor n8n:
/healthzApenas verifica se o processo está ativo,/healthz/readinessRequer que o banco de dados esteja conectado e as migrações concluídas - Variáveis de ambiente do Deployment:
N8N_PORTPadrão 5678,N8N_LISTEN_ADDRESSPadrão::、N8N_USER_FOLDERda finalidade - Variáveis de ambiente do Database:
DB_TYPEPadrão sqlite,DB_POSTGRESDB_PORTPadrão 5432, e os parâmetros de recuperação automática em caso de desconexão durante a execução - Variáveis de ambiente do Logs:
N8N_LOG_OUTPUTconsole por defeito, após configurar para file os logs ficam em<n8n 目录>/logs/n8n.log - Use the command line:
n8n start、n8n export:workflowEstes comandos do lado do servidor, na sua maioria não requerem que o n8n esteja em execução - Install with Docker: o mapeamento de portas do comando run oficial e
/home/node/.n8n卷 - Install with npm: intervalo de versões do Node 20.19 a 24.x
- Node.js errors:
EADDRINUSE、ECONNREFUSED、EACCES、EADDRNOTAVAILas respetivas definições
Última atualização: 30 de outubro de 2026, com n8n 2.43.7.



