Как проверить ошибки запуска n8n и занятость портов


Если n8n на стороне сервера не запускается, это относится к довольно легко диагностируемым сбоям — он обязательно оставит одну строку с ошибкой. Сложность в том, что эта строка с ошибкой часто указывает не туда. Для этой статьи я запустил python http.server, чтобы занять port, и n8n всё равно сообщил мне «может быть, уже запущен другой n8n».
Ниже я делю сбои запуска на четыре категории по принципу «на какой строке остановился лог», и к каждой категории даю команду, которую можно сразу выполнить. Исходный текст ошибок — всё выведено на моей собственной машине с 2.43.7, ни одно слово не изменено.
Написано для тех, кто занимается self-hosting: подходит и для глобально установленного через npm, и для запущенного в Docker, и для управляемого через systemd. Тем, кто использует облачную версию, можно пропустить — там запуск не ваша забота. Есть только одно предварительное условие: вы можете войти в shell машины или можете смотреть логи container.
- Запуск — это конвейер из четырёх этапов; то, на каком этапе остановился лог, определяет, что проверять
- Port занят: три команды плюс одно вводящее в заблуждение сообщение
- Port не занят, но запуск всё равно не происходит: неверно указан адрес, недостаточно прав
- ECONNREFUSED — кто именно вас отклоняет
- Строка «SQLite package has not been found installed»
- В каталог .n8n невозможно записать
- Мой фактический порядок диагностики
- Как понять, что он действительно запустился
- Та фраза в интерфейсе «服务拒绝连接»
- Быстрый справочник по шести исходным строкам ошибок
- Три напоминания о безопасности
Запуск — это конвейер из четырёх этапов; то, на каком этапе остановился лог, определяет, что проверять
Сначала запомните, как выглядит нормальный запуск, иначе, увидев половину лога, вы вообще не поймёте, чего не хватает. Вот полный запуск на моей машине, начиная с пустого каталога:
No encryption key found - Auto-generating and saving to: /data/n8n/.n8n/config
Initializing n8n process
n8n ready on 127.0.0.1, port 5678
Migrations in progress, please do NOT stop the process.
Starting migration InitialMigration1588102412422
Finished migration InitialMigration1588102412422
Editor is now accessible via:
Строка «No encryption key found» появляется только при первом запуске, потом ключ уже записан в .n8n/config и больше не выводится. Ключ — это пара к базе данных: если сменить ключ, все учётные данные, хранящиеся в базе, не расшифруются, но это другая история; здесь достаточно запомнить, что это относится к первому этапу запуска.
Я разбил весь процесс на четыре блока, и у каждого блока форма ошибки при сбое совершенно разная:
| Порядок | Что происходит | Типичная ошибка при сбое этого этапа |
|---|---|---|
| 1 | Чтение конфигурационного файла, загрузка или генерация ключа шифрования | EACCES: permission denied, mkdir、Failed to load command "start" |
| 2 | Подключение к базе данных, встроено 5 повторных попыток | Initial database connection attempt N failed: connect ECONNREFUSED、SQLite package has not been found installed |
| 3 | Запуск HTTP-прослушивания | n8n's port 5678 is already in use、n8n webserver failed, exiting listen EADDRNOTAVAIL |
| 4 | Выполнение миграций базы данных, запуск task runner | Migrations in progress После этого больше ни одной строки Finished, процесс завершается |
Есть одна деталь, которую особенно легко неверно истолковать:n8n ready on 127.0.0.1, port 5678 не равно возможности использовать. Оно появляется в Migrations in progress Раньше порт уже был открыт, а база всё ещё обновлялась. В это время редактор не открывается — это нормально, подождите завершения миграции.
В четвёртом разделе есть ещё одна вещь, появившаяся только в 2.x: узел Code выполняется не в главном процессе, n8n запускает отдельный n8n task-runner. Это видно по отношениям родитель-потомок через ps.
# ps -o pid,ppid,etime,cmd -p 1053,7782
    PID    PPID   ELAPSED CMD
   1053       1  6-09:37:45 n8n start
   7782    1053  6-09:33:32 n8n task-runner
Главный процесс есть, runner отсутствует — главный интерфейс открывается, но при выполнении узла Code выдаёт ошибку. Увидев такой симптом, не думайте о коде, сначала ps проверьте, есть ли runner.
Порт занят: три команды и одно вводящее в заблуждение сообщение
Сначала посмотрите, что говорит сам n8n. При конфликте портов он не выдаёт стектрейс, а всего одну человеческую фразу, затем процесс завершается с кодом выхода 1:
n8n's port 5678 is already in use. Do you have another instance of n8n running already?Эта фраза переводит восемьдесят процентов внимания на «другой n8n». Реальность такова: порт может занимать что угодно. Я взял python3 -m http.server 5693 занял 5693, затем направил n8n на 5693 — он говорит ту же фразу. Гадать бесполезно, проверяйте.
# ss -ltnp 'sport = :5678'
State  Recv-Q Send-Q Local Address:Port Peer Address:Port Process
LISTEN 0      511        127.0.0.1:5678      0.0.0.0:*    users:(("n8n start",pid=1053,fd=24))
ss В Debian, Ubuntu, CentOS есть из коробки, вывод самый чистый и сразу даёт pid. Если не хотите запоминать синтаксис фильтрации,lsof тоже можно, только имя процесса будет с экранированием:
# lsof -i :5678 -sTCP:LISTEN
COMMAND    PID USER   FD   TYPE DEVICE SIZE/OFF NODE NAME
n8nx20st 1053 root   24u  IPv4  33852      0t0  TCP localhost:5678 (LISTEN)
n8nx20st это не кракозябры,x20 это пробел, настоящее имя — n8n start. В первый раз можно подумать, что это какая-то незнакомая программа, не пугайтесь. Если нужен только pid,fuser проще всего:
# fuser -n tcp 5678
5678/tcp:             1053
Получаем pid,ps -o pid,etime,cmd -p <pid> смотрим, сколько он работает. На этом шаге можно выделить две совершенно разные ситуации.
Одна — ваш старый процесс не завершился.Вы в systemd stop , или docker rm , процесс всё ещё висит в фоне. etime, показывающий несколько часов для n8n, — это почти наверняка он. Чистый способ — сначала systemctl stop n8n, затем kill, не kill -9сразу — если миграция будет жёстко убита на полпути, база данных может застрять в состоянии незавершённого обновления, и тогда спасти её можно только восстановлением из резервной копии.
Другая — порт занят другим сервисом.На облачном хосте порты вроде 8080, 3000 часто незаметно занимаются панелью управления или каким-нибудь мелким Node-сервисом. Здесь есть только два пути: заставить другого уступить или сменить порт самому.N8N_PORT=5679 Меняется за минуту, но не меняйте только в одном месте — порты, жёстко прописанные в reverse proxy,WEBHOOK_URL、N8N_EDITOR_BASE_URL , тоже ошибутся следом, и именно поэтому webhook перестаёт приниматься.
Есть ещё случай, который выглядит как конфликт портов, но на самом деле это проблема адреса прослушивания. У n8n N8N_LISTEN_ADDRESS значение по умолчанию — ::, dual-stack, охватывает и IPv4. Поэтому другие заняли только 127.0.0.1:5678, если запустить n8n со значениями по умолчанию, он всё равно не поднимется. Я проверял на практике: python слушал только 127.0.0.1:5694, n8n с адресом по умолчанию стартовал на 5694 и выдавал «port 5694 is already in use».
Кстати,:: включение всех сразу создаёт другую проблему: n8n напрямую открывается на всех сетевых интерфейсах, включая публичный. На моей машине сделано наоборот — слушается только localhost, а наружу отдаётся через nginx.
Environment=N8N_HOST=127.0.0.1
Environment=N8N_LISTEN_ADDRESS=127.0.0.1
Environment=N8N_PORT=5678
Environment=N8N_PROTOCOL=http
Порт свободен, но всё равно не стартует: неверный адрес, недостаточно прав
Порт свободен, почему всё равно не поднимается. Две самые частые причины, и ошибки выглядят совершенно по-разному.
Первая — адрес прослушивания не существует на данной машине. Сменился ЦОД, пересоздан инстанс, DHCP при продлении выдал другой IP — и старый IP в конфигурационном файле больше никому не принадлежит:
n8n webserver failed, exiting listen EADDRNOTAVAIL: address not available 10.9.9.9:5679Это я получил, записав N8N_LISTEN_ADDRESS как 10.9.9.9 — на сетевом интерфейсе той машины такого адреса нет. Если видите EADDRNOTAVAIL не проверяйте порт, а идите в ip addr смотреть, какие IP реально есть на машине, или просто напишите 127.0.0.1。
Вторая — права. Порты меньше 1024 требуют root или CAP_NET_BIND_SERVICE этой capability. Эта ошибка выбрасывается Node, а не обёрткой n8n, поэтому сопровождается стеком node:events :
node:events:505
    throw er; // Unhandled 'error' event
    ^
Error: listen EACCES: permission denied 0.0.0.0:80
    at Server.setupListenHandle [as _listen2] (node:net:2306:21)
Я не рекомендую ради простоты запускать n8n на 80. Обратный прокси даёт слишком многое: продление сертификатов, gzip, rate limiting, ip whitelist — всё это проще, чем собственные средства n8n, а для изменения конфигурации не нужно перезапускать n8n. Если уж обязательно использовать 80 напрямую, то давайте права как положено. У меня самого всё работает под root, ради простоты; на машине с несколькими пользователями я так делать не советую — в n8n хранятся учётные данные всех ваших сторонних сервисов, и при расширении прав процесса расширяется и то, что можно унести.
Кто именно отклоняет соединение при ECONNREFUSED
Это сообщение об ошибке на самом деле выдаётся n8n на втором этапе запуска: он подключается к базе данных, на порту назначения никто не отвечает, и ядро сразу возвращает RST. n8n повторяет попытки 5 раз с интервалами 1 с, 2 с, 4 с, 8 с, 16 с — всего около 31 секунды, после чего сдаётся и завершается.
Initial database connection attempt 1 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 1000ms
Initial database connection attempt 2 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 2000ms
Initial database connection attempt 3 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 4000ms
Initial database connection attempt 4 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 8000ms
Initial database connection attempt 5 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 16000ms
There was an error initializing DB
There was an error initializing DB
Error: There was an error initializing DB
    at Start.exitWithCrash (/usr/lib/node_modules/n8n/src/commands/base-command.ts:361:28)
Приведённый выше фрагмент я получил, изменив DB_TYPE на postgresdb и намеренно указав порт 5433, который никто не слушает; скопировано дословно.There was an error initializing DB Два запуска подряд — это тоже правда, я не ошибся при копировании; увидев повторяющиеся строки, не сомневайтесь в себе.
К повторным попыткам нужно относиться правильно: это повторные попытки «подключения к базе при запуске», а не «бесконечное ожидание». Увидев attempt 1, не спешите перезапускать — подождите 31 секунду; если увидели 5 неудач подряд, значит соединения действительно нет, и сто перезапусков ничего не изменят.
Порт в адресе — единственная полезная подсказка.DB_POSTGRESDB_PORT По умолчанию 5432; если в ошибке 5433, значит вы сами настраивали — скорее всего, скопировали конфиг и забыли изменить; если в ошибке 127.0.0.1:5432 но вы явно установили базу на другой машине — значит переменные окружения не применились: в systemd Environment= одна ошибочная строка, в Docker -e одного не хватает — и будет именно так.
Самый коварный случай — в контейнере. n8n работает в контейнере, в конфиге указано DB_POSTGRESDB_HOST=127.0.0.1, и этот 127.0.0.1 — это loopback самого контейнера, а не хоста. База работает на хосте, и из контейнера подключиться никак не получится — ошибка всё та же ECONNREFUSED, выглядит точно так же, как «база не запущена». Либо поместите базу тоже в compose и используйте имя сервиса как host; либо заставьте контейнер обращаться к адресу хоста.
Проверить связность снаружи гораздо быстрее, чем гадать по логам n8n:
# nc -vz 127.0.0.1 5678
Connection to 127.0.0.1 5678 port [tcp/*] succeeded!
# nc -vz 127.0.0.1 5433
nc: connect to 127.0.0.1 port 5433 (tcp) failed: Connection refused
Если nc проходит, а n8n всё равно не подключается — проблема в учётных данных и имени базы; смотрите дальше логи самого postgres, не крутитесь вокруг n8n.
Строка «SQLite package has not been found installed»
Это самая часто неверно понимаемая ошибка во второй части запуска, я сам на ней спотыкался. Она появляется в сценарии SQLite по умолчанию — то есть у подавляющего большинства людей при первой установке n8n. Лог выглядит так:
Initial database connection attempt 1 failed: SQLite package has not been found installed. Try to install it: npm install sqlite3 --save. Retrying in 1000ms
Initial database connection attempt 2 failed: SQLite package has not been found installed. ...
...
Error: There was an error initializing DB
DriverPackageNotInstalledError: SQLite package has not been found installed. Try to install it: npm install sqlite3 --save.
    at SqliteLibrary.loadLibrary (/usr/lib/node_modules/n8n/node_modules/@n8n/typeorm/dist/driver/sqlite-pooled/SqliteLibrary.js:30:19)
Легко увлечься последним блоком стека и решить, что «инициализация DB не удалась» означает поломку базы данных. На самом деле первая строка всё объясняет:sqlite3 Этого нативного модуля нет. При установке n8n через npm попутно компилируется нативный модуль; неполное окружение компиляции, обновление Node на мажорную версию, добавление при установке пакета --ignore-scripts— всё это приводит к его отсутствию. Этот фрагмент лога находится между двумя записями успешного запуска на моей машине; тогда я не записал, какой именно шаг это исправил, знаю только, что к самой базе данных это отношения не имеет.
Есть три пути исправления, от меньших затрат к большим: установить окружение компиляции (python3、make、g++) и переустановить n8n; либо включить N8N_REINSTALL_MISSING_PACKAGES=true, чтобы он сам доустановил недостающие пакеты при запуске — прописать в Dockerfile или systemd, неважно; если возиться не хочется — перейти на Docker image, где эти нативные модули уже скомпилированы. Фраза npm install sqlite3 --save в ошибке предназначена для сценария «n8n установлен как локальная зависимость»; при глобальной установке копировать её не обязательно сработает.
Заодно зафиксирую требования к версии: n8n требует Node от 20.19 до 24.x; вне этого диапазона Node будут возникать разнообразные странные проблемы с нативными модулями. У меня на этой машине 24.21.0.
В каталог .n8n нельзя записать
Сбой в первой части запуска, в ошибке присутствует EACCES 和 mkdir, что означает, что он не может даже создать свой каталог данных..n8n В каталоге хранятся файлы базы данных, ключи шифрования, конфигурация; если каталог недоступен для записи — запуск полностью невозможен:
No encryption key found - Auto-generating and saving to: /root/n8n_noperm/.n8n/config
Error: Failed to load command "start"
Error: EACCES: permission denied, mkdir '/root/n8n_noperm/.n8n'
    at mkdirSync (node:fs:1410:26)
    at InstanceSettings.loadOrCreate (/usr/lib/node_modules/n8n/node_modules/n8n-core/src/instance-settings/instance-settings.ts:353:12)
В этом фрагменте есть коварный момент:Сначала он печатает «нет ключа, генерирую и сохраняю в такой-то путь», и только потом падает. Если смотреть только на эту строку, можно подумать, что всё прошло успешно, хотя на самом деле ничего не записано. Критерий один — есть ли после неё Editor is now accessible via, если нет — значит, не запустилось.
Этот фрагмент я получил, запуская от пользователя nobody, когда целевой каталог находится в /root , куда никто не может писать. В реальной эксплуатации чаще встречается Docker: n8n в контейнере работает от пользователя node с uid 1000, и если на хосте каталог, который вы mkdir , принадлежит root с правами 700, то при mount получится именно эта ошибка. Исправление — изменить владельца каталога на хосте, а не выставлять максимальные права:
chown -R 1000:1000 /srv/n8n-datachmod 777 это позволит ему запуститься, но я не рекомендую. В том каталоге есть файл с ключом шифрования, и любой пользователь на той же машине сможет его прочитать — это всё равно что повесить ключ от всех сторонних учётных данных в базе на дверную ручку.
Мой фактический порядок диагностики
Когда возникает проблема, не начинайте читать лог с первой строки — идите в таком порядке, и за пять минут локализуете сегмент:
- Посмотрите статус сервиса.
systemctl status n8nИлиdocker ps -a. Важно не active или failed, аRestartколичество иRestarting (1) 3 seconds agoтакой цикл. Цикл означает, что он снова и снова запускается и снова и снова умирает — смотрите логи, не мучайте systemd. - Найдите логи.Сначала попробуйте
journalctl -u n8n -n 50. На этой машине возвращается-- No entries --, потому что в unit вывод перенаправлен в файл:StandardOutput=append:/data/logs/n8n.out.log. В таком случае простоtail -100 /data/logs/n8n.out.log. Docker — этоdocker logs --tail 100 n8n。 - посчитайте, сколько раз перезапускался.
grep -c 'n8n ready on' /data/logs/n8n.out.log, на этой машине 30. Лог пишется в режиме добавления, вся история сохраняется, если одна и та же ошибка повторяется — это циклический запуск. - Проверьте port.
ss -ltnp 'sport = :5678', сверьтесь с вышеприведённым списком. - Проверьте health.
curl -s http://127.0.0.1:5678/healthz. Если процесс жив, вернётся{"status":"ok"}, это не смотрит в базу данных.
Из шага 2 journalctl возвращает пусто, легко ошибочно решить, что сервис вообще не пишет лог. Сервисом управляет systemd, а лог лежит в файле. Поэтому сначала systemctl cat n8n проверьте, нет ли перенаправления — это быстрее, чем вслепую рыться в логах.
В Docker там на два шага больше:docker ps -a в столбце STATUS будет написано Restarting (1) 3 seconds ago, если число в скобках постоянно растёт — это повторные запуски; если порты не совпадают, сначала смотрите docker port n8n, он покажет порты хоста и порты container. У меня это установлено через npm, оригинальный текст ошибки внутри container я сам не вводил, эти пункты написаны по типичному поведению docker.
Как понять, что он действительно поднялся
Порт слушается — это ещё не значит, что он может работать. У n8n есть две готовые проверочные endpoint-точки, разница между ними очень практична:
# curl -s -o /dev/null -w '%{http_code}n' http://127.0.0.1:5678/healthz
200
# curl -s http://127.0.0.1:5678/healthz
{"status":"ok"}
# curl -s -o /dev/null -w '%{http_code}n' http://127.0.0.1:5678/healthz/readiness
200
/healthz 200 означает только, что процесс отвечает, он не смотрит на базу данных./healthz/readiness — это уже «база данных подключена, миграции тоже выполнены». В течение нескольких десятков секунд после перезапуска первый может уже быть 200, а второй ещё не догнал — значит, миграции ещё идут. Когда пишете скрипт мониторинга, используйте readiness, а не healthz — только первый отражает «может ли эта машина принимать трафик».
После того как оба дают 200, прогоните реальную работу:
- откройте редактор, войдите, увидьте список workflow — не белый экран с крутящимся индикатором.
- запустите любой workflow с узлом Code, успешно. Этот шаг проверяет task runner, о котором говорилось выше, что его часто игнорируют.
- опубликуйте (publish) workflow, дайте ему реально выполниться один раз, в записи выполнения должно быть видно это production-выполнение со статусом успеха.
Третий пункт не пропускайте. У некоторых развёртываний редактор работает нормально, но в нужное время не выполняется — причина в том, что worker в режиме очереди не подключён, такие проблемы выявляются только реальным запуском.
Та фраза в интерфейсе «сервис отказал в соединении»
При неудачном запуске вы вообще не попадёте в интерфейс, поэтому этот раздел о другом — n8n поднялся, а то, что подключено в workflow, не поднялось. Направления диагностики этих двух типов сбоев полностью противоположны, не смешивайте.
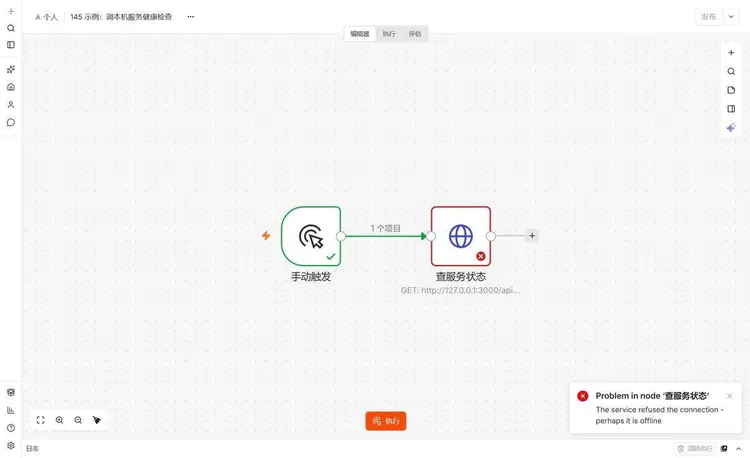
После одного неудачного запуска узел на холсте красный, в правом нижнем углу всплывает Problem in node '查服务状态', строкой ниже мелкий текст The service refused the connection - perhaps it is offline. Эта фраза — переведённый n8n человеческий язык, здесь нет ни порта, ни протокола.
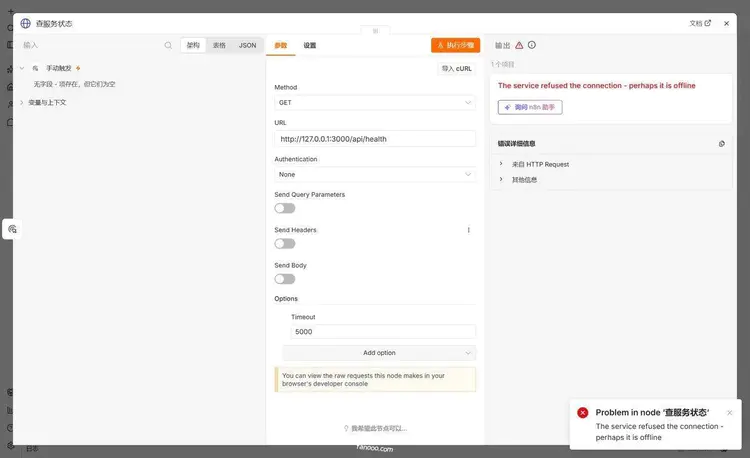
Дважды щёлкните узел, в панели вывода справа прокрутите вниз, там есть сворачиваемый раздел «Подробности ошибки», только раскрыв его увидите исходную информацию.
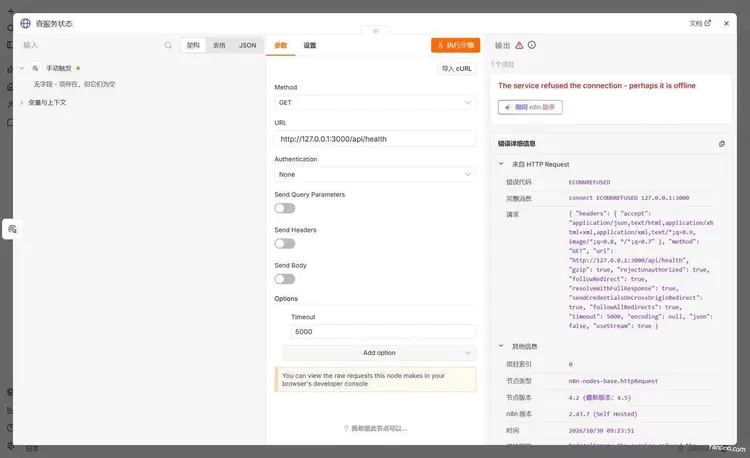
Строка «Код ошибки» — это ECONNREFUSED, «Полное сообщение» — это connect ECONNREFUSED 127.0.0.1:3000. Здесь всё сходится с той ошибкой при запуске, тот же код ошибки, только на этот раз в узле. Взять этот порт и nc -vz, сразу станет ясно, проходит соединение или нет.
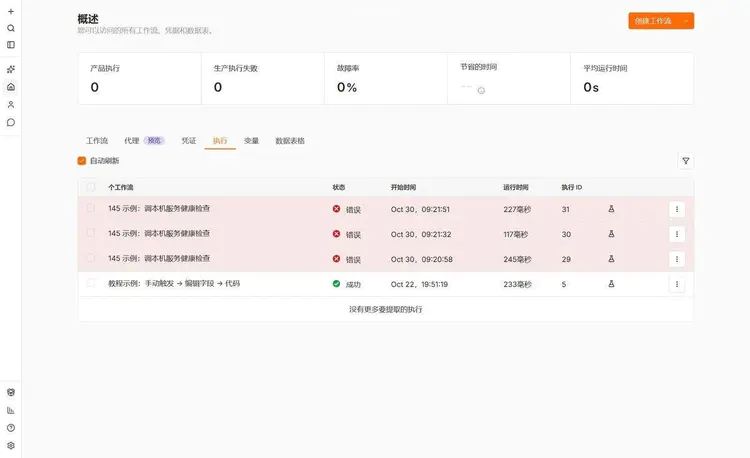
В записях выполнения есть ещё один бесплатный критерий: время выполнения. У меня эти три раза составили 227, 117, 245 миллисекунд. Так быстро бывает только когда даже TCP-рукопожатие не состоялось; если удалённая сторона подключилась, но вернула 500, или произошёл таймаут, затраченное время будет от нескольких сотен миллисекунд до нескольких секунд, вплоть до установленного вами timeout. Ошибка в пределах двухсот миллисекунд — сразу думайте в сторону «порт/адрес/сервис не запущен», думать в сторону «интерфейс вернул неверное содержимое» — пустая трата времени.
Быстрый справочник по шести исходным текстам ошибок
| Исходный текст ошибки | Где застряло | Направление обработки |
|---|---|---|
n8n's port 5678 is already in use... |
Третий абзац, port | ss -ltnp 'sport = :5678' Найти pid, остановить старый или сменить port |
n8n webserver failed, exiting listen EADDRNOTAVAIL |
Третий абзац, адрес | IP в конфигурации на этой машине отсутствует,ip addr Сверить |
Error: listen EACCES: permission denied 0.0.0.0:80 |
Третий абзац, права | Порты ниже 1024 требуют привилегий, сменить port или добавить capabilities |
Initial database connection attempt N failed: connect ECONNREFUSED |
Второй абзац, база данных | Дождаться 5 попыток повтора, затем nc -vz host port |
DriverPackageNotInstalledError: SQLite package has not been found installed |
Второй абзац, зависимости | 补 sqlite3, или переустановить n8n |
EACCES: permission denied, mkdir '/.../.n8n' |
Первый абзац, каталог | Владелец каталога данных неверный, изменить owner, не 777 |
Три напоминания по безопасности
Временно ослабленный прослушиваемый адрес в период диагностики не забудьте вернуть обратно.Чтобы снаружи взглянуть, поднялось ли оно, измените N8N_LISTEN_ADDRESS на 0.0.0.0 или добавьте строку -p 5678:5678, посмотрели и забыли. Редактор n8n в публичной сети — это просто форма входа, скрипт перебора за день может попробовать тысячи раз. У меня этот экземпляр слушает только 127.0.0.1, публичный доступ идёт через nginx 443, это штатное состояние, не меняйте на временное ради устранения неполадок и не оставляйте так.
Перед публикацией логов просмотрите их.В логах запуска есть полный webhook URL, а путь webhook сам по себе является учётными данными: получив путь, можно заливать данные в ваш workflow; в стеке есть пути установки, внутренние адреса, имена хостов базы данных. Прежде чем публиковать в чате или просить помощи на форуме, замените это, а потом публикуйте.
Пароль базы данных не пишите в командной строке.docker run -e DB_POSTGRESDB_PASSWORD=xxx Он останется в shell history, а также появится в docker inspect выводе, и любой на той же машине, кто может выполнять команды docker, его увидит. Используйте --env-file, или systemd EnvironmentFile=, права на файл 600. Ранее опубликованный unit написан именно так, пароль в /etc/n8n/instance-ai.env , а не в unit.
Краткое резюме
Сбой запуска выглядит по-разному, но на самом деле состоит из четырёх этапов: ключи, база данных, прослушивание, миграция. На какой строке остановился лог — это определяет, какую команду вам нужно ввести, гадать бесполезно — фраза «может, уже запущен другой n8n» специально вводит в заблуждение.
Трёх команд достаточно:ss -ltnp 'sport = :端口' найти занимающего,nc -vz host 端口 проверить связность,curl /healthz/readiness проверить готовность. Остальное — сверка с таблицей в этой статье по исходному тексту ошибки.
Последний совет из опыта:n8n ready on 和 Editor is now accessible via промежуток между ними — самое частое место, которое принимают за уже готовое. Перезапуск до завершения миграции или прямое отключение питания — самый дорогостоящий «пустяк» из тех, что я видел.
Далее
Предыдущая статья —«Первый workflow: ручной запуск → редактирование полей → код», с нуля собрать процесс можно посмотреть там. Кто ещё не установил — смотрите«Как установить n8n», интерфейс незнаком — откройте«Обзор интерфейса». Разрозненные записи о сбоях я собрал вУстранение неполадокстраница, оглавление всего курса находится вздесь。
Справочные материалы
- Monitor n8n:
/healthzПроверяется только живость процесса,/healthz/readinessтребуется, чтобы база данных была подключена и миграции завершены - Переменные окружения Deployment:
N8N_PORTпо умолчанию 5678,N8N_LISTEN_ADDRESSпо умолчанию::、N8N_USER_FOLDERназначение - Переменные окружения Database:
DB_TYPEпо умолчанию sqlite,DB_POSTGRESDB_PORTпо умолчанию 5432, а также параметры автоматического восстановления при обрыве соединения во время работы - Переменные окружения Logs:
N8N_LOG_OUTPUTПо умолчанию console, после настройки на file логи попадают в<n8n 目录>/logs/n8n.log - Используйте командную строку:
n8n start、n8n export:workflowЭти серверные команды, большинству из них не требуется, чтобы n8n был запущен - Установка с помощью Docker: сопоставление портов официальной команды run и
/home/node/.n8n卷 - Установка с помощью npm: диапазон версий Node от 20.19 до 24.x
- Ошибки Node.js:
EADDRINUSE、ECONNREFUSED、EACCES、EADDRNOTAVAILих соответствующие определения
Последнее обновление: 30 октября 2026 г., использовалась версия n8n 2.43.7.



