Что такое n8n? Введение с нуля, сценарии применения и путь обучения


Если вы поищете в интернете «что такое n8n», то скорее всего увидите такой ответ: инструмент с открытым исходным кодом для автоматизации рабочих процессов, который может связывать разные приложения. Это утверждение не ошибочно, но по сути ничего не говорит — оно не объясняет, за кого именно этот инструмент выполняет работу и какое время он вам экономит.
Проще говоря: n8n — это инструмент, который превращает то, что вы снова и снова делаете вручную, в конвейер, способный работать самостоятельно.
Это первая статья из целого курса, и у неё одна цель: чтобы до начала практики вы чётко поняли, что это такое, что оно умеет и стоит ли это изучать. После прочтения вы должны суметь ответить на один вопрос — какое из моих дел подходит для передачи ему.
Кому подходит, что нужно подготовить перед просмотром
Смотреть можно даже без всякого опыта автоматизации. Не нужно уметь программировать, не нужно покупать сервер и даже не нужно сначала устанавливать программное обеспечение. В этой статье только концепции и критерии оценки, практическая часть — в следующей.
Если вы уже пользовались Zapier или писали скрипты, обратите особое внимание на разделы 3 и 4: там разобраны их фактические различия, это поможет вам решить, стоит ли переходить.
Сначала посмотрим, как это выглядит в работе
Сколько бы ни объяснять концепции, лучше один раз увидеть. На рисунке ниже — мой первый учебный рабочий процесс на одном сервере: три блока, один прогон слева направо, заняло 233 миллисекунды.
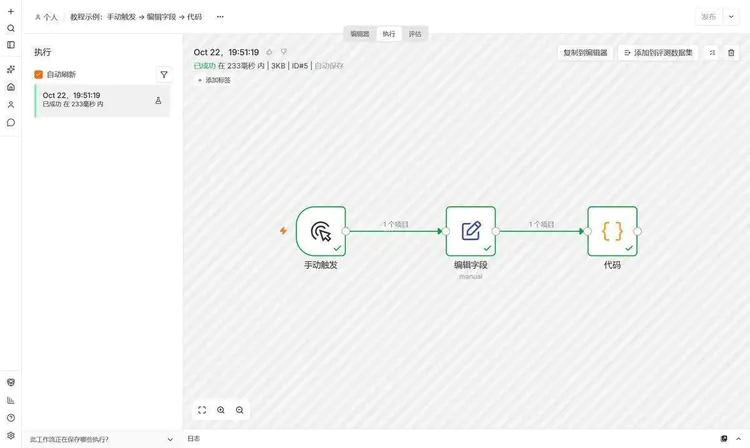
Три блока на рисунке называютсяузлами. Крайний слева со значком молнии — это начальная точка, называется триггером и означает «откуда начинается это событие»; средний называется «редактировать поля» и отвечает за создание двух полей; крайний справа — узел кода, в нём выполняется небольшой фрагмент JavaScript.
Стрелки между блоками — это направление потока данных. Вся эта цепочка от начальной точки до конечной называетсярабочим процессом。
Этот конвейер делает очень глупую работу: создаёт два значения «Фучжоу» и «27» и склеивает их в одно предложение. Но если заменить это на реальный бизнес, речь идёт о том, чтобы передать машине цепочку действий «открыть веб-страницу, скопировать данные, вставить в таблицу, отправить письмо». Структура та же самая.
Достаточно трёх слов: узел, связь, рабочий процесс
- Узел (Node): конкретное действие. Отправить HTTP-запрос, прочитать строку таблицы, проверить условие, выполнить фрагмент кода — всё это узел. В списке узлов моего экземпляра можно пролистать почти тысячу штук, охватывающих различные распространённые системы.
- Связь: определяет, что за чем идёт. Данные движутся по линиям вниз, могут разветвляться и объединяться.
- Рабочий процесс (Workflow): узлы плюс связи образуют полный процесс выполнения одной задачи. Именно это и есть «продукт», который вы создаёте в n8n.
Настоящий барьер не в этих трёх терминах, а в одном понятии:как данные передаются между узлами。
Данные в n8n всегда представляют собой «массив элементов». Если предыдущий узел вернул 10 строк данных, в следующий узел передаётся 10 элементов, и следующий узел выполняется для каждого из этих 10 элементов по отдельности, а не только для первой строки. Осознав это, вы сможете самостоятельно разобраться с большинством последующих вопросов вроде «почему мой вывод пустой».
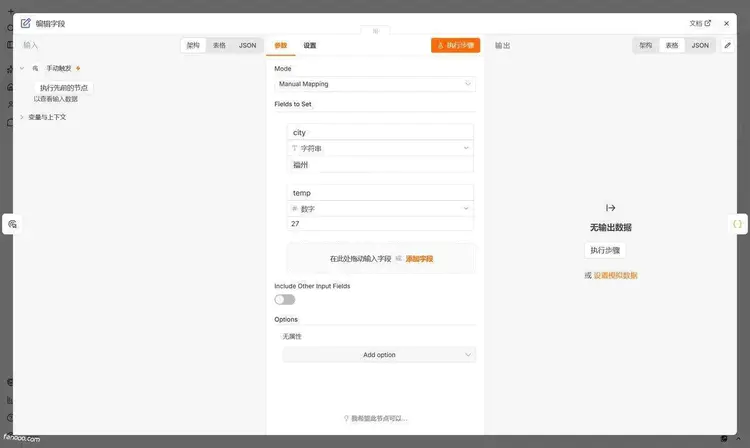
Эта панель была изменена в n8n 2.x. Слева вход, в центре параметры, справа выход — при отладке не нужно переключаться между вкладками, что гораздо удобнее, чем в 1.x. При этом множество китайских руководств в сети всё ещё описывают интерфейс 1.x, и при следовании им расположение элементов не совпадёт — это одно из самых частых мест, где новички теряются.
Ещё одна деталь: на моём экземпляре установлен упрощённый китайский, но вы заметите, что названия параметров по-прежнему на английском — Mode, Fields to Set, Include Other Input Fields и так далее. В n8n переведена только оболочка, параметры узлов не переведены; не пугайтесь английского, просто заполняйте по аналогии.
Какую задачу это на самом деле решает
Большая часть повторяющегося труда в офисе по сути сводится к одному и тому же:Перенести данные из A в B и заодно изменить их вид.
Например. Клиент заполняет форму на сайте → вы переносите информацию в таблицу → отправляете сообщение менеджеру по продажам → через три дня напоминаете ему связаться ещё раз. Четыре шага, каждый несложен, но делать это двадцать раз в день утомительно, и что-то обязательно будет упущено.
Именно этим и занимается n8n: вовремя, по условию, без ошибок доставляет данные туда, куда нужно, и попутно уведомляет тех, кому следует знать.
Это позиционирование нужно запомнить твёрдо. Он не производит данные и не принимает за вас решения. Уяснив это, вы не станете ожидать от него «проанализируй-ка мне продажи за этот месяц» — такую работу он выполнить не может, для этого нужны база данных и скрипты.
В чём разница по сравнению с Zapier, Make и собственными скриптами
| n8n | Zapier | Make | Собственные скрипты | |
|---|---|---|---|---|
| Способ развёртывания | Облачная версия или self-hosted | Только облако | Только облако | Решаете сами |
| Логика тарификации | Self-hosting не оплачивается по каждому запуску | По количеству задач | По количеству операций | Считается только сервер |
| Степень свободы | Высокая, можно писать код | 中 | Относительно высокая | Максимальная |
| Сложность освоения | 中 | Самая простая | Относительно крутая | Зависит от человека |
| Кто отвечает за обслуживание | Сам | Платформа | Платформа | Самостоятельно |
Скажу о реальных ощущениях. Zapier — самый простой: зарегистрировался и пользуйся, но платишь за количество задач, и при росте объёма счёт становится неприятным, а при чуть более сложной обработке данных приходится искать обходные пути. У Make визуализация сильнее — можно строить настоящие ветвления и циклы, и цена умеренная, но порог освоения интерфейса выше.
Отличие n8n в двух моментах: можно развернуть самостоятельно, данные остаются на своей машине; плата не за количество задач — сколько бы раз ни запускал, дополнительно платить не нужно, затраты сводятся к серверу. Цена тоже вполне реальная — обновления, резервное копирование, ночные сбои — всё это ты разгребаешь сам. Это не мелочь, об эксплуатации будет отдельный разговор.
Что касается собственных скриптов на Python: они гибче, но интерфейса нет — поменять условие значит менять код, а при проблеме нет журнала выполнения, чтобы посмотреть. У меня разделение такое — разовую обработку данных со сложной логикой пишу скриптами; то, что должно долго работать по расписанию, показывать прогресс людям и стыковаться с несколькими внешними системами, кладу в n8n.
Заодно про лицензию n8n. Это не стандартная открытая лицензия, а Sustainable Use License из семейства fair-code. Для себя и внутри компании — без проблем; но если хочешь обернуть n8n и продать клиенту, сначала внимательно прочитай условия, не полагайся на догадки.
Что стоит ему поручать, а что — нет
Подходящие случаи выглядят примерно так:
- Регулярная сводка: каждое утро собирать информацию из нескольких источников, убирать дубликаты и формировать утреннюю сводку
- Триггеры по событиям: кто-то отправил форму, прислал письмо, изменился статус заказа — автоматическая классификация, запись в базу, уведомление
- Синхронизация систем: сверка между таблицами, базами данных, CRM, расхождения выносятся отдельно
- Контентный конвейер: сбор, очистка, переписывание через AI, ручная проверка, публикация по расписанию
- Мониторинг и оповещения: сайт упал, интерфейс выдал ошибку, данные аномальны — чтобы об этом узнали сразу
- Задачи, связанные с AI: подключение больших моделей в бизнес-процессы для классификации, извлечения, вопросов-ответов
Про неподходящие тоже надо сказать чётко, чтобы ты не набил шишек:
- Высокочастотная торговля в реальном времени с миллисекундной задержкой — он для этого не предназначен
- Сложные вычисления и алгоритмы — проще напрямую писать код
- Процесс, который запускается раз в месяц и занимает десять минут вручную, в виде workflow поддерживать сложнее
Как n8n связан с AI
В последние два года n8n популярен во многом благодаря AI. В нём есть встроенные узлы для подключения больших моделей, а также целый набор узлов для создания Agent: наделить модель инструментами, памятью и позволить ей самой решать, что вызывать первым.
Но нужно соблюдать меру. Workflow детерминирован: условие выполнено — идём налево, не выполнено — направо, сто запусков дают одинаковый результат. С моделью не так: при одном и том же промпте сегодня классификация верная, а завтра может ошибиться.
Мой принцип: детерминированные задачи отдавать узлам, нечёткие — модели, а всё, что связано с деньгами и обязательствами, обязательно оставлять на ручную проверку. Этот принцип будет проходить через все последующие статьи об AI.
Сколько это стоит
Два пути, структура затрат совершенно разная.
Официальная облачная версия: помесячная оплата, не нужно устанавливать и обслуживать, цена — по официальному сайту (она меняется, я не фиксирую цифры). Самостоятельное развёртывание: само ПО бесплатно, затраты — это сервер, 2 ядра и 4 ГБ для повседневных задач более чем достаточно, машины за несколько сотен юаней в год хватит. По-настоящему дорого обходится время — установка, настройка, обновление, устранение неполадок — всё своими руками.
Облако или self-hosted — как определиться
Критерий на самом деле только один:Могут ли эти данные покинуть вашу машину.
Для данных вроде списков клиентов, заказов, медицинских карт рекомендуется self-hosted. Если подключаетесь только к публичной информации и делаете напоминания по RSS, облако проще. У self-hosted есть две специфические для Китая проблемы: сервер может не иметь доступа к зарубежным API — нужно отдельно решать вопрос с сетью; и наоборот, облачная версия не может попасть во внутренние системы вашей компании. Это гораздо важнее цены — не ждите, пока всё сделаете, чтобы обнаружить, что данные не получить.
Какая база нужна для его изучения
Если умеете копировать и вставлять, понимаете таблицы — можно начинать; на первом этапе писать код вообще не нужно.
Но ближе к середине вы упрётесь в две стены: первая — JSON, как выглядят данные и как извлечь из них один уровень; вторая — HTTP, что означают запрос, ответ и коды состояния. Досконально знать их не обязательно, но обойти их нельзя. Дальше, при работе с AI и Agent, потребуется умение читать сообщения об ошибках и самостоятельно определять, проблема в данных или в конфигурации.
От нуля до рабочего состояния: как пройти путь
Я разбил весь процесс на 8 этапов, у каждого есть чёткий результат, записанный намаршрут обучениятой странице. Здесь дам только три напоминания о порядке:
- Сначала стабильно установите n8n, потом делайте workflow. Если volume для данных не настроен, при удалении container все workflow пропадут — такое я видел не раз.
- Сначала прогоните один небольшой процесс под рукой, потом изучайте новые nodes. Если только читать документацию и ничего не производить, через неделю всё забудется.
- Не спешите с AI. Если поток данных и обработка ошибок не поняты, подключение модели только сделает проблемы труднее для диагностики.
Четыре места, где новички чаще всего сбиваются
Погоня за новыми nodes.В библиотеке nodes почти тысяча, всё ненужное — шум. Реально высокочастотных всего около двадцати: trigger, HTTP, edit fields, IF, Switch, Merge, loop, code.
Прогон только успешного пути.Интерфейс может отваливаться по таймауту, ограничивать частоту, возвращать 500. Те, кто впервые попал в production и обжёгся, почти все попались именно на этом.
Не смотреть на историю выполнений.При ошибке сначала смотрите первый покрасневший узел в истории выполнений — это гораздо быстрее, чем спрашивать людей в чате.
Рассматривайте n8n как low-code платформу.Он умеет писать код, но его сильная сторона — координация, а не вычисления. Тяжёлую работу отдавайте скриптам или базе данных.
Напоминание о безопасности
Самостоятельно размещённый n8n — это по сути ключи от целого ряда ваших систем на этой машине. Три вещи обязательны: привяжите домен и включите HTTPS, не оставляйте port 5678 открытым в публичной сети; для API Key, используемого n8n, выдавайте только необходимые права; при резервном копировании не забудьте ключ шифрования n8n — если ключ потерян, учётные данные в базе данных не расшифровать, и одних данных для восстановления недостаточно.
Краткое итого
n8n — это инструмент, превращающий повторяющиеся операции в конвейер. Его ценность не в количестве узлов, а в том, что после того как вы записали «как это должно делаться», он каждый день делает это по записанному, не забывая и не пропуская.
Порядок обучения укладывается в три фразы: стабильно установить, запустить одно, затем расширять дальше.
В следующей статье расскажу, как конкретно устанавливать:Как установить n8n: полное руководство по локальному развёртыванию и первому запуску для новичков. После установки вернитесь и прогоните ещё раз тот workflow из трёх узлов выше — будет гораздо глаже.
Справочные материалы
- Официальная документация n8n
- Список узлов интеграции
- Описание самостоятельного размещения
- Официальная страница с ценами
Последнее обновление: 22 октября 2026 г., использовалась n8n 2.43.7. Если у вас версия новее, интерфейс может быть снова перемещён.



