n8n 启动报错与端口占用怎么查


服务端的 n8n 起不来,算是好查的一类故障——它一定会给你留一行报错。麻烦在于那行报错经常指错方向。为了写这篇,我拿 python 起了个 http.server 去占端口,n8n 照样告诉我「是不是已经有另一个 n8n 在跑了」。
下面按「日志停在哪一行」把启动失败分成四类,每类配一条能立刻敲的命令。报错原文都是我自己那台 2.43.7 上打出来的,一个字没改。
写给自托管的人:npm 全局装的、Docker 跑的、systemd 管的都算。用云版的跳过,那边的启动轮不到你操心。前置条件只有一条,你能登进机器的 shell,或者能看容器日志。
- 启动是四段流水,日志停在哪一段决定查什么
- 端口被占:三个命令,加一句会骗人的提示
- 端口没被占也起不来:地址写错、权限不够
- ECONNREFUSED 到底谁在拒绝你
- 「SQLite package has not been found installed」那条
- .n8n 目录写不进去
- 我实际的排查顺序
- 怎么算真的起来了
- 界面里那句「服务拒绝连接」
- 六条报错原文速查
- 三条安全提醒
启动是四段流水,日志停在哪一段决定查什么
先记住一次正常启动长什么样,否则看见半截日志根本不知道缺了哪块。这是我那台机器上的一次完整启动,从空目录开始:
No encryption key found - Auto-generating and saving to: /data/n8n/.n8n/config
Initializing n8n process
n8n ready on 127.0.0.1, port 5678
Migrations in progress, please do NOT stop the process.
Starting migration InitialMigration1588102412422
Finished migration InitialMigration1588102412422
Editor is now accessible via:
「No encryption key found」那行只在首次启动时出现,之后密钥已经写在 .n8n/config 里,不再打。密钥这东西和数据库是一对,换了密钥,库里存的凭据全部解不开,那是另一篇的事,这里只要记住它属于启动第一段。
我把整段流程拆成四块,每块失败的报错形态完全不同:
| 顺序 | 在干什么 | 这一段挂了的典型报错 |
|---|---|---|
| 1 | 读配置文件、加载或生成加密密钥 | EACCES: permission denied, mkdir、Failed to load command "start" |
| 2 | 连数据库,自带 5 次重试 | Initial database connection attempt N failed: connect ECONNREFUSED、SQLite package has not been found installed |
| 3 | 起 HTTP 监听 | n8n's port 5678 is already in use、n8n webserver failed, exiting listen EADDRNOTAVAIL |
| 4 | 跑数据库迁移、拉起 task runner | Migrations in progress 之后再没有一行 Finished,进程就没了 |
有个细节特别容易误判:n8n ready on 127.0.0.1, port 5678 不等于能用。它出现在 Migrations in progress 之前,端口已经开了,库还在升级。这时候刷编辑器打不开是正常的,等迁移跑完再说。
第四段里还有个 2.x 才有的东西:Code 节点不在主进程里跑,n8n 会另起一个 n8n task-runner。用 ps 看父子关系能看出来。
# ps -o pid,ppid,etime,cmd -p 1053,7782
    PID    PPID   ELAPSED CMD
   1053       1  6-09:37:45 n8n start
   7782    1053  6-09:33:32 n8n task-runner
主进程在、runner 不在,主界面能打开,一执行 Code 节点就报错。碰见这种症状别往代码上想,先 ps 看 runner 在不在。
端口被占:三个命令,加一句会骗人的提示
先看 n8n 自己怎么说。它撞端口时不会甩一串堆栈,就一句人话,然后进程退掉,退出码 1:
n8n's port 5678 is already in use. Do you have another instance of n8n running already?这句话把八成的注意力引到「另一个 n8n」上。真实情况是:占着端口的可能是任何东西。我拿 python3 -m http.server 5693 占了 5693,再把 n8n 指到 5693,它说的还是这一句。猜没用,查。
# ss -ltnp 'sport = :5678'
State  Recv-Q Send-Q Local Address:Port Peer Address:Port Process
LISTEN 0      511        127.0.0.1:5678      0.0.0.0:*    users:(("n8n start",pid=1053,fd=24))
ss 在 Debian、Ubuntu、CentOS 上都自带,输出最干净,还直接给 pid。要是不想记过滤语法,lsof 也行,就是进程名会带转义:
# lsof -i :5678 -sTCP:LISTEN
COMMAND    PID USER   FD   TYPE DEVICE SIZE/OFF NODE NAME
n8nx20st 1053 root   24u  IPv4  33852      0t0  TCP localhost:5678 (LISTEN)
n8nx20st 不是乱码,x20 是空格,真名就是 n8n start。第一次看到会以为是哪个陌生程序,别慌。想只要 pid,fuser 最省事:
# fuser -n tcp 5678
5678/tcp:             1053
拿到 pid,ps -o pid,etime,cmd -p <pid> 看它跑了多久。这一步能分出两种完全不同的局面。
一种是自己的旧进程没死。你在 systemd 里 stop 了,或者 docker rm 了,进程还挂在后台。etime 显示几个小时的 n8n,基本就是它。干净的做法是先 systemctl stop n8n,再用 kill,别一上来 kill -9——迁移写到一半被硬杀,数据库可能卡在半升级状态,那是要恢复备份才能救的。
另一种是别的服务占了你的端口。云主机上 8080、3000 这种端口被面板、被某个 Node 小服务悄悄占掉很常见。这时候只有两条路:让对方让位,或者自己换端口。N8N_PORT=5679 改起来一分钟,但别只改一处——反代、WEBHOOK_URL、N8N_EDITOR_BASE_URL 里写死的端口会跟着一起错,webhook 收不到就是这么来的。
还有一种情况看着像端口冲突,其实是监听地址的问题。n8n 的 N8N_LISTEN_ADDRESS 默认值是 ::,双栈,会把 IPv4 也一起盖住。所以别人只占了 127.0.0.1:5678,你用默认值起 n8n,一样起不来。我实测过:python 只绑了 127.0.0.1:5694,n8n 用默认地址起在 5694,报的还是「port 5694 is already in use」。
顺带说一句,:: 全开会带来另一个问题:n8n 直接暴露在所有网卡上,包括公网那张。我这台的写法是反过来的,只监听本机,外面交给 nginx。
Environment=N8N_HOST=127.0.0.1
Environment=N8N_LISTEN_ADDRESS=127.0.0.1
Environment=N8N_PORT=5678
Environment=N8N_PROTOCOL=http
端口没被占也起不来:地址写错、权限不够
端口空着,为什么还起不来。两种原因最常见,报错长得不像一家人。
第一种,监听地址在本机不存在。换了机房、重建了实例、DHCP 续租换了 IP,配置文件里那个旧 IP 就没人认了:
n8n webserver failed, exiting listen EADDRNOTAVAIL: address not available 10.9.9.9:5679这是我把 N8N_LISTEN_ADDRESS 写成 10.9.9.9 打出来的,那台机器网卡上没有这个地址。看到 EADDRNOTAVAIL 就别查端口了,去 ip addr 看本机到底有哪些 IP,或者干脆写 127.0.0.1。
第二种,权限。小于 1024 的端口要 root,或者要 CAP_NET_BIND_SERVICE 这个能力。这层错误是 Node 抛的,不是 n8n 包装过的,所以会带一段 node:events 的堆栈:
node:events:505
    throw er; // Unhandled 'error' event
    ^
Error: listen EACCES: permission denied 0.0.0.0:80
    at Server.setupListenHandle [as _listen2] (node:net:2306:21)
我不建议为了省事把 n8n 起在 80。反代一层能拿到的东西太多:证书续期、gzip、限流、ip 白名单,都比 n8n 自己那套省心,改配置还不用重启 n8n。非得直接用 80,那就正经给权限。我自己那台是 root 在跑,图省事;多人共用的机器上我不建议这么干——n8n 里存着你所有第三方服务的凭据,进程权限放大之后,能拿走的东西跟着放大。
ECONNREFUSED 到底谁在拒绝你
这条报错其实是 n8n 在启动第二段发出的:它去连数据库,对方端口没人应答,内核直接回一个 RST。n8n 会重试 5 次,间隔 1 秒、2 秒、4 秒、8 秒、16 秒,前后约 31 秒,然后放弃退出。
Initial database connection attempt 1 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 1000ms
Initial database connection attempt 2 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 2000ms
Initial database connection attempt 3 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 4000ms
Initial database connection attempt 4 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 8000ms
Initial database connection attempt 5 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 16000ms
There was an error initializing DB
There was an error initializing DB
Error: There was an error initializing DB
    at Start.exitWithCrash (/usr/lib/node_modules/n8n/src/commands/base-command.ts:361:28)
上面这段是我把 DB_TYPE 改成 postgresdb、端口故意指到没人监听的 5433 打出来的,原样照抄。There was an error initializing DB 连打两遍也是真的,不是我复制粘错,看到重复行不用怀疑自己。
重试这件事要理解对:它是「启动时连库」的重试,不是「永远等」。看见 attempt 1 别急着重启,等 31 秒;看见 5 次全失败,那就是真不通,重启一百次也一样。
地址里的端口是唯一有用的线索。DB_POSTGRESDB_PORT 默认 5432,报 5433 说明你自己配过,八成是复制了一份配置忘了改;报 127.0.0.1:5432 但你明明把库装在另一台机器上,说明环境变量没生效——systemd 里 Environment= 写错一行、Docker 里 -e 少一个,都会这样。
最坑的一种在容器里。n8n 跑在容器里,配置写 DB_POSTGRESDB_HOST=127.0.0.1,这个 127.0.0.1 是容器自己的回环,不是宿主机。库里跑在宿主机上,容器里怎么连都连不上,报的还是 ECONNREFUSED,看着和「库没启动」一模一样。要么把库也放进 compose,用服务名当 host;要么让容器认宿主机地址。
先在外面把连通性验掉,比在 n8n 日志里猜快得多:
# nc -vz 127.0.0.1 5678
Connection to 127.0.0.1 5678 port [tcp/*] succeeded!
# nc -vz 127.0.0.1 5433
nc: connect to 127.0.0.1 port 5433 (tcp) failed: Connection refused
nc 通了 n8n 还连不上,问题就在凭据和库名上,往下看 postgres 自己的日志,别在 n8n 这边绕。
「SQLite package has not been found installed」那条
这条是启动第二段里最容易被误读的报错,我自己踩过。它出现在默认的 SQLite 场景——也就是绝大多数人第一次装 n8n 的时候。日志长这样:
Initial database connection attempt 1 failed: SQLite package has not been found installed. Try to install it: npm install sqlite3 --save. Retrying in 1000ms
Initial database connection attempt 2 failed: SQLite package has not been found installed. ...
...
Error: There was an error initializing DB
DriverPackageNotInstalledError: SQLite package has not been found installed. Try to install it: npm install sqlite3 --save.
    at SqliteLibrary.loadLibrary (/usr/lib/node_modules/n8n/node_modules/@n8n/typeorm/dist/driver/sqlite-pooled/SqliteLibrary.js:30:19)
人容易被最后那段堆栈带走,以为「初始化 DB 失败」是数据库坏了。第一行其实说清楚了:sqlite3 这个原生模块不在。npm 装 n8n 时会顺带编一个原生模块,编译环境不全、升级过 Node 大版本、装包时加了 --ignore-scripts,都会让这块缺失。这段日志就夹在我那台机器两次成功启动的记录中间,当时没记下是哪一步修好的,只知道和数据库本身无关。
修的路子有三条,按代价从小到大排:装好编译环境(python3、make、g++)之后重装 n8n;或者开 N8N_REINSTALL_MISSING_PACKAGES=true,让它在启动时自己补装缺的包,写进 Dockerfile 或 systemd 都行;折腾不动就换 Docker 镜像,镜像里这些原生模块是编好的。报错里那句 npm install sqlite3 --save 是给「n8n 当本地依赖装」的场景看的,全局安装时照抄不一定生效。
顺带记一下版本要求:n8n 要求 Node 20.19 到 24.x,超出这个范围的 Node 会出现各种奇怪的原生模块问题。我这台是 24.21.0。
.n8n 目录写不进去
启动第一段的失败,报错里带 EACCES 和 mkdir,说明它连自己的数据目录都建不出来。.n8n 目录存着数据库文件、加密密钥、配置,目录不可写就是彻底起不来:
No encryption key found - Auto-generating and saving to: /root/n8n_noperm/.n8n/config
Error: Failed to load command "start"
Error: EACCES: permission denied, mkdir '/root/n8n_noperm/.n8n'
    at mkdirSync (node:fs:1410:26)
at InstanceSettings.loadOrCreate (/usr/lib/node_modules/n8n/node_modules/n8n-core/src/instance-settings/instance-settings.ts:353:12)这段有个阴人的地方:它先打印「没有密钥,正在生成并保存到某路径」,然后才失败。只看前面那行,会以为一切顺利,其实一个字都没写进去。判断标准就一个——后面有没有 Editor is now accessible via,没有就是没起来。
这段是我用 nobody 用户去跑、目标目录在 /root 下面打出来的,谁都写不进去。真实运维里更常见的是 Docker:容器里的 n8n 以 uid 1000 的 node 用户运行,宿主机上你 mkdir 出来的目录如果是 root 700,挂进去就是这个错。修法是把宿主目录的属主改对,不是给权限加满:
chown -R 1000:1000 /srv/n8n-datachmod 777 能让它起来,我不建议。那个目录里有加密密钥文件,同机任何用户都能读,等于把库里所有第三方凭据的钥匙挂在门把手上。
我实际的排查顺序
出问题的时候别从日志第一行开始读,按这个顺序走,五分钟能定位到段:
- 看服务状态。
systemctl status n8n或者docker ps -a。重点不是 active 还是 failed,是Restart次数和Restarting (1) 3 seconds ago这种循环。循环说明它在反复启动又反复死,去看日志,别在 systemd 上折腾。 - 找日志。先试
journalctl -u n8n -n 50。我这台返回的是-- No entries --,因为 unit 里把输出重定向到文件了:StandardOutput=append:/data/logs/n8n.out.log。这种情况直接tail -100 /data/logs/n8n.out.log。Docker 就是docker logs --tail 100 n8n。 - 数一下重启过几次。
grep -c 'n8n ready on' /data/logs/n8n.out.log,我这台是 30。日志是追加写的,历史全在,同一个错误反复出现就是循环启动。 - 查端口。
ss -ltnp 'sport = :5678',对着上面对号入座。 - 验健康。
curl -s http://127.0.0.1:5678/healthz。进程活着就会回{"status":"ok"},这个不看数据库。
第 2 步的 journalctl 返回空,很容易让人以为服务根本没写日志。服务明明是 systemd 管的,日志却在文件里。所以先 systemctl cat n8n 看有没有重定向,比闷头翻日志快。
Docker 那边多两步:docker ps -a 的 STATUS 列会写 Restarting (1) 3 seconds ago,括号里那个数字一直涨就是反复启动;端口对不上先看 docker port n8n,它会把宿主端口和容器端口列出来。我这台是 npm 装的,容器里的报错原文没亲手打过,这几条按 docker 的常见表现写。
怎么算真的起来了
端口在听,不等于能干活。n8n 有两个现成的检查端点,区别很实用:
# curl -s -o /dev/null -w '%{http_code}n' http://127.0.0.1:5678/healthz
200
# curl -s http://127.0.0.1:5678/healthz
{"status":"ok"}
# curl -s -o /dev/null -w '%{http_code}n' http://127.0.0.1:5678/healthz/readiness
200
/healthz 200 只说明进程能应答,它不看数据库。/healthz/readiness 才是「数据库连上了、迁移也跑完了」。重启完的几十秒里,前者可能已经是 200,后者还没跟上,那就是迁移还在跑。写监控脚本的时候用 readiness,别用 healthz——只有前者能反映「这台机器能不能接流量」。
两个都 200 之后,走一遍真活:
- 打开编辑器,能登录,能看到工作流列表,不是白屏转圈。
- 随便跑一个带 Code 节点的工作流,成功。这一步验证的是 task runner,前面说过它常被忽略。
- 把工作流发布(publish),让它真跑一次,执行记录里能看到这条生产执行、状态成功。
第三项别省。有些部署编辑器一切正常,到点却不执行,原因在队列模式下的 worker 没连上,这类问题只有真跑一次才暴露。
界面里那句「服务拒绝连接」
启动失败时你根本进不去界面,所以这一节讲的是另一种——n8n 起来了,工作流里连的东西没起来。这两种故障的排查方向完全相反,别混。
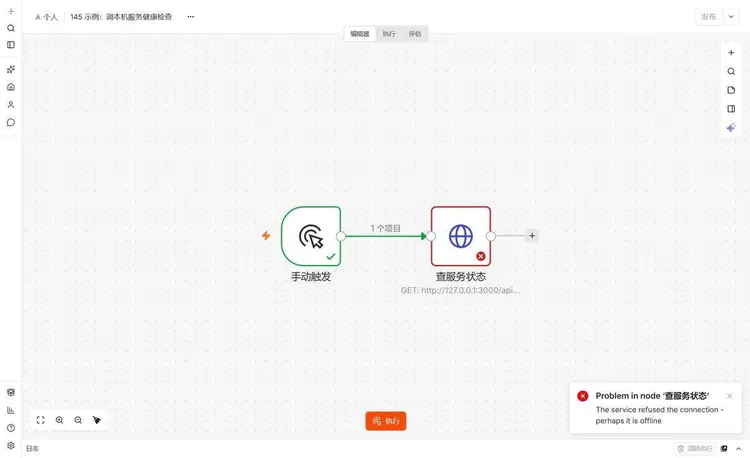
一次跑挂之后,画布上节点是红的,右下角弹出 Problem in node '查服务状态',下面一行小字 The service refused the connection - perhaps it is offline。这句是 n8n 翻译过的人话,它没说端口,也没说协议。
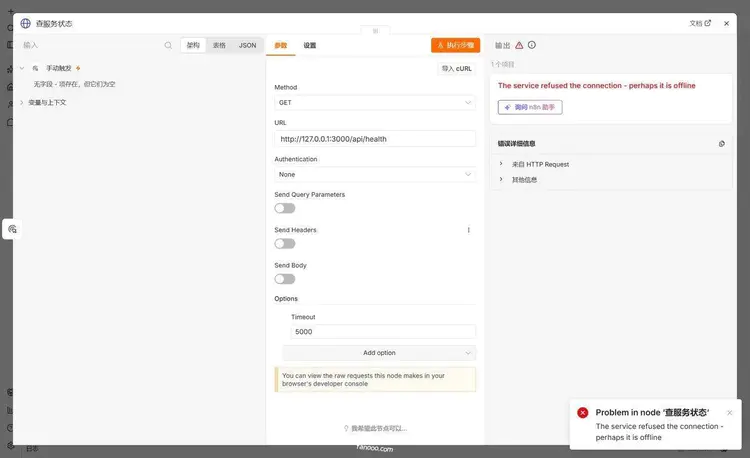
双击节点,右边输出面板往下拉,有个折叠的「错误详细信息」,点开才看得到原始信息。
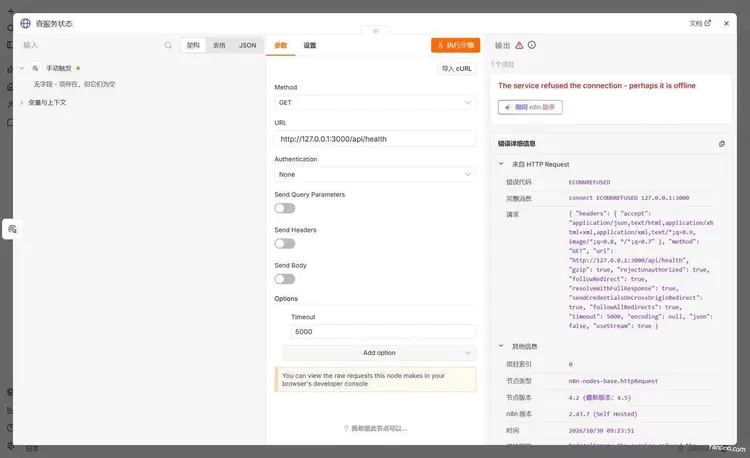
「错误代码」那行是 ECONNREFUSED,「完整消息」是 connect ECONNREFUSED 127.0.0.1:3000。到这里就和启动时那条报错对上了,同一个错误码,只是这次发生在节点里。拿这个端口去 nc -vz,通不通立刻知道。
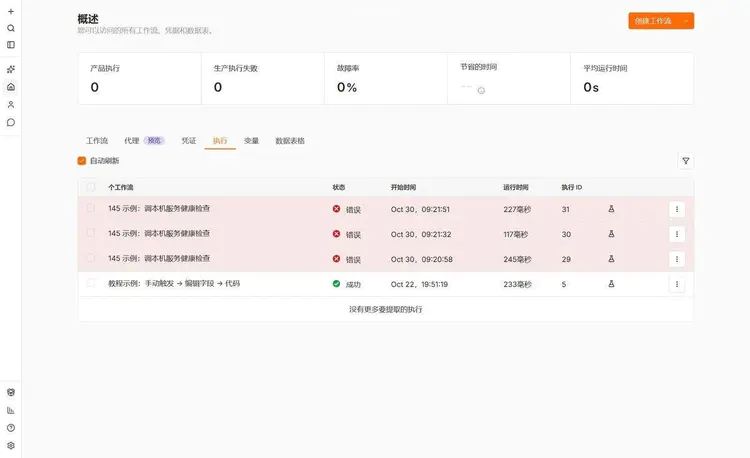
执行记录里还有一个免费的判据:运行时间。我这三次分别是 227、117、245 毫秒。连 TCP 都没握上手才会这么快;如果是对方连上了但返回 500,或者超时,耗时会是几百毫秒到几秒不等,甚至顶到你设的 timeout。两百毫秒以内报错,直接往「端口/地址/服务没启动」上想,往「接口返回内容不对」上想是浪费时间。
六条报错原文速查
| 报错原文 | 卡在哪 | 处理方向 |
|---|---|---|
n8n's port 5678 is already in use... |
第三段,端口 | ss -ltnp 'sport = :5678' 找 pid,停旧的或换端口 |
n8n webserver failed, exiting listen EADDRNOTAVAIL |
第三段,地址 | 配置里的 IP 本机没有,ip addr 核对 |
Error: listen EACCES: permission denied 0.0.0.0:80 |
第三段,权限 | 低于 1024 的端口要特权,换端口或加能力 |
Initial database connection attempt N failed: connect ECONNREFUSED |
第二段,数据库 | 等满 5 次重试,再 nc -vz host port |
DriverPackageNotInstalledError: SQLite package has not been found installed |
第二段,依赖 | 补 sqlite3,或重装 n8n |
EACCES: permission denied, mkdir '/.../.n8n' |
第一段,目录 | 数据目录属主不对,改 owner 不要 777 |
三条安全提醒
排查期间临时放宽的监听,记得改回去。为了从外面看一眼起没起来,把 N8N_LISTEN_ADDRESS 改成 0.0.0.0 或者加一条 -p 5678:5678,看完就忘。n8n 的编辑器在公网上就是个登录框,扫段脚本一天能试几千次。我这台只监听 127.0.0.1,公网走 nginx 443,这是常态,不要为了排障改成临时状态然后放着。
日志贴出去之前扫一遍。启动日志里有完整的 webhook URL,而 webhook 路径本身就是凭据,拿到路径就能往你的工作流里灌数据;堆栈里有安装路径、内网地址、数据库主机名。贴到群里、发到论坛求助之前,把这些换掉,换完再贴。
数据库密码别写在命令行上。docker run -e DB_POSTGRESDB_PASSWORD=xxx 会留在 shell history 里,也会出现在 docker inspect 的输出里,同机任何能执行 docker 命令的人都看得到。用 --env-file,或者 systemd 的 EnvironmentFile=,文件权限 600。前面贴过的那份 unit 就是这么写的,密码在 /etc/n8n/instance-ai.env 里,不在 unit 里。
小结
启动失败看着五花八门,其实就四段:密钥、数据库、监听、迁移。日志停在哪一行,决定了你该敲哪条命令,猜是没用的——那句「是不是已经有另一个 n8n 在跑了」就是专门骗人的。
三个命令够用了:ss -ltnp 'sport = :端口' 找占位者,nc -vz host 端口 验连通,curl /healthz/readiness 验就绪。剩下都是对着报错原文查这一篇的表格。
最后一句经验:n8n ready on 和 Editor is now accessible via 之间那段,最容易被当成已经好了。迁移没跑完就重启,或者干脆断电,是我见过代价最高的一种「小操作」。
接着往下
上一篇是《第一个工作流:手动触发 → 编辑字段 → 代码》,从头搭一条流程可以看那篇。还没装上的看《n8n 怎么安装》,界面不熟翻《界面导览》。零散的故障记录我整理在故障排查页,整门课的目录在这里。
参考资料
- Monitor n8n:
/healthz只看进程存活,/healthz/readiness要求数据库已连接且迁移完成 - Deployment 环境变量:
N8N_PORT默认 5678、N8N_LISTEN_ADDRESS默认::、N8N_USER_FOLDER的用途 - Database 环境变量:
DB_TYPE默认 sqlite、DB_POSTGRESDB_PORT默认 5432,以及运行中掉线的自动恢复参数 - Logs 环境变量:
N8N_LOG_OUTPUT默认 console,配成 file 后日志落在<n8n 目录>/logs/n8n.log - Use the command line:
n8n start、n8n export:workflow这些服务端命令,多数不需要 n8n 正在运行 - Install with Docker:官方 run 命令的端口映射与
/home/node/.n8n卷 - Install with npm:Node 版本区间 20.19 至 24.x
- Node.js errors:
EADDRINUSE、ECONNREFUSED、EACCES、EADDRNOTAVAIL各自的定义
最后更新:2026 年 10 月 30 日,用的是 n8n 2.43.7。