Wie man n8n-Startfehler und Portbelegung überprüft


Wenn der n8n auf der Serverseite nicht startet, gehört das zu den relativ gut nachvollziehbaren Fehlern – er hinterlässt dir garantiert eine Fehlerzeile. Das Problem ist, dass diese Fehlerzeile oft in die falsche Richtung zeigt. Für diesen Artikel habe ich mit python einen http.server gestartet, um den port zu belegen, und n8n sagt mir trotzdem „läuft vielleicht schon ein anderer n8n“.
Im Folgenden teile ich Startfehler danach in vier Kategorien ein, „an welcher Zeile das Log stehen bleibt“, jede Kategorie mit einem Befehl, den man sofort ausführen kann. Die Fehlertexte stammen alle von meiner eigenen 2.43.7, kein Wort geändert.
Für Selbsthoster: npm global installiert, mit Docker betrieben, von systemd verwaltet zählt alles. Wer die Cloud-Version nutzt, überspringt das, dort musst du dich nicht um den Start kümmern. Voraussetzung ist nur eines: Du kommst in die shell der Maschine oder kannst die container-Logs sehen.
- Der Start ist eine vierstufige Pipeline, an welcher Stufe das Log stehen bleibt, entscheidet, was zu prüfen ist
- Port belegt: drei Befehle, plus ein irreführender Hinweis
- Startet auch bei freiem Port nicht: Adresse falsch geschrieben, Rechte unzureichend
- ECONNREFUSED – wer lehnt dich eigentlich ab
- Die Meldung „SQLite package has not been found installed“
- Das .n8n-Verzeichnis ist nicht beschreibbar
- Meine tatsächliche Reihenfolge bei der Fehlersuche
- Woran man erkennt, dass er wirklich läuft
- Der Satz „Dienst verweigert die Verbindung“ in der Oberfläche
- Schnellnachschlage für sechs Fehlertexte
- Drei Sicherheitshinweise
Der Start ist eine vierstufige Pipeline, an welcher Stufe das Log stehen bleibt, entscheidet, was zu prüfen ist
Merkt euch zuerst, wie ein normaler Start aussieht, sonst weiß man beim Anblick eines halben Logs überhaupt nicht, welcher Teil fehlt. Dies ist ein vollständiger Start auf meiner Maschine, beginnend mit einem leeren Verzeichnis:
No encryption key found - Auto-generating and saving to: /data/n8n/.n8n/config
Initializing n8n process
n8n ready on 127.0.0.1, port 5678
Migrations in progress, please do NOT stop the process.
Starting migration InitialMigration1588102412422
Finished migration InitialMigration1588102412422
Editor is now accessible via:
Die Zeile „No encryption key found" erscheint nur beim ersten Start, danach ist der Schlüssel bereits geschrieben in .n8n/config und wird nicht mehr ausgegeben. Der Schlüssel und die Datenbank gehören zusammen – wechselt man den Schlüssel, lassen sich alle in der Datenbank gespeicherten Credentials nicht mehr entschlüsseln; das ist ein anderes Thema. Hier muss man sich nur merken, dass er zum ersten Startabschnitt gehört.
Ich habe den gesamten Ablauf in vier Blöcke aufgeteilt, wobei jeder Block ein völlig anderes Fehlerbild zeigt:
| Reihenfolge | Was passiert | Typischer Fehler, wenn dieser Abschnitt ausfällt |
|---|---|---|
| 1 | Konfigurationsdatei lesen, Encryption Key laden oder generieren | EACCES: permission denied, mkdir、Failed to load command "start" |
| 2 | Datenbank verbinden, mit 5 eingebauten Wiederholungsversuchen | Initial database connection attempt N failed: connect ECONNREFUSED、SQLite package has not been found installed |
| 3 | HTTP-Listener starten | n8n's port 5678 is already in use、n8n webserver failed, exiting listen EADDRNOTAVAIL |
| 4 | Datenbankmigrationen ausführen, task runner hochfahren | Migrations in progress Danach kommt keine Zeile mehr Finishedund der Prozess ist weg |
Ein Detail führt besonders leicht zu Fehleinschätzungen:n8n ready on 127.0.0.1, port 5678 ist nicht gleichbedeutend mit nutzbar. Es erscheint in Migrations in progress Vorher war der Port bereits geöffnet, die Datenbank wurde noch migriert. Dass der Editor zu diesem Zeitpunkt nicht geöffnet werden kann, ist normal – warte, bis die Migration durchgelaufen ist.
Im vierten Abschnitt gibt es noch etwas, das es erst ab 2.x gibt: Der Code-Node läuft nicht im Hauptprozess, n8n startet einen separaten n8n task-runner. Mit ps lässt sich die Eltern-Kind-Beziehung erkennen.
# ps -o pid,ppid,etime,cmd -p 1053,7782
    PID    PPID   ELAPSED CMD
   1053       1  6-09:37:45 n8n start
   7782    1053  6-09:33:32 n8n task-runner
Hauptprozess läuft, runner nicht – die Hauptoberfläche lässt sich öffnen, aber sobald der Code-Node ausgeführt wird, kommt ein Fehler. Bei diesem Symptom nicht am Code suchen, sondern zuerst ps prüfen, ob der runner läuft.
Port belegt: drei Befehle, plus eine irreführende Meldung
Schauen wir zuerst, was n8n selbst sagt. Bei einer Portkollision wirft es keinen Stacktrace aus, sondern nur einen Satz in Klartext, dann beendet sich der Prozess mit Exit-Code 1:
n8n's port 5678 is already in use. Do you have another instance of n8n running already?Dieser Satz lenkt achtzig Prozent der Aufmerksamkeit auf „ein anderes n8n“. Die Realität: Der Port kann von irgendetwas belegt sein. Ich habe python3 -m http.server 5693 belegt 5693, dann n8n auf 5693 gezeigt – es sagt immer noch denselben Satz. Raten hilft nicht, nachschauen.
# ss -ltnp 'sport = :5678'
State  Recv-Q Send-Q Local Address:Port Peer Address:Port Process
LISTEN 0      511        127.0.0.1:5678      0.0.0.0:*    users:(("n8n start",pid=1053,fd=24))
ss Auf Debian, Ubuntu, CentOS vorinstalliert, sauberste Ausgabe, liefert direkt die pid. Wer sich die Filter-Syntax nicht merken will,lsof geht auch, nur enthält der Prozessname dann Escapes:
# lsof -i :5678 -sTCP:LISTEN
COMMAND    PID USER   FD   TYPE DEVICE SIZE/OFF NODE NAME
n8nx20st 1053 root   24u  IPv4  33852      0t0  TCP localhost:5678 (LISTEN)
n8nx20st Das ist kein Zeichensalat,x20 sondern ein Leerzeichen, der echte Name ist n8n start. Beim ersten Mal denkt man, es sei irgendein fremdes Programm – keine Panik. Wer nur die pid will,fuser am einfachsten:
# fuser -n tcp 5678
5678/tcp:             1053
PID holen,ps -o pid,etime,cmd -p <pid> schauen, wie lange er schon läuft. Dieser Schritt trennt zwei völlig unterschiedliche Szenarien.
Eines: Der eigene alte Prozess ist nicht beendet.Du hast in systemd stop , oder docker rm , der Prozess hängt noch im Hintergrund. Ein etime von mehreren Stunden bei n8n ist praktisch immer dieser Fall. Sauberer Weg: zuerst systemctl stop n8n, dann mit kill, nicht gleich kill -9——mitten in der Migration hart gekillt, kann die Datenbank im halb migrierten Zustand hängen bleiben, das lässt sich nur durch Einspielen eines Backups retten.
Anderes Szenario: Ein anderer Dienst belegt deinen Port.Auf Cloud-Hosts werden Ports wie 8080, 3000 häufig von Panels oder irgendeinem kleinen Node-Dienst unbemerkt belegt. Dann gibt es nur zwei Wege: den anderen weichen lassen oder selbst den Port wechseln.N8N_PORT=5679 Änderung dauert eine Minute, aber nicht nur an einer Stelle ändern——Reverse Proxy,WEBHOOK_URL、N8N_EDITOR_BASE_URL fest eingetragene Ports gehen mit kaputt, genau deshalb kommen Webhooks nicht an.
Es gibt noch einen Fall, der wie ein Portkonflikt aussieht, aber eigentlich ein Listen-Adress-Problem ist. Bei n8n ist der N8N_LISTEN_ADDRESS Standardwert ::, Dual-Stack, deckt auch IPv4 mit ab. Also belegt jemand anderes nur 127.0.0.1:5678, startest du n8n mit den Standardwerten, läuft es genauso wenig. Ich habe es selbst getestet: python bindet nur an 127.0.0.1:5694, n8n startet mit der Standardadresse auf 5694 und meldet weiterhin „port 5694 is already in use“.
Nebenbei gesagt,:: Alles zu öffnen bringt ein weiteres Problem mit sich: n8n ist direkt auf allen Netzwerkkarten exponiert, einschließlich der öffentlichen. Bei meiner Maschine ist es umgekehrt geschrieben, nur localhost lauscht, draußen übernimmt nginx.
Environment=N8N_HOST=127.0.0.1
Environment=N8N_LISTEN_ADDRESS=127.0.0.1
Environment=N8N_PORT=5678
Environment=N8N_PROTOCOL=http
Auch wenn der port nicht belegt ist, startet es nicht: Adresse falsch geschrieben, Rechte unzureichend
Der port ist frei, warum startet es trotzdem nicht. Zwei Ursachen sind am häufigsten, die Fehlermeldungen sehen nicht aus wie aus einer Familie.
Erste Ursache: Die Listen-Adresse existiert auf dem lokalen Rechner nicht. Rechenzentrum gewechselt, Instanz neu erstellt, DHCP-Lease erneuert und IP geändert – die alte IP in der Konfigurationsdatei erkennt niemand mehr an:
n8n webserver failed, exiting listen EADDRNOTAVAIL: address not available 10.9.9.9:5679Das ist, was ich beim Schreiben von N8N_LISTEN_ADDRESS als 10.9.9.9 herausbekommen habe, diese Adresse gibt es auf der Netzwerkkarte jener Maschine nicht. Wenn du EADDRNOTAVAIL siehst, dann prüfe nicht den port, gehe zu ip addr und schaue, welche IPs der lokale Rechner tatsächlich hat, oder schreibe einfach 127.0.0.1。
Zweite Ursache: Rechte. ports kleiner als 1024 benötigen root oder CAP_NET_BIND_SERVICE diese Fähigkeit. Dieser Fehler wird von Node geworfen, nicht von n8n verpackt, daher kommt ein Stück node:events Stack mit:
node:events:505
    throw er; // Unhandled 'error' event
    ^
Error: listen EACCES: permission denied 0.0.0.0:80
    at Server.setupListenHandle [as _listen2] (node:net:2306:21)
Ich empfehle nicht, n8n aus Bequemlichkeit auf 80 zu starten. Eine Reverse-Proxy-Schicht liefert zu viel: Zertifikatserneuerung, gzip, Rate Limiting, IP-Whitelist – alles sorgloser als das eigene System von n8n, und Konfigurationsänderungen erfordern keinen Neustart von n8n. Wenn es unbedingt direkt 80 sein muss, dann gib ordentlich Rechte. Meine eigene Maschine läuft als root, aus Bequemlichkeit; auf gemeinsam genutzten Maschinen empfehle ich das nicht – in n8n liegen die Zugangsdaten all deiner Drittanbieter-Dienste, und wenn die Prozessrechte erweitert werden, wächst mit ihnen auch das, was entwendet werden kann.
ECONNREFUSED – wer lehnt dich eigentlich ab
Diese Fehlermeldung wird tatsächlich von n8n in der zweiten Startphase ausgegeben: Es versucht, eine Verbindung zur Datenbank herzustellen, am Port der Gegenseite antwortet niemand, und der Kernel sendet direkt ein RST zurück. n8n wiederholt den Versuch 5 Mal, mit Abständen von 1 Sekunde, 2 Sekunden, 4 Sekunden, 8 Sekunden und 16 Sekunden – insgesamt etwa 31 Sekunden – und beendet sich dann.
Initial database connection attempt 1 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 1000ms
Initial database connection attempt 2 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 2000ms
Initial database connection attempt 3 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 4000ms
Initial database connection attempt 4 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 8000ms
Initial database connection attempt 5 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 16000ms
There was an error initializing DB
There was an error initializing DB
Error: There was an error initializing DB
    at Start.exitWithCrash (/usr/lib/node_modules/n8n/src/commands/base-command.ts:361:28)
Der obige Abschnitt stammt aus meinem Test, bei dem ich DB_TYPE auf postgresdb geändert und den Port absichtlich auf 5433 gesetzt habe, wo niemand lauscht – originalgetreu übernommen.There was an error initializing DB Dass es zweimal hintereinander auftritt, stimmt ebenfalls – ich habe mich nicht beim Kopieren vertippt. Wenn du doppelte Zeilen siehst, musst du nicht an dir zweifeln.
Das mit den Wiederholungsversuchen muss man richtig verstehen: Es ist ein Retry beim „Verbindungsaufbau zur Datenbank beim Start", kein „ewiges Warten". Wenn du attempt 1 siehst, starte nicht voreilig neu – warte 31 Sekunden. Wenn du siehst, dass alle 5 Versuche fehlgeschlagen sind, dann ist es wirklich nicht erreichbar, und hundert Neustarts ändern daran nichts.
Der Port in der Adresse ist der einzige nützliche Hinweis.DB_POSTGRESDB_PORT Standard ist 5432; wenn 5433 gemeldet wird, hast du selbst konfiguriert – zu 80 % hast du eine Konfiguration kopiert und vergessen, sie anzupassen. Wenn 127.0.0.1:5432 gemeldet wird, du die Datenbank aber offensichtlich auf einer anderen Maschine installiert hast, dann haben die Umgebungsvariablen keine Wirkung – in systemd eine Zeile Environment= falsch geschrieben, in Docker -e eines fehlt – beides führt dazu.
Der gemeinste Fall tritt im Container auf. n8n läuft im Container, die Konfiguration enthält DB_POSTGRESDB_HOST=127.0.0.1– dieses 127.0.0.1 ist das Loopback des Containers selbst, nicht des Hosts. Läuft die Datenbank auf dem Host, kann der Container sich nicht verbinden, und es wird weiterhin ECONNREFUSED gemeldet – sieht genauso aus wie „Datenbank nicht gestartet". Entweder die Datenbank ebenfalls in die compose packen und den Servicenamen als host verwenden, oder dem Container die Host-Adresse bekannt machen.
Prüfe die Konnektivität zuerst von außen – das geht viel schneller, als in den n8n-Logs zu raten:
# nc -vz 127.0.0.1 5678
Connection to 127.0.0.1 5678 port [tcp/*] succeeded!
# nc -vz 127.0.0.1 5433
nc: connect to 127.0.0.1 port 5433 (tcp) failed: Connection refused
Wenn nc durchgeht und n8n sich trotzdem nicht verbinden kann, liegt das Problem bei den Zugangsdaten und dem Datenbanknamen – schau weiter in den postgres-eigenen Logs nach und dreh keine Runden auf der n8n-Seite.
Der Eintrag „SQLite package has not been found installed“
Dies ist der am häufigsten missverstandene Fehler im zweiten Startabschnitt, ich bin selbst darüber gestolpert. Er tritt im Standard-SQLite-Szenario auf – also bei den allermeisten, die n8n zum ersten Mal installieren. Das Log sieht so aus:
Initial database connection attempt 1 failed: SQLite package has not been found installed. Try to install it: npm install sqlite3 --save. Retrying in 1000ms
Initial database connection attempt 2 failed: SQLite package has not been found installed. ...
...
Error: There was an error initializing DB
DriverPackageNotInstalledError: SQLite package has not been found installed. Try to install it: npm install sqlite3 --save.
    at SqliteLibrary.loadLibrary (/usr/lib/node_modules/n8n/node_modules/@n8n/typeorm/dist/driver/sqlite-pooled/SqliteLibrary.js:30:19)
Man lässt sich leicht vom letzten Stack-Abschnitt verleiten und denkt, „Initialisierung der DB fehlgeschlagen“ bedeute, die Datenbank sei kaputt. Die erste Zeile sagt es eigentlich klar:sqlite3 Dieses native Modul fehlt. Beim npm-Installieren von n8n wird ein natives Modul mitkompiliert; unvollständige Build-Umgebung, ein Major-Versionsupgrade von Node, oder beim Paketinstallieren hinzugefügtes --ignore-scriptsführen alle dazu, dass dieser Teil fehlt. Dieser Log-Abschnitt liegt zwischen zwei erfolgreichen Startvorgängen auf meiner Maschine; ich habe damals nicht notiert, welcher Schritt es behoben hat, ich weiß nur, dass es nichts mit der Datenbank selbst zu tun hatte.
Es gibt drei Lösungswege, nach Aufwand von klein nach groß sortiert: Build-Umgebung installieren (python3、make、g++) und dann n8n neu installieren; oder N8N_REINSTALL_MISSING_PACKAGES=trueaktivieren, damit es beim Start die fehlenden Pakete selbst nachinstalliert – entweder ins Dockerfile oder in systemd schreiben; wenn das zu mühsam ist, auf ein Docker-Image wechseln, in dem diese nativen Module bereits kompiliert sind. Der Satz npm install sqlite3 --save im Fehlerlog ist für das Szenario gedacht, in dem n8n als lokale Abhängigkeit installiert wird; bei einer globalen Installation funktioniert das Kopieren nicht unbedingt.
Nebenbei die Versionsanforderung: n8n verlangt Node 20.19 bis 24.x; Node außerhalb dieses Bereichs zeigt allerlei seltsame native Modul-Probleme. Meine Maschine läuft mit 24.21.0.
Das .n8n-Verzeichnis ist nicht beschreibbar
Der Fehler im ersten Startabschnitt enthält EACCES 和 mkdir, was bedeutet, dass es nicht einmal sein eigenes Datenverzeichnis anlegen kann..n8n Das Verzeichnis enthält Datenbankdateien, Verschlüsselungsschlüssel und Konfiguration; ist das Verzeichnis nicht beschreibbar, startet es überhaupt nicht:
No encryption key found - Auto-generating and saving to: /root/n8n_noperm/.n8n/config
Error: Failed to load command "start"
Error: EACCES: permission denied, mkdir '/root/n8n_noperm/.n8n'
    at mkdirSync (node:fs:1410:26)
    at InstanceSettings.loadOrCreate (/usr/lib/node_modules/n8n/node_modules/n8n-core/src/instance-settings/instance-settings.ts:353:12)
Dieser Abschnitt hat eine gemeine Stelle:Es gibt zuerst „Kein Schlüssel vorhanden, wird generiert und unter einem bestimmten Pfad gespeichert“ aus und schlägt dann fehl. Liest man nur die Zeile davor, denkt man, alles sei in Ordnung, dabei wurde kein einziges Zeichen hineingeschrieben. Das Beurteilungskriterium ist nur eines – ob danach Editor is now accessible viasteht, wenn nicht, ist es nicht gestartet.
Dieser Abschnitt wurde von mir mit dem Benutzer nobody ausgeführt, das Zielverzeichnis liegt unter /root und wurde dort ausgegeben, niemand kann hineinschreiben. Im echten Betrieb ist Docker häufiger: Das n8n im container läuft als node-Benutzer mit uid 1000, und wenn das Verzeichnis, das du auf dem Host mkdir hast, root 700 ist, ergibt das beim mount genau diesen Fehler. Die Lösung besteht darin, den Eigentümer des Host-Verzeichnisses korrekt zu setzen, nicht die Berechtigungen voll aufzudrehen:
chown -R 1000:1000 /srv/n8n-datachmod 777 Damit es startet, empfehle ich das nicht. In diesem Verzeichnis liegt die verschlüsselte Schlüsseldatei, jeder Benutzer auf derselben Maschine kann sie lesen, das ist, als würde man die Schlüssel für alle Drittanbieter-Anmeldedaten in der Datenbank an die Türklinke hängen.
Meine tatsächliche Fehlersuche-Reihenfolge
Wenn ein Problem auftritt, lies nicht ab der ersten Logzeile, geh in dieser Reihenfolge vor, in fünf Minuten hast du das Segment lokalisiert:
- Servicestatus prüfen.
systemctl status n8noderdocker ps -a. Wichtig ist nicht active oder failed, sondernRestartAnzahl undRestarting (1) 3 seconds agosolche Schleifen. Eine Schleife bedeutet, dass es wiederholt startet und wiederholt stirbt, schau ins Log, mach nicht an systemd herum. - Log finden.Zuerst versuchen
journalctl -u n8n -n 50. Meine hier gibt zurück-- No entries --, weil im unit die Ausgabe in eine Datei umgeleitet wird:StandardOutput=append:/data/logs/n8n.out.log. In diesem Fall direkttail -100 /data/logs/n8n.out.log. Docker istdocker logs --tail 100 n8n。 - Zähle, wie oft neu gestartet wurde.
grep -c 'n8n ready on' /data/logs/n8n.out.log, meine hier ist 30. Das Log wird im Append-Modus geschrieben, die Historie ist vollständig vorhanden, und wenn derselbe Fehler wiederholt auftritt, handelt es sich um einen Start-Loop. - Port prüfen.
ss -ltnp 'sport = :5678', gleiche mit oben ab und ordne es zu. - Health prüfen.
curl -s http://127.0.0.1:5678/healthz. Solange der Prozess läuft, wird zurückgegeben{"status":"ok"}, das schaut nicht auf die Datenbank.
Der aus Schritt 2 journalctl gibt leer zurück, was leicht dazu verleitet zu glauben, der Dienst hätte gar keine Logs geschrieben. Der Dienst wird offensichtlich von systemd verwaltet, aber die Logs liegen in einer Datei. Also zuerst systemctl cat n8n prüfen, ob eine Umleitung vorhanden ist, das ist schneller, als blind in den Logs zu wühlen.
Bei Docker sind es zwei Schritte mehr:docker ps -a Die STATUS-Spalte zeigt Restarting (1) 3 seconds ago, die steigende Zahl in der Klammer bedeutet wiederholtes Starten; bei abweichenden Ports zuerst prüfen docker port n8n, es listet Host-Port und Container-Port auf. Bei mir ist es per npm installiert, die Fehlermeldung im container habe ich nicht selbst gesehen, diese Punkte sind nach dem üblichen Docker-Verhalten geschrieben.
Wann läuft es wirklich
Der Port lauscht, heißt nicht, dass es arbeitet. n8n hat zwei fertige Check-Endpunkte, der Unterschied ist praktisch:
# curl -s -o /dev/null -w '%{http_code}n' http://127.0.0.1:5678/healthz
200
# curl -s http://127.0.0.1:5678/healthz
{"status":"ok"}
# curl -s -o /dev/null -w '%{http_code}n' http://127.0.0.1:5678/healthz/readiness
200
/healthz 200 heißt nur, der Prozess antwortet, es prüft die Datenbank nicht./healthz/readiness Erst das heißt „Datenbank verbunden, Migrationen auch durch". In den Sekunden nach dem Neustart kann ersterer schon 200 sein, letzterer noch nicht, dann laufen die Migrationen noch. Beim Monitoring-Skript readiness verwenden, nicht healthz—nur ersterer zeigt, ob „diese Maschine Traffic annehmen kann".
Nachdem beide 200 sind, einen echten Durchlauf:
- Editor öffnen, einloggen können, Workflow-Liste sehen, kein weißer Bildschirm mit Drehen.
- Irgendeinen Workflow mit Code-Node laufen lassen, erfolgreich. Dieser Schritt prüft den task runner, der wie erwähnt oft übersehen wird.
- Den Workflow publizieren (publish), ihn wirklich einmal laufen lassen, im Ausführungsprotokoll diese Produktionsausführung mit Status erfolgreich sehen.
Den dritten Punkt nicht weglassen. Bei manchen Deployments ist der Editor völlig normal, zur Zeit wird aber nicht ausgeführt, Ursache ist der nicht verbundene worker im Queue-Modus, solche Probleme zeigen sich nur bei einem echten Lauf.
Der Satz „Service refused connection" in der Oberfläche
Bei Startfehler kommt man gar nicht in die Oberfläche, daher geht es in diesem Abschnitt um den anderen Fall—n8n läuft, das im Workflow Verbundene läuft nicht. Die Fehlersuche dieser beiden Fälle geht in völlig entgegengesetzte Richtungen, nicht vermischen.
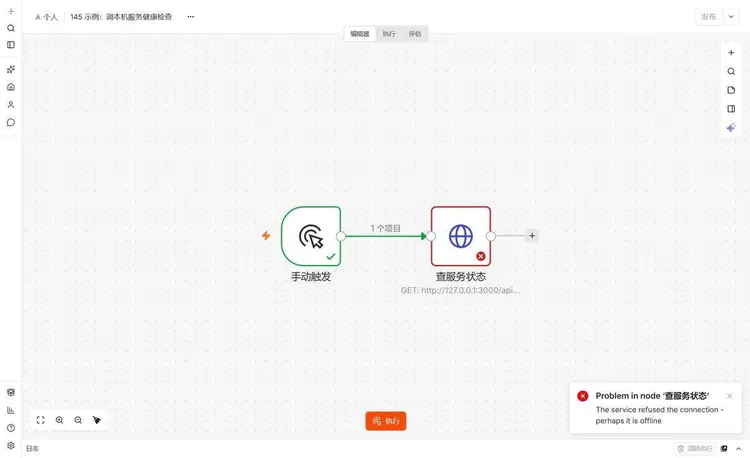
Nach einem fehlgeschlagenen Lauf ist der Node auf der Canvas rot, unten rechts erscheint Problem in node '查服务状态', darunter eine kleine Zeile The service refused the connection - perhaps it is offline. Dieser Satz ist das von n8n übersetzte Klartext-Deutsch, es nennt weder Port noch Protokoll.
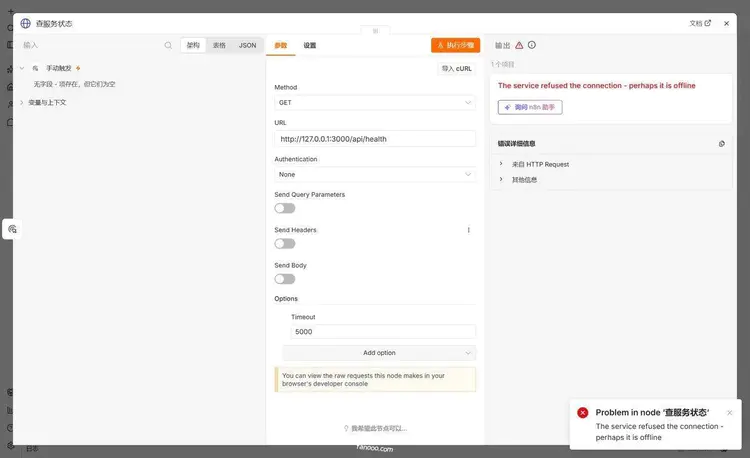
Doppelklicke den Node, scrolle im rechten Ausgabebereich nach unten, dort gibt es ein eingeklapptes „Fehlerdetails“, erst beim Aufklappen siehst du die Originalinformation.
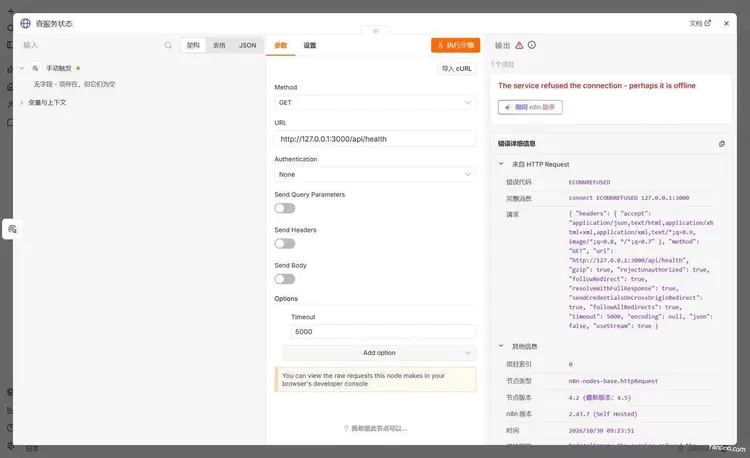
Die Zeile „Fehlercode“ ist ECONNREFUSED, die „vollständige Meldung“ ist connect ECONNREFUSED 127.0.0.1:3000. Damit deckt sich das mit der Fehlermeldung beim Start, derselbe Fehlercode, nur diesmal im Node. Nimm diesen Port für nc -vz, ob er erreichbar ist, weißt du sofort.
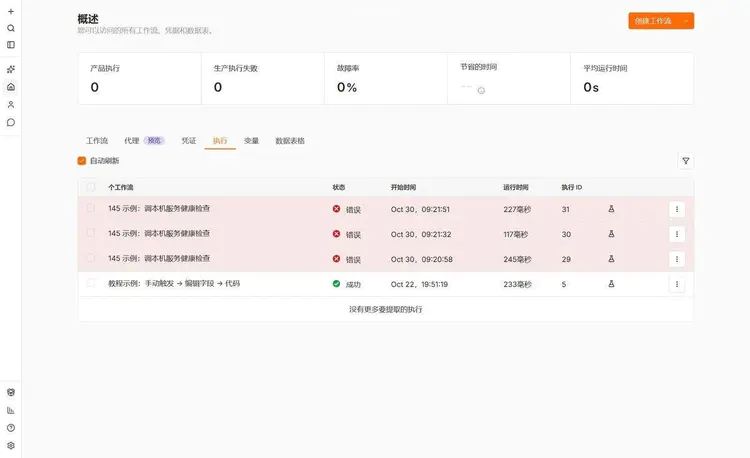
In der Ausführungsaufzeichnung gibt es noch ein kostenloses Kriterium: die Laufzeit. Bei mir waren es diese drei Male 227, 117, 245 Millisekunden. So schnell ist es nur, wenn nicht einmal der TCP-Handshake zustande kam; wenn die Gegenseite verbunden hat, aber 500 zurückgibt, oder bei Timeout, dauert es je nach Fall mehrere hundert Millisekunden bis Sekunden, sogar bis zu deinem gesetzten timeout. Fehler unter zweihundert Millisekunden: direkt an „Port/Adresse/Dienst nicht gestartet“ denken, an „Schnittstelle liefert falschen Inhalt“ zu denken ist Zeitverschwendung.
Sechs Fehlermeldungen im Original zum Schnellnachschlagen
| Fehlermeldung im Original | Wo es hängt | Lösungsrichtung |
|---|---|---|
n8n's port 5678 is already in use... |
Dritter Abschnitt, port | ss -ltnp 'sport = :5678' pid finden, alten Prozess stoppen oder port wechseln |
n8n webserver failed, exiting listen EADDRNOTAVAIL |
Dritter Abschnitt, Adresse | Die IP in der Konfiguration existiert nicht auf dem lokalen Rechner,ip addr überprüfen |
Error: listen EACCES: permission denied 0.0.0.0:80 |
Dritter Abschnitt, Berechtigungen | Ports unter 1024 erfordern Privilegien, port wechseln oder Capabilities hinzufügen |
Initial database connection attempt N failed: connect ECONNREFUSED |
Zweiter Abschnitt, Datenbank | volle 5 Wiederholungsversuche abwarten, dann nc -vz host port |
DriverPackageNotInstalledError: SQLite package has not been found installed |
Zweiter Abschnitt, Abhängigkeiten | 补 sqlite3, oder n8n neu installieren |
EACCES: permission denied, mkdir '/.../.n8n' |
Erster Abschnitt, Verzeichnis | Der Eigentümer des Datenverzeichnisses ist falsch, owner ändern, nicht 777 |
Drei Sicherheitshinweise
Die während der Fehlersuche vorübergehend gelockerten Listener danach wieder zurückstellen.Um von außen kurz zu prüfen, ob er hochgefahren ist, wird N8N_LISTEN_ADDRESS geändert in 0.0.0.0 oder eine Zeile ergänzt -p 5678:5678, und nach dem Blick wieder vergessen. Der n8n-Editor ist im öffentlichen Netz nur ein Login-Feld; ein Scan-Skript schafft tausende Versuche pro Tag. Meine Instanz lauscht nur auf 127.0.0.1, öffentlich läuft es über nginx 443 – das ist der Normalzustand, nicht für die Fehlersuche auf einen temporären Zustand umstellen und dann so lassen.
Vor dem Posten von Logs einmal durchscannen.Im Startlog steht die vollständige webhook-URL, und der webhook-Pfad selbst ist ein Credential – wer den Pfad hat, kann Daten in deinen Workflow einspeisen; im Stack stehen Installationspfad, interne Adresse, Datenbank-Hostname. Vor dem Posten in Gruppen oder Foren zur Hilfe diese Stellen ersetzen, dann posten.
Datenbankpasswort nicht auf der Kommandozeile angeben.docker run -e DB_POSTGRESDB_PASSWORD=xxx Es bleibt in der shell history und erscheint auch in der Ausgabe von docker inspect , für jeden auf derselben Maschine, der docker-Befehle ausführen kann, sichtbar. Stattdessen --env-fileverwenden oder systemd- EnvironmentFile=, Dateirechte 600. Die zuvor gezeigte unit ist genau so geschrieben, das Passwort steht in /etc/n8n/instance-ai.env , nicht in der unit.
Kurzfassung
Startfehler sehen vielfältig aus, tatsächlich sind es nur vier Abschnitte: Schlüssel, Datenbank, Listener, Migration. Wo das Log stoppt, entscheidet, welchen Befehl du eingeben solltest – Raten ist nutzlos – der Satz „läuft vielleicht bereits ein weiteres n8n" ist gezielt irreführend.
Drei Befehle reichen aus:ss -ltnp 'sport = :端口' Platzhalter finden,nc -vz host 端口 Konnektivität prüfen,curl /healthz/readiness Bereitschaft prüfen. Der Rest ist Nachschlagen in der Tabelle dieses Artikels anhand der Original-Fehlermeldung.
Eine letzte Erfahrung:n8n ready on 和 Editor is now accessible via Der Abschnitt dazwischen wird am leichtesten als bereits erledigt angesehen. Neustart, bevor die Migration abgeschlossen ist, oder gar Stromausfall – das ist eine der teuersten „Kleinigkeiten", die ich je gesehen habe.
Weiter geht es
Der vorherige Artikel ist„Der erste Workflow: Manuell auslösen → Feld bearbeiten → Code", dort kannst du einen Ablauf von Grund auf aufbauen. Wer noch nicht installiert hat, schaut in„Wie man n8n installiert", wer die Oberfläche nicht kennt, blättert in„Interface-Tour". Vereinzelte Fehleraufzeichnungen habe ich zusammengestellt inFehlerbehebungSeite, das Inhaltsverzeichnis des gesamten Kurses befindet sich inhier。
Referenzmaterialien
- Monitor n8n:
/healthzNur die Prozessverfügbarkeit prüfen,/healthz/readinesserfordert, dass die Datenbank verbunden und die Migration abgeschlossen ist - Deployment-Umgebungsvariablen:
N8N_PORTStandard 5678,N8N_LISTEN_ADDRESSStandard::、N8N_USER_FOLDERder Zweck - Database-Umgebungsvariablen:
DB_TYPEStandard sqlite,DB_POSTGRESDB_PORTStandard 5432, sowie die automatischen Wiederherstellungsparameter bei Verbindungsabbruch im laufenden Betrieb - Logs-Umgebungsvariablen:
N8N_LOG_OUTPUTStandardmäßig console, nach Konfiguration auf file landen die Logs in<n8n 目录>/logs/n8n.log - Use the command line:
n8n start、n8n export:workflowDiese serverseitigen Befehle erfordern größtenteils nicht, dass n8n läuft - Install with Docker: Port-Mapping des offiziellen run-Befehls und
/home/node/.n8n卷 - Install with npm: Node-Versionsbereich 20.19 bis 24.x
- Node.js errors:
EADDRINUSE、ECONNREFUSED、EACCES、EADDRNOTAVAILdie jeweiligen Definitionen
Zuletzt aktualisiert: 30. Oktober 2026, verwendet wurde n8n 2.43.7.



