Cómo investigar los errores de inicio de n8n y la ocupación de puertos


El n8n del lado del servidor no arranca, es un tipo de fallo relativamente fácil de diagnosticar: siempre te deja una línea de error. El problema es que esa línea de error a menudo apunta en la dirección equivocada. Para escribir este artículo, levanté un http.server con python para ocupar el port, y n8n igualmente me dijo «¿ya hay otro n8n ejecutándose?».
A continuación clasifico los fallos de arranque en cuatro categorías según «en qué línea se detiene el log», y a cada una le acompaño un comando que puedes ejecutar de inmediato. Los textos de error originales están tal cual salieron de mi propia máquina con 2.43.7, sin cambiar una sola palabra.
Escrito para quienes hacen self-hosting: los instalados globalmente con npm, los que corren en Docker y los gestionados por systemd cuentan. Quienes usan la versión cloud pueden saltárselo, ahí el arranque no depende de ti. Solo hay un requisito previo: que puedas entrar al shell de la máquina o ver los logs del container.
- El arranque es un flujo de cuatro etapas; en qué etapa se detiene el log determina qué investigar
- Port ocupado: tres comandos, más un mensaje engañoso
- No arranca aunque el port no esté ocupado: dirección mal escrita, permisos insuficientes
- ECONNREFUSED: quién te está rechazando exactamente
- La línea «SQLite package has not been found installed»
- No se puede escribir en el directorio .n8n
- Mi orden real de diagnóstico
- Cómo saber que realmente arrancó
- Ese «el servicio rechazó la conexión» en la interfaz
- Consulta rápida de seis textos de error originales
- Tres recordatorios de seguridad
El arranque es un flujo de cuatro etapas; en qué etapa se detiene el log determina qué investigar
Recuerda primero cómo se ve un arranque normal, de lo contrario al ver un log a medias no sabrás qué parte falta. Este es un arranque completo en mi máquina, comenzando desde un directorio vacío:
No encryption key found - Auto-generating and saving to: /data/n8n/.n8n/config
Initializing n8n process
n8n ready on 127.0.0.1, port 5678
Migrations in progress, please do NOT stop the process.
Starting migration InitialMigration1588102412422
Finished migration InitialMigration1588102412422
Editor is now accessible via:
La línea «No encryption key found» solo aparece en el primer arranque, después la clave ya está escrita en .n8n/config y no se imprime más. La clave y la base de datos son un par; si cambias la clave, todas las credenciales almacenadas en la base de datos quedan indescifrables, eso es otro tema, aquí solo hay que recordar que pertenece a la primera fase del arranque.
Divido todo el flujo en cuatro bloques, cada uno con una forma de error completamente distinta al fallar:
| Orden | Qué está haciendo | Error típico cuando falla este bloque |
|---|---|---|
| 1 | Leer archivo de configuración, cargar o generar clave de cifrado | EACCES: permission denied, mkdir、Failed to load command "start" |
| 2 | Conectar a la base de datos, con 5 reintentos integrados | Initial database connection attempt N failed: connect ECONNREFUSED、SQLite package has not been found installed |
| 3 | Iniciar escucha HTTP | n8n's port 5678 is already in use、n8n webserver failed, exiting listen EADDRNOTAVAIL |
| 4 | Ejecutar migraciones de base de datos, levantar task runner | Migrations in progress Después ya no hay ni una línea Finishedy el proceso desaparece |
Hay un detalle que se malinterpreta con especial facilidad:n8n ready on 127.0.0.1, port 5678 no equivale a poder usarse. Aparece en Migrations in progress Antes, el port ya estaba abierto, la base de datos todavía se estaba actualizando. En este momento es normal que el editor no abra al recargar; espera a que termine la migración.
En la cuarta sección hay además algo que solo existe en 2.x: el nodo Code no se ejecuta en el proceso principal, n8n inicia otro n8n task-runner. Se puede ver la relación padre-hijo con ps.
# ps -o pid,ppid,etime,cmd -p 1053,7782
    PID    PPID   ELAPSED CMD
   1053       1  6-09:37:45 n8n start
   7782    1053  6-09:33:32 n8n task-runner
El proceso principal está, el runner no está, la interfaz principal abre, pero al ejecutar el nodo Code da error. Ante este síntoma no pienses en el código, primero ps mira si el runner está presente.
Port ocupado: tres comandos, más un mensaje engañoso
Primero veamos qué dice n8n. Cuando choca con el port no lanza un montón de stack trace, solo una frase en lenguaje llano, y luego el proceso sale con código de salida 1:
n8n's port 5678 is already in use. Do you have another instance of n8n running already?Esta frase desvía el ochenta por ciento de la atención hacia "otro n8n". La realidad es: lo que ocupa el port puede ser cualquier cosa. Tomé python3 -m http.server 5693 ocupé el 5693, y al apuntar n8n al 5693, sigue diciendo esta misma frase. Adivinar no sirve, hay que investigar.
# ss -ltnp 'sport = :5678'
State  Recv-Q Send-Q Local Address:Port Peer Address:Port Process
LISTEN 0      511        127.0.0.1:5678      0.0.0.0:*    users:(("n8n start",pid=1053,fd=24))
ss Viene incluido en Debian, Ubuntu y CentOS, la salida es la más limpia y además da directamente el pid. Si no quieres recordar la sintaxis de filtrado,lsof también vale, solo que el nombre del proceso llevará escape:
# lsof -i :5678 -sTCP:LISTEN
COMMAND    PID USER   FD   TYPE DEVICE SIZE/OFF NODE NAME
n8nx20st 1053 root   24u  IPv4  33852      0t0  TCP localhost:5678 (LISTEN)
n8nx20st No son caracteres corruptos,x20 es un espacio, el nombre real es n8n start. La primera vez que lo ves pensarás que es algún programa desconocido, no te alarmes. Si solo quieres el pid,fuser lo más sencillo:
# fuser -n tcp 5678
5678/tcp:             1053
Obtén el pid,ps -o pid,etime,cmd -p <pid> mira cuánto tiempo lleva ejecutándose. Este paso permite distinguir dos situaciones completamente diferentes.
Una es que tu proceso antiguo no ha muerto.Lo dejaste en systemd stop , o docker rm , y el proceso sigue colgado en segundo plano. Un n8n con etime de varias horas es básicamente eso. La forma limpia es primero systemctl stop n8n, luego usar kill, no kill -9de inmediato — si matas a la fuerza una migración a medio escribir, la base de datos puede quedar atascada en un estado de semi-actualización, y eso solo se salva restaurando una copia de seguridad.
La otra es que otro servicio ha ocupado tu port.En un servidor cloud es muy común que ports como 8080 o 3000 sean ocupados silenciosamente por un panel o por algún pequeño servicio Node. En este caso solo hay dos caminos: que el otro ceda el lugar, o cambiar tú de port.N8N_PORT=5679 Cambiarlo toma un minuto, pero no cambies solo un lugar — el reverse proxy,WEBHOOK_URL、N8N_EDITOR_BASE_URL los ports hardcodeados en él también fallarán, y es así como los webhook dejan de recibirse.
Hay otra situación que parece un conflicto de ports, pero en realidad es un problema de dirección de escucha. El N8N_LISTEN_ADDRESS valor por defecto de n8n es ::, dual-stack, también cubre IPv4. Así que otros solo ocupan 127.0.0.1:5678, si arrancas n8n con los valores por defecto, tampoco levanta. Lo probé: python solo estaba bindeado a 127.0.0.1:5694, n8n arrancó en 5694 con la dirección por defecto, y el error seguía siendo "port 5694 is already in use".
Dicho de paso,:: activar todo trae otro problema: n8n queda expuesto directamente en todas las interfaces de red, incluida la pública. En mi máquina está al revés, solo escucha en local, y hacia fuera lo dejo a nginx.
Environment=N8N_HOST=127.0.0.1
Environment=N8N_LISTEN_ADDRESS=127.0.0.1
Environment=N8N_PORT=5678
Environment=N8N_PROTOCOL=http
Aunque el port no esté ocupado, tampoco arranca: dirección mal escrita, permisos insuficientes
El port está libre, por qué no arranca. Dos causas son las más comunes, y los errores no se parecen en nada.
La primera, la dirección de escucha no existe en la máquina local. Cambiaste de sala de servidores, reconstruiste la instancia, el DHCP renovó y cambió la IP, y esa IP vieja en el archivo de configuración ya no la reconoce nadie:
n8n webserver failed, exiting listen EADDRNOTAVAIL: address not available 10.9.9.9:5679Esto lo saqué escribiendo N8N_LISTEN_ADDRESS como 10.9.9.9, esa máquina no tiene esa dirección en la interfaz de red. Si ves EADDRNOTAVAIL no revises el port, ve a ip addr para ver qué IPs tiene realmente la máquina local, o simplemente escribe 127.0.0.1。
La segunda, permisos. Los ports menores de 1024 requieren root, o requieren CAP_NET_BIND_SERVICE esta capability. Este error lo lanza Node, no viene envuelto por n8n, así que trae un fragmento de node:events de stack:
node:events:505
    throw er; // Unhandled 'error' event
    ^
Error: listen EACCES: permission denied 0.0.0.0:80
    at Server.setupListenHandle [as _listen2] (node:net:2306:21)
No recomiendo arrancar n8n en el 80 por comodidad. Una capa de reverse proxy te da demasiadas cosas: renovación de certificados, gzip, rate limiting, lista blanca de IPs, todo más fácil que lo que trae n8n por sí mismo, y para cambiar la configuración no hace falta reiniciar n8n. Si de todas formas hay que usar el 80 directamente, entonces da los permisos como es debido. Mi propia máquina la tengo corriendo como root, por comodidad; en una máquina compartida por varias personas no lo recomiendo — en n8n están guardadas las credenciales de todos tus servicios de terceros, y si amplías los permisos del proceso, lo que se puede llev ar por delante se amplía igual.
ECONNREFUSED: quién te está rechazando realmente
Este error en realidad lo emite n8n en la segunda fase del arranque: se conecta a la base de datos, nadie responde en el port del otro lado y el kernel devuelve directamente un RST. n8n reintenta 5 veces, con intervalos de 1 segundo, 2 segundos, 4 segundos, 8 segundos y 16 segundos, unos 31 segundos en total, y luego abandona y sale.
Initial database connection attempt 1 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 1000ms
Initial database connection attempt 2 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 2000ms
Initial database connection attempt 3 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 4000ms
Initial database connection attempt 4 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 8000ms
Initial database connection attempt 5 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 16000ms
There was an error initializing DB
There was an error initializing DB
Error: There was an error initializing DB
    at Start.exitWithCrash (/usr/lib/node_modules/n8n/src/commands/base-command.ts:361:28)
El fragmento anterior lo obtuve cambiando DB_TYPE a postgresdb y apuntando el port deliberadamente al 5433, donde nadie escucha; está copiado tal cual.There was an error initializing DB Que aparezca dos veces seguidas también es real, no es que haya copiado mal; si ves líneas repetidas, no dudes de ti mismo.
Hay que entender bien los reintentos: son reintentos de «conexión a la base de datos al arrancar», no un «esperar para siempre». Si ves attempt 1, no te apresures a reiniciar, espera 31 segundos; si ves que fallan los 5 intentos, entonces de verdad no hay conexión, y reiniciar cien veces da lo mismo.
El port en la dirección es la única pista útil.DB_POSTGRESDB_PORT Por defecto es 5432; si aparece 5433 significa que lo configuraste tú, y lo más probable es que copiaras una configuración y olvidaras cambiarla; si aparece 127.0.0.1:5432 pero tú tienes la base de datos instalada en otra máquina, significa que la variable de entorno no surtió efecto: en systemd Environment= una línea mal escrita, en Docker -e que falte una, y ocurre esto.
El caso más traicionero está en el container. n8n corre en un container y la configuración dice DB_POSTGRESDB_HOST=127.0.0.1, este 127.0.0.1 es el loopback del propio container, no el del host. Si la base de datos corre en el host, desde el container no hay forma de conectarse, y el error sigue siendo ECONNREFUSED, idéntico a «la base de datos no está iniciada». O metes la base de datos también en el compose y usas el nombre del servicio como host, o haces que el container reconozca la dirección del host.
Verificar la conectividad desde fuera es mucho más rápido que adivinar en los logs de n8n:
# nc -vz 127.0.0.1 5678
Connection to 127.0.0.1 5678 port [tcp/*] succeeded!
# nc -vz 127.0.0.1 5433
nc: connect to 127.0.0.1 port 5433 (tcp) failed: Connection refused
Si nc conecta y n8n sigue sin poder conectarse, el problema está en las credenciales y el nombre de la base de datos; mira los logs de postgres, no des vueltas en el lado de n8n.
La línea «SQLite package has not been found installed»
Este es el error más fácil de malinterpretar en la segunda sección de arranque, y me pasó a mí. Aparece en el escenario SQLite por defecto — es decir, cuando la gran mayoría instala n8n por primera vez. El log se ve así:
Initial database connection attempt 1 failed: SQLite package has not been found installed. Try to install it: npm install sqlite3 --save. Retrying in 1000ms
Initial database connection attempt 2 failed: SQLite package has not been found installed. ...
...
Error: There was an error initializing DB
DriverPackageNotInstalledError: SQLite package has not been found installed. Try to install it: npm install sqlite3 --save.
    at SqliteLibrary.loadLibrary (/usr/lib/node_modules/n8n/node_modules/@n8n/typeorm/dist/driver/sqlite-pooled/SqliteLibrary.js:30:19)
Es fácil dejarse llevar por el último bloque de la pila y pensar que «fallo al inicializar la DB» significa que la base de datos está rota. La primera línea en realidad lo deja claro:sqlite3 Este módulo nativo no está. Al instalar n8n con npm se compila un módulo nativo; un entorno de compilación incompleto, haber actualizado Node a una versión mayor, o haber añadido al instalar el paquete --ignore-scripts, harán que esta pieza falte. Este fragmento de log está entre dos arranques exitosos de mi máquina; en su momento no anoté qué paso lo arregló, solo sé que no tiene nada que ver con la base de datos en sí.
Hay tres caminos de solución, ordenados de menor a mayor coste: instalar bien el entorno de compilación (python3、make、g++) y luego reinstalar n8n; o activar N8N_REINSTALL_MISSING_PACKAGES=true, para que instale por su cuenta los paquetes que falten al arrancar, ya sea en el Dockerfile o en systemd; si no quieres complicarte, cambia a la imagen Docker, donde estos módulos nativos ya vienen compilados. La frase del error npm install sqlite3 --save está pensada para el escenario de «n8n instalado como dependencia local»; copiarla tal cual en una instalación global puede no funcionar.
De paso, anoto el requisito de versión: n8n requiere Node 20.19 a 24.x; fuera de este rango, Node dará todo tipo de problemas extraños con módulos nativos. Mi máquina tiene 24.21.0.
No se puede escribir en el directorio .n8n
El fallo de la primera sección de arranque, con EACCES 和 mkdiren el error, indica que ni siquiera puede crear su propio directorio de datos..n8n El directorio guarda el archivo de base de datos, la clave de cifrado y la configuración; si el directorio no es escribible, no arranca en absoluto:
No encryption key found - Auto-generating and saving to: /root/n8n_noperm/.n8n/config
Error: Failed to load command "start"
Error: EACCES: permission denied, mkdir '/root/n8n_noperm/.n8n'
    at mkdirSync (node:fs:1410:26)
    at InstanceSettings.loadOrCreate (/usr/lib/node_modules/n8n/node_modules/n8n-core/src/instance-settings/instance-settings.ts:353:12)
Aquí hay una trampa:Primero imprime «no hay clave, generando y guardando en cierta ruta», y solo después falla. Mirando solo la línea anterior, uno pensaría que todo va bien, pero en realidad no se escribió ni una palabra. El criterio es uno solo — si después hay Editor is now accessible via, si no lo hay, no arrancó.
Este fragmento lo ejecuté con el usuario nobody, con el directorio destino bajo /root y lo que se imprime, nadie puede escribir ahí. En operación real lo más común es Docker: el n8n dentro del container se ejecuta con el usuario node de uid 1000, y en el host el directorio que mkdir si es root 700, al hacer mount da este error. La solución es corregir el propietario del directorio del host, no llenar de permisos:
chown -R 1000:1000 /srv/n8n-datachmod 777 puede hacer que arranque, no lo recomiendo. Ese directorio contiene archivos de claves de cifrado, cualquier usuario de la misma máquina puede leerlos, es como colgar la llave de todas las credenciales de terceros de la base de datos en el pomo de la puerta.
Mi orden real de diagnóstico
Cuando hay problemas no empieces a leer desde la primera línea del log, sigue este orden, en cinco minutos localizas el segmento:
- Mira el estado del servicio.
systemctl status n8nOdocker ps -a. Lo importante no es si está active o failed, sinoRestartel número de veces yRestarting (1) 3 seconds agoeste tipo de bucle. Un bucle indica que arranca y muere repetidamente, ve a los logs, no te entretengas con systemd. - Busca los logs.Primero prueba
journalctl -u n8n -n 50. En mi máquina devuelve-- No entries --, porque en la unit la salida está redirigida a un archivo:StandardOutput=append:/data/logs/n8n.out.log. En este caso directamentetail -100 /data/logs/n8n.out.log. Docker esdocker logs --tail 100 n8n。 - cuenta cuántas veces se ha reiniciado.
grep -c 'n8n ready on' /data/logs/n8n.out.log, en mi máquina es 30. El log se escribe en modo append, todo el historial está ahí; si el mismo error aparece repetidamente es un bucle de arranque. - Comprueba el port.
ss -ltnp 'sport = :5678', y compara con lo de arriba. - Verifica la salud.
curl -s http://127.0.0.1:5678/healthz. Si el proceso está vivo responderá{"status":"ok"}, esto no mira la base de datos.
El del paso 2 journalctl devuelve vacío, lo que fácilmente hace pensar que el servicio no escribe logs en absoluto. El servicio claramente está gestionado por systemd, pero los logs están en un archivo. Así que primero systemctl cat n8n mira si hay redirección, es más rápido que ponerse a rebuscar en los logs.
En el lado de Docker hay dos pasos más:docker ps -a La columna STATUS mostrará Restarting (1) 3 seconds ago, el número entre paréntesis que sigue subiendo indica reinicios repetidos; si los ports no coinciden, revisa primero docker port n8n, que listará el host port y el container port. En mi caso está instalado con npm, los mensajes de error dentro del container no los he reproducido manualmente, estas líneas están escritas según el comportamiento habitual de docker.
Cómo determinar que realmente ha arrancado
Que el port esté escuchando no significa que pueda trabajar. n8n tiene dos endpoints de comprobación listos para usar, cuya diferencia es muy práctica:
# curl -s -o /dev/null -w '%{http_code}n' http://127.0.0.1:5678/healthz
200
# curl -s http://127.0.0.1:5678/healthz
{"status":"ok"}
# curl -s -o /dev/null -w '%{http_code}n' http://127.0.0.1:5678/healthz/readiness
200
/healthz 200 solo indica que el proceso puede responder, no consulta la base de datos./healthz/readiness es lo que confirma «la base de datos está conectada y las migraciones también han terminado». En las decenas de segundos tras el reinicio, el primero puede ya estar en 200 mientras el segundo aún no ha llegado, eso significa que las migraciones siguen ejecutándose. Al escribir scripts de monitorización usa readiness, no healthz—solo el primero refleja «si esta máquina puede recibir tráfico».
Después de que ambos estén en 200, haz una prueba real:
- Abre el editor, poder iniciar sesión, ver la lista de workflows, que no sea pantalla en blanco con el spinner.
- Ejecuta cualquier workflow con un nodo Code, con éxito. Este paso valida el task runner, que como se mencionó antes suele pasarse por alto.
- Publica (publish) el workflow, haz que se ejecute de verdad una vez, y en el historial de ejecuciones poder ver esta ejecución de producción con estado exitoso.
No omitas el tercer punto. Algunos despliegues tienen el editor funcionando perfectamente, pero a la hora de la verdad no se ejecuta, la causa está en que el worker en modo cola no está conectado, este tipo de problemas solo se exponen al ejecutar de verdad una vez.
Ese «servicio rechaza la conexión» en la interfaz
Cuando el arranque falla no puedes ni entrar a la interfaz, así que esta sección trata de otro caso—n8n ha arrancado, pero lo que está conectado en el workflow no ha arrancado. La dirección de diagnóstico de estos dos fallos es completamente opuesta, no los mezcles.
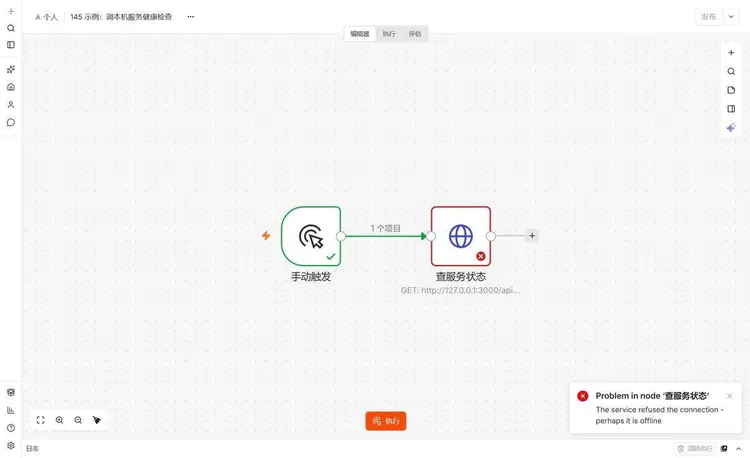
Tras un fallo de ejecución, el nodo en el lienzo aparece en rojo y en la esquina inferior derecha aparece Problem in node '查服务状态', y debajo una línea de texto pequeño The service refused the connection - perhaps it is offline. Esta frase es la versión en lenguaje llano que n8n ha traducido; no menciona el port ni el protocolo.
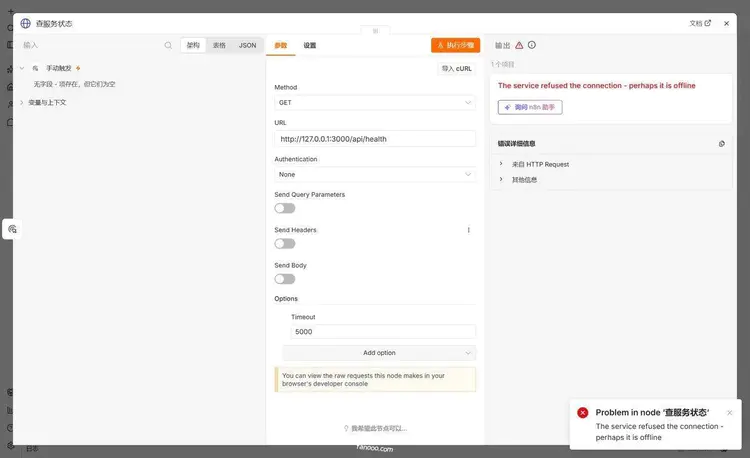
Haz doble clic en el nodo, desplázate hacia abajo en el panel de salida de la derecha y verás un apartado plegable «Detalles del error»; ábrelo para ver la información original.
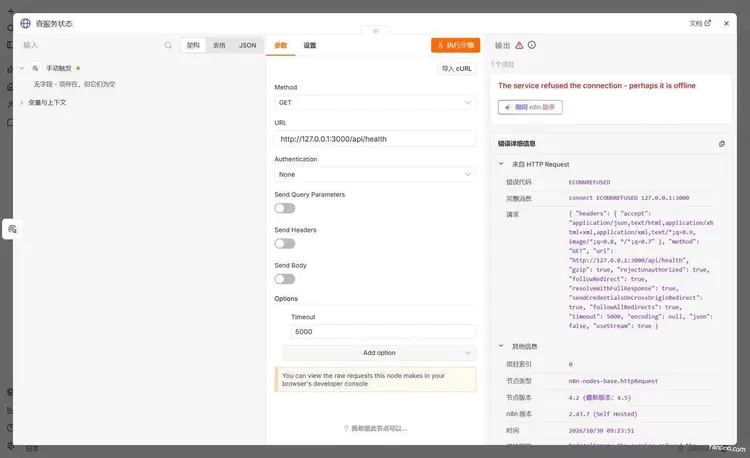
La línea «Código de error» es ECONNREFUSED, y el «Mensaje completo» es connect ECONNREFUSED 127.0.0.1:3000. Hasta aquí coincide con el error de al arrancar: el mismo código de error, solo que esta vez ocurre dentro del nodo. Usa este port para nc -vz, y sabrás de inmediato si hay conectividad.
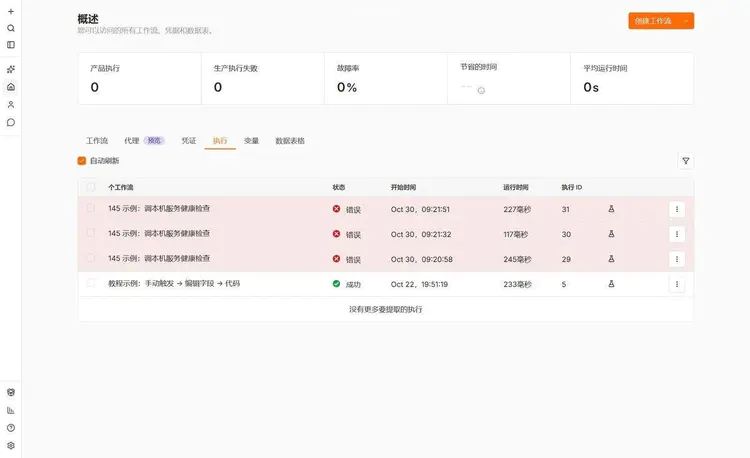
En el historial de ejecuciones hay otro criterio gratuito: el tiempo de ejecución. Mis tres casos fueron 227, 117, 245 milisegundos. Solo cuando ni siquiera se completa el handshake TCP ocurre algo tan rápido; si la otra parte se conecta pero devuelve 500, o hay timeout, el tiempo será de cientos de milisegundos a varios segundos, o incluso llegará al timeout que hayas configurado. Si el error aparece en menos de doscientos milisegundos, piensa directamente en «port/dirección/servicio no iniciado»; pensar en «contenido de respuesta incorrecto» es perder el tiempo.
Consulta rápida de seis mensajes de error originales
| Mensaje de error original | Dónde se atasca | Dirección de resolución |
|---|---|---|
n8n's port 5678 is already in use... |
Tercer párrafo, port | ss -ltnp 'sport = :5678' Buscar el pid, detener el antiguo o cambiar el port |
n8n webserver failed, exiting listen EADDRNOTAVAIL |
Tercer párrafo, dirección | La IP en la configuración no existe en esta máquina,ip addr Verificar |
Error: listen EACCES: permission denied 0.0.0.0:80 |
Tercer párrafo, permisos | Los ports inferiores a 1024 requieren privilegios, cambiar el port o añadir capacidades |
Initial database connection attempt N failed: connect ECONNREFUSED |
Segundo párrafo, base de datos | Esperar a completar 5 reintentos, luego nc -vz host port |
DriverPackageNotInstalledError: SQLite package has not been found installed |
Segundo párrafo, dependencias | 补 sqlite3, o reinstalar n8n |
EACCES: permission denied, mkdir '/.../.n8n' |
Primer párrafo, directorio | El propietario del directorio de datos es incorrecto, cambiar el owner, no 777 |
Tres recordatorios de seguridad
La escucha que se relajó temporalmente durante la investigación, recuerda revertirla.Para echar un vistazo desde fuera y ver si arrancó, cambia N8N_LISTEN_ADDRESS a 0.0.0.0 o añade una -p 5678:5678, y olvídalo después de mirar. El editor de n8n en la red pública es solo un formulario de inicio de sesión; un script de escaneo puede probar miles de veces al día. Mi máquina solo escucha en 127.0.0.1, la red pública va por nginx 443, este es el estado normal, no lo cambies a un estado temporal por troubleshooting y lo dejes así.
Pasa un escaneo antes de publicar los logs.Los logs de arranque contienen la URL completa del webhook, y la ruta del webhook en sí es una credencial; con la ruta se puede inyectar datos en tu flujo de trabajo; el stack contiene rutas de instalación, direcciones de intranet, nombres de host de base de datos. Antes de publicarlo en un grupo o enviarlo a un foro para pedir ayuda, reemplaza estos datos y luego publica.
No escribas la contraseña de la base de datos en la línea de comandos.docker run -e DB_POSTGRESDB_PASSWORD=xxx Quedará en el shell history y también aparecerá en docker inspect la salida de , cualquiera en la misma máquina que pueda ejecutar comandos docker la verá. Usa --env-file, o el EnvironmentFile=de systemd, permisos de archivo 600. La unit que se publicó antes está escrita así, la contraseña está en /etc/n8n/instance-ai.env , no en la unit.
Resumen
El fallo de arranque parece muy variado, pero en realidad son cuatro tramos: clave, base de datos, escucha, migración. La línea donde se detiene el log determina qué comando debes ejecutar; adivinar no sirve — esa frase de «¿ya hay otro n8n ejecutándose?» está hecha para engañar.
Tres comandos son suficientes:ss -ltnp 'sport = :端口' encontrar al ocupante,nc -vz host 端口 verificar la conectividad,curl /healthz/readiness verificar la preparación. El resto es consultar la tabla de este artículo contra el texto original del error.
Una última lección de experiencia:n8n ready on 和 Editor is now accessible via el tramo entre ambos es el que más fácilmente se da por terminado. Reiniciar antes de que la migración haya terminado, o cortar la energía directamente, es una de las «pequeñas operaciones» de mayor costo que he visto.
A continuación
El artículo anterior es«Primer workflow: disparo manual → editar campos → código», ahí puedes ver cómo montar un flujo desde cero. Si aún no lo has instalado, mira«Cómo instalar n8n», si no estás familiarizado con la interfaz, consulta«Guía de la interfaz». Los registros dispersos de fallos los he organizado enSolución de problemaspágina, el índice de todo el curso está enaquí。
Referencias
- Monitor n8n:
/healthzSolo verificar que el proceso esté vivo,/healthz/readinessrequiere que la base de datos esté conectada y que las migraciones se hayan completado - Variables de entorno de Deployment:
N8N_PORTpor defecto 5678,N8N_LISTEN_ADDRESSpor defecto::、N8N_USER_FOLDERel uso de - Variables de entorno de Database:
DB_TYPEpor defecto sqlite,DB_POSTGRESDB_PORTpor defecto 5432, y los parámetros de recuperación automática tras desconexión en tiempo de ejecución - Variables de entorno de Logs:
N8N_LOG_OUTPUTPor defecto console, tras configurarse como file los logs se guardan en<n8n 目录>/logs/n8n.log - Usa la línea de comandos:
n8n start、n8n export:workflowLa mayoría de estos comandos del lado del servidor no requieren que n8n esté en ejecución - Instala con Docker: el mapeo de puertos del comando run oficial y
/home/node/.n8n卷 - Instala con npm: rango de versiones de Node de 20.19 a 24.x
- Errores de Node.js:
EADDRINUSE、ECONNREFUSED、EACCES、EADDRNOTAVAILSus respectivas definiciones
Última actualización: 30 de octubre de 2026, con n8n 2.43.7.



