Workflow, Node, Connection, Execution: cuatro palabras para explicar claramente el mundo de n8n


En el lienzo hay cinco bloques y cuatro líneas. Al exportar esto como JSON, solo quedan dos claves:nodes 和 connections. Los registros de ejecución están en otro lugar, ordenados uno por uno, cada uno con un número.
Los tres lugares hablan de lo mismo, con cuatro palabras: workflow, node, connection, execution. Si estas cuatro palabras quedan claras, leer cualquier tutorial de nodos después será más fácil; si no, estarás chocando una y otra vez entre «claramente hice clic en ejecutar» y «por qué no se ejecutó».
No hace falta saber programar. Basta con que el n8n instalado se pueda abrir y hayas ejecutado un workflow una vez (si no lo has instalado, miraeste artículo, y si aún no estás familiarizado con la interfaz, revisa primeroel recorrido por la interfaz). El mío es 2.43.7; si tu versión menor es distinta, la posición de los botones puede variar un poco.
- Cuatro palabras, cuatro cosas
- Workflow: un container, más dos estados
- Node: el nombre es la clave primaria
- Connection: un array de dos niveles, el primer nivel es el índice de salida
- Execution: una ejecución, con un snapshot
- Viéndolo en conjunto: el orden para una sesión de troubleshooting
- Cómo saber si realmente lo entendiste
- Cinco errores con los que realmente te vas a topar
- Riesgos de exportar, compartir y dejar rastro
Cuatro palabras, cuatro cosas distintas
Primero ponemos una tabla comparativa; las secciones siguientes la desglosan.
| 词 | Qué es | Dónde reside | Relación de cantidad |
|---|---|---|---|
| Workflow | Un grupo de nodes conectados para hacer una cosa | La tabla de workflows en la base de datos, un JSON | 1 workflow tiene N nodes |
| Node | Una unidad de ejecución, hace un paso del trabajo | Del JSON del workflow nodes En el array |
1 nodo pertenece a 1 workflow |
| Connection | Conecta la salida del nodo anterior a la entrada del siguiente | del mismo JSON connections dentro del objeto |
1 workflow tiene N líneas |
| Execution | este workflow se ejecutó una vez | tabla de ejecuciones, independiente del workflow | 1 workflow tiene N ejecuciones |
Lo que más se confunde es la última línea. El workflow es el plano, la ejecución es la obra. Aunque cambies el plano diez veces, la obra ya ejecutada no cambia con él.
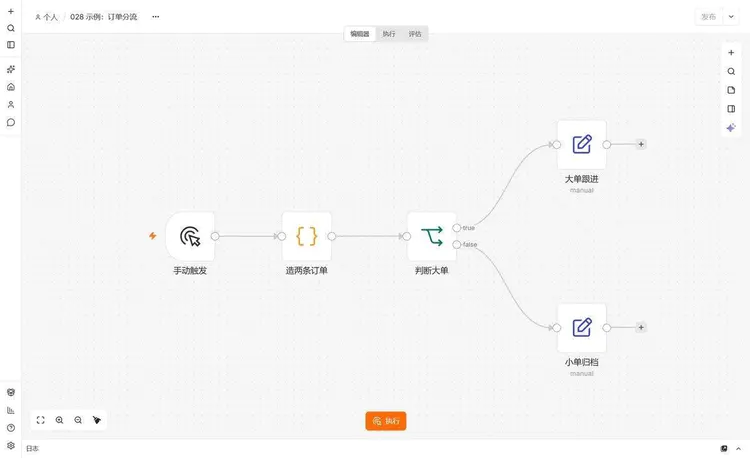
Workflow: un container, más dos estados
La definición oficial es muy breve: un grupo de nodos conectados que automatizan algo; cuando el trigger se activa, haces clic manualmente o otro flujo lo invoca, empieza a ejecutarse, nodo a nodo, y puede bifurcar, fusionar y repetir.
La definición no tiene nada que objetar. Lo que realmente hay que tener en cuenta es ese estado que apareció a partir de 2.x:Borrador y publicado son dos cosas distintas。
Cuando modificas algo en el canvas, n8n lo guarda por su cuenta, persiste en la base de datos en uno a cinco segundos, sin botón de guardar. Pero esto solo lo guarda como borrador. Para que los cambios salgan a producción, hay que pulsar «Publicar» en la esquina superior derecha, fijando una versión concreta a producción. A partir de ahí, los temporizadores, Webhook y eventos de aplicación ejecutan esa versión fijada, no la que ves ahora en pantalla.
Esta regla resuelve un problema antiguo (que un cambio a medias choque con una tarea programada), pero también crea un nuevo riesgo: cambias parámetros y olvidas publicar, lo que corre en producción sigue siendo la lógica de ayer, mientras en el canvas todo parece normal. La primera vez que me pasó me quedé diez minutos comparando las dos versiones de parámetros hasta que recordé que el botón de arriba seguía activo.
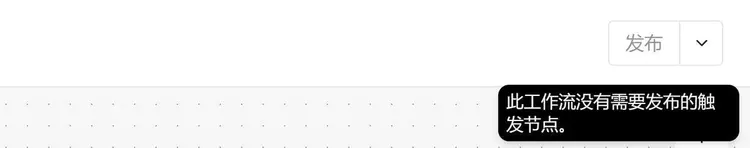
Esto también explica por qué el primer workflow de algunas personas no hay manera de «activarlo». Solo tiene un disparador manual, que por naturaleza no tiene forma de producción, y el botón de publicar permanece siempre gris. Para programarlo, añade un Schedule Trigger; para recibir peticiones externas, añade un Webhook. Con este tipo de disparadores, el botón se activa.
Se ve más claro desde la interfaz: en esta instancia mía, un workflow recién creado active 是 false,activeVersionId 是 null, solo tiene un versionId que va cambiando con cada modificación. Si nunca se ha publicado, no hay versión en producción.
Node: el nombre es la clave primaria
Un nodo es una unidad de ejecución. Algunos se encargan de iniciar (disparadores), otros obtienen datos, envían datos, calculan datos, y otros solo hacen control de flujo, una sola línea IF también puede ser un nodo.
Llevado a JSON, un nodo tiene solo siete cosas:
{
  "parameters": { "jsCode": "return [{ json: { amount: 620 } }];" },
  "id": "n2",
  "name": "造两条订单",
  "type": "n8n-nodes-base.code",
  "typeVersion": 2,
  "position": [-400, 0]
}type: qué tipo de nodo es.n8n-nodes-base.codees el nodo Code,-base.la parte posterior es el nombre del nodo en minúsculas.typeVersion: la versión de la definición del nodo. Distintas versiones de un mismo nodo cambian la estructura de parámetros. En mi caso, IF es2.2, Edit Fields es3.5, Code es2, Manual Trigger es1. Este número no lo rellenas tú, se escribe al crearlo según la definición de ese momento.parameters: todo lo que rellenas en el panel derecho está aquí. Si cambias el tipo de nodo, este bloque se reemplaza por completo.position: coordenadas del canvas, solo para visualización, sin relación con el orden de ejecución.id: identificador corto de uso interno del workflow; al copiar un nodo se genera uno nuevo.
name A simple vista es el más discreto, pero en realidad es el punto de estos cuatro términos donde más fácil se pierde:es la clave primaria. Las conexiones registran el nombre, no el id.
En el canvas cambié «小单归档» por «小单归档(改)», las cuatro conexiones no se rompieron ni una, y tras guardar, el connections en la interfaz también pasó al nuevo nombre — esto lo compensa la UI por ti. Si lo haces de otra forma, cambiando directamente el nameen el JSON sin tocar las conexiones, el servidor lo rechazará en el acto, y el error reporta dos cosas a la vez:
Workflow structure is invalid. nodes[4].name (duplicate_node_name):
Duplicate node name "大单跟进"; connections.判断大单.main[1][0].node
(unknown_connection_target): Connection target "小单归档" does not
reference an existing node
La primera frase dice que hay nombre duplicado, la segunda dice que hay una línea apuntando a un nodo inexistente. Ambas frases son en realidad dos caras de lo mismo: cambiaste un nodo al nombre de otro, y el nombre desplazado sigue siendo apuntado por las conexiones.
Así que el nombre del nodo te sugiero ponerlo como si fuera un nombre de variable: no uses cosas como «Set» o «Code 1», y tampoco lo cambies cada dos días. El nombre puede llevar espacios, paréntesis o chino, n8n lo acepta, pero cuando tú mismo lo escribes en una expresión $('小单归档(改)') es fácil que se te olvide un paréntesis.
Connection: array de dos niveles, el primer nivel es el índice de salida
Conectar es enlazar la salida de un nodo con la entrada de otro. En JSON se ve así:
"connections": {
  "造两条订单": { "main": [[{ "node": "判断大单", "type": "main", "index": 0 }]] },
  "判断大单": { "main": [
    [{ "node": "大单跟进", "type": "main", "index": 0 }],
    [{ "node": "小单归档", "type": "main", "index": 0 }]
  ]}
}
Léelo por partes: la clave más externa esel nombre del nodo origen;main es el tipo de conexión (flujo de datos normal; en el caso de AI es ai_tool、ai_languageModel estos); elíndice del array interior es la enésima salida; más adentro está la lista de destinos, una salida puede conectar con varios downstream.
Juzgar pedidos grandes tiene dos grupos, así que es [[...],[...]]. El primer grupo corresponde al punto marcado con true en el nodo, el segundo grupo corresponde a false. A primera vista parece que hay demasiados arrays anidados, pero en realidad es «qué salida → a quién conecta».
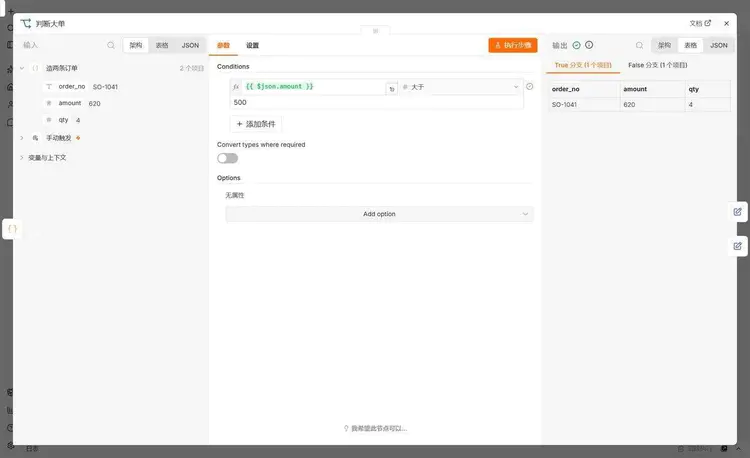
Aquí hay un malentendido conceptual que vale la pena aclarar. Mucha gente piensa que IF es "elegir uno de dos": si la condición se cumple va por un lado, si no se cumple va por el otro, y solo se recorre una rama.
No. IF esenrutamiento por elemento. Le hice recibir dos pedidos, 620 y 180, y el resultado fue 1 elemento en la rama true y 1 elemento en la rama false, ambas líneas se encendieron. Si metes 100 datos, los distribuye a ambos lados según el monto de cada uno, puede que 30 a la izquierda y 70 a la derecha, o puede que 0 en un lado.
Así que cuando dices "los nodos después del IF no se ejecutaron", primero confirma si ese lado simplemente no tenía datos. Eso no es una falla.
Execution: una ejecución, con un snapshot
Una ejecución es que este workflow se corrió una vez. Un clic manual cuenta como una, un disparo del temporizador cuenta como una, una solicitud que llega por Webhook cuenta como una. No forma parte del JSON del workflow, se guarda en otra tabla y se enlaza de vuelta mediante workflowId .
Los campos que me interesan en un registro de ejecución:
| Campo | Valor en este registro | Para qué sirve |
|---|---|---|
id |
35 | Una secuencia autoincremental de toda la instancia, no empieza en 1 para cada workflow |
workflowId |
9biNEw9D0DqWOVV1 | A qué workflow pertenece |
mode |
manual | ¿Se ejecutó manualmente o en producción? |
status |
success | éxito, fallo, cancelado, crash, en espera |
startedAt / stoppedAt |
01:17:42.352 / 01:17:42.513 | una diferencia de 161 milisegundos, eso es el «en 161 milisegundos» que aparece en la interfaz |
workflowVersionId |
un uuid | ¿qué versión se ejecutó esta vez? |
La última línea es fácil de pasar por alto pero muy útil: la ejecución se basa en la versión. Si modificaste los parámetros y no publicaste, producción sigue ejecutando la versión antigua, y el registro de ejecución apunta al id de la versión antigua.
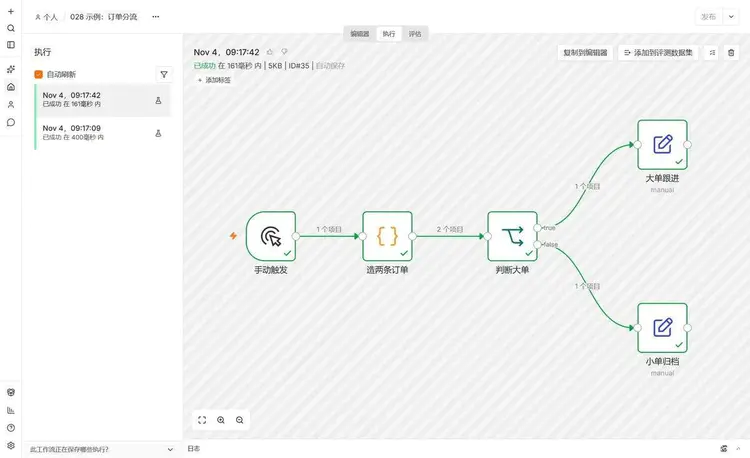
Y un detalle que solo noté esta vez: cada ejecución guarda una snapshot del workflow tal como estaba en ese momento (workflowData). Después de cambiar «archivar pedidos pequeños» a «archivar pedidos pequeños (mod)», volví a revisar la ejecución de las 09:17:42 y el canvas seguía mostrando «archivar pedidos pequeños» — porque el renderizado usa la snapshot propia de esa ejecución, no tu canvas actual.
Esto explica dos cosas. Lo bueno: si cambias parámetros o eliminas nodos, los registros antiguos no se alteran, y al revisar problemas ves exactamente lo que había en ese momento. Lo malo: si comparas un registro antiguo con el canvas actual, los nombres de nodos pueden no coincidir; no creas que te acordaste mal.
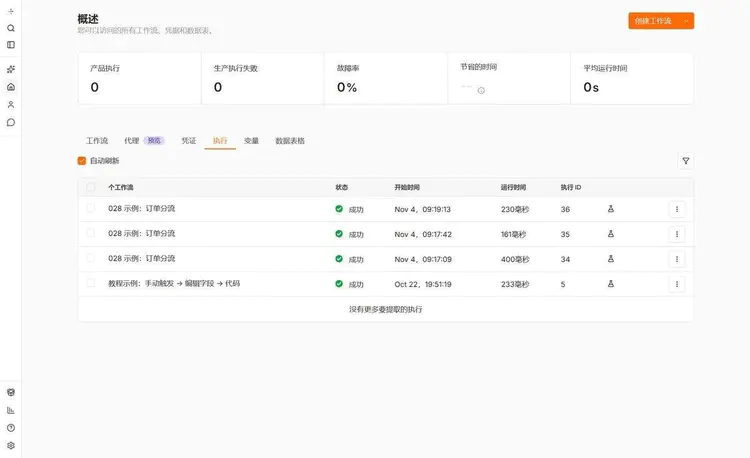
Cuánto tiempo se guardan es un problema práctico. Por defecto se activa la limpieza automática: se eliminan las que superan 336 horas (14 días), y si el total supera 10000 registros también se empieza a borrar desde los más antiguos. Se guardan tanto éxitos como fallos, y también las ejecuciones manuales. La primera regla que se cumpla es la que aplica: un workflow que se ejecuta cada 5 minutos, 288 veces al día, en 14 días acumula 4032 registros, choca primero con la edad; uno que se ejecuta 2000 veces al día, al quinto día llega a diez mil, choca primero con el conteo. Así que «esa ejecución no está en la lista» no significa necesariamente que no se ejecutó, puede que ya se haya limpiado.
Visto en conjunto: el orden para depurar un problema
Las cuatro palabras por separado se entienden, pero al usarlas hace falta un orden. Mi costumbre es ir de fuera hacia dentro:
- Primero mira el estado del registro de ejecución. Si no hay registro, significa que no se disparó en absoluto: el problema está en el trigger o en el estado de publicación, no en los nodos.
- Si el estado es fallido, entra y mira qué nodo está en rojo. En los detalles del nodo mira la entrada; la mayoría de las veces la entrada ya es incorrecta.
- Si el estado es exitoso pero el resultado no es correcto, mira el número de elementos en las conexiones. Si alguna línea es 0, los nodos posteriores lógicamente no harán nada.
- Si los números son correctos pero los campos no, entonces sí toca sospechar de los parámetros del nodo, o de que el upstream cambió el tipo.
La ventaja de este orden es que cada paso descarta un gran abanico de posibilidades. Al contrario, ponerse directamente a mirar el código en el nodo Code suele acabar en media hora perdida solo para descubrir que el upstream envió 0 elementos.
Cómo se considera que realmente se ha entendido
No hace falta memorizar definiciones; basta con hacer tres cosas, y cada una tiene un resultado observable.
Uno, cuenta.Cuántos bloques hay en el lienzo, en el JSON exportado nodes el array debe tener esa misma cantidad. El mío tiene 5, la longitud del array es 5. El número de conexiones es igual, 4 líneas corresponden a connections 4 claves de origen (la condición de pedido grande tiene dos grupos dentro de una clave, pero siguen siendo 4 líneas).
Dos, cambia una línea.Elimina el nodo de la rama false y vuelve a exportar,判断大单 el segundo grupo del array debería convertirse en un array vacío, no desaparecer por completo. Este paso te hace recordar que «la salida está determinada por la posición, no por si hay o no downstream».
Tres, ejecutar dos veces.Después de ejecutar, ve a «Todas las ejecuciones», debería aparecer una más, con un ID mayor que la anterior en 1, y la hora es el momento en que hiciste clic. Cambia otro parámetro, no publiques, ejecuta una vez, y luego ve a la línea (programada o Webhook) para ver si sigue usando los parámetros antiguos — si este es tu negocio real, se recomienda hacer este paso en un flujo de trabajo de prueba.
Cinco errores que realmente ocurren
1. Dos nodos con el mismo nombre.Después de copiar un nodo olvidaste cambiarle el nombre, o editaste el JSON manualmente. Al guardar, el servidor lo rechaza, reportando Duplicate node name, y además lanza un unknown_connection_target. Si ves dos, no te alarmes, solo vuelve a poner un nombre único.
2. Cambiaste el nombre del nodo, pero la expresión no se actualizó.Las conexiones se corrigen automáticamente en la interfaz, las expresiones no. El nodo anterior se llamaba A, y en el downstream usas $('A').item.json.amount para obtener datos; después de renombrarlo a B, esta línea ya no encuentra nada, y el error apunta a la línea de la expresión, no al cambio de nombre.
3. El botón de publicar está gris.El flujo de trabajo solo tiene un trigger manual, no hay nada que pueda publicarse. Al pasar el ratón por encima dice «Este flujo de trabajo no tiene nodos trigger que necesiten publicarse». Agrega un Schedule Trigger o un Webhook para poder publicar.
4. Después de cambiar los parámetros, la tarea programada sigue ejecutando la lógica antigua.Lo que cambiaste es el borrador, no hiciste clic en publicar. Este tipo de problema es el más difícil de diagnosticar, porque el lienzo, los parámetros y la ejecución de prueba están todos correctos, solo el comportamiento en línea es incorrecto.
5. No se encuentran los registros de ejecución.Tres posibilidades: que se hayan eliminado por superar el período de retención, que se haya borrado el workflow y los registros se hayan ido con él, o que se haya desactivado el interruptor de «guardar también los éxitos» (EXECUTIONS_DATA_SAVE_ON_SUCCESS=none). Las dos primeras son las más comunes.
Riesgos de exportar, compartir y dejar rastro
El JSON del workflow se puede exportar completo y enviar a otros. Aquí hay tres puntos por donde se filtran cosas.
Texto en claro en los parámetros.Las credenciales en sí no están en el JSON (solo queda una referencia por nombre), pero parameters puede contener de todo: token en la URL, key escrita a mano en las cabeceras HTTP, path del Webhook.grep una pasada key、token、Bearer y reenviarlo, es cosa de dos minutos.
Los registros de ejecución contienen datos en bruto.Lo que haya ejecutado el nodo se guarda tal cual en el registro: número de pedido, nombre del cliente, dirección, todo está ahí. El autoalojamiento permite controlar el período de retención; reducir EXECUTIONS_DATA_MAX_AGE es la forma más sencilla; en instancias compartidas por varias personas, mejor configurarlo desde el principio.
Pegar directamente un JSON enviado por otro.Pegarlo es ejecutar en tu instancia el código que él escribió; el JS del nodo Code no te pregunta si quieres ejecutarlo. Un workflow de origen desconocido, mételo en una instancia de prueba vacía y revísalo antes de nada.
Resumen
Un workflow es un plano, un nodo es un bloque en el plano, una conexión es una flecha entre bloques, y una ejecución es la vez que se construye siguiendo el plano. Cuatro palabras corresponden a cuatro cosas, sus posiciones son distintas y las consecuencias de modificarlas también: cambiar los parámetros de un nodo afecta a cada ejecución futura, cambiar el registro de ejecución no puede cambiar nada (al fin y al cabo es un registro), cambiar el nombre hace que las conexiones lo sigan pero no necesariamente las expresiones.
Si de verdad tengo que elegir lo que más debería recordarse primero, es esto de «la ejecución lleva snapshot». Explica a la vez por qué los registros antiguos no te engañan, por qué los cambios nuevos no necesariamente surten efecto, y por qué una vez pasado el periodo de limpieza ya no se puede consultar nada.
Para juzgar si uno lo ha entendido, hay un método torpe: abre un workflow hecho por otra persona, sin mirar el canvas, solo el JSON exportado, ¿puedes decir cuántos nodos tendrá al ejecutarse, cuántas rutas, y cuál es la que se ejecuta en vacío? Si puedes decirlo, estas cuatro palabras están superadas.
A continuación
Quienes aún no hayan conseguido ejecutar con éxito su primer workflow, miren primero«El primer workflow: activación manual → editar campo → código», ese artículo explica cómo conectar tres nodos y hacerlo funcionar. Problemas que impiden empezar, como errores al arrancar u ocupación de port, están enaquí. El índice de todo el curso está enesta página, y todo lo relacionado con nodos está bajoesta categoría.
El tipo de trigger más propenso a problemas, el programado, tiene un artículo aparte:El workflow programado no se activa: 5 causas revisadas una por una。
Referencias
- Key concept glossary: definiciones oficiales de workflow, node, execution y publish, que es exactamente a lo que se alinea este artículo
- Understand workflows: qué es un workflow y los cuatro volúmenes de crear workflow, componentes y ejecución
- Connect nodes together: creación y eliminación de conexiones, la salida de un node se conecta a la entrada de otro node
- Save and publish workflows: el rango de tiempo del guardado automático, publish fija la versión en línea, la ejecución de producción usa la versión publicada
- Understand executions: la diferencia entre ejecución manual y de producción, qué ejecuciones cuentan para la cuota
- If: tipos de datos y modos de comparación de las condiciones, dos salidas
- Executions variables de entorno: retención de 336 horas, límite de 10000 registros, tanto éxitos como fallos se almacenan, estos valores por defecto
Última actualización: 4 de noviembre de 2026, usando n8n 2.43.7.



