工作流定时不触发:5 个原因逐个排


凌晨三点的日报没发出来。打开画布,节点都在,触发器上写着「每天早上九点」,执行记录一条没有。你把时间改成两分钟后,盯着屏幕等到天亮,它还是没动。
这种情况我遇到不止一次,原因每次都不一样。有的是压根没发布,有的是时区差了一整天,还有一次是机器在定时那一刻正好在重启。下面按「谁在数时间」这条线拆五种,每种都给一条能自己动手查的证据。
适合已经能画出工作流、点过执行按钮的人。没装过的先看安装那篇,界面不熟的翻界面导览。我这台是 2.43.7,跑在 Debian 上,时区 Asia/Shanghai。
- 先搞清楚:定时这件事分了四层
- 一、没发布,或者发的是老版本
- 二、时区不是你以为的那个
- 三、时间规则本身写错了
- 四、重新发布改了计时起点
- 五、进程不在,停机期间的定时还不会补
- 怎么确认它真的在跑
- 几个真会撞上的报错
- 定时任务自己的风险
先搞清楚:定时这件事分了四层
「定时不触发」这句话本身太粗。它至少包含四个独立环节,任何一层断了,现象都一样:界面正常,什么也没发生。
| 环节 | 谁负责 | 断了的样子 |
|---|---|---|
| 有没有线上版本 | 发布动作 | 画布能跑,执行记录永远空的 |
| 谁在数时间 | 调度器(进程内存里的计时器,或数据库里的队列) | 进程一停就断,断了不补 |
| 按什么时间数 | 时区 + cron 或间隔 | 时间对不上,差几小时或差一天 |
| 到点跑哪一版 | 被钉住的那个发布版本 | 参数改了不生效,跑的还是旧的 |
排错就按这四行从上往下走,比在画布上反复点执行快得多。
一、没发布,或者发的是老版本
这一条占了我见过的故障里一大半。2.x 把「保存」和「发布」拆成了两件事,你在画布上改的东西只是草稿,n8n 自己存,一秒到五秒落库,没有保存按钮。想让定时器认,得点右上角那个发布。
节点面板顶上一句话写得很直白,我原样抄下来:
This workflow will run on the schedule you define here once you publish it.
For testing, you can also trigger it manually: by going back to the canvas
and clicking 'execute workflow'
注意后半句。手动点「执行工作流程」能跑,是因为编辑器直接跑当前草稿,跟定时器走的是两条路。所以「我点了能跑啊」证明不了定时器是活的。
我自己造了一遍
建了个每 20 秒触发一次的工作流,发布,访问日志里立刻出现规律的一串:
09:30:40 09:31:00 09:31:20 09:31:40然后把间隔从 20 秒改成 300 秒,只保存,不发布。接下来的五分钟里,日志照旧:
09:33:20 09:33:40 09:34:00 09:34:20 09:34:40还是 20 秒一条。画布上那个数字明明写着 300。差别在服务端:改完草稿后,工作流的 versionId 换成了新的,activeVersionId 还指着旧的那个。线上跑的一直是被钉住的老版本。
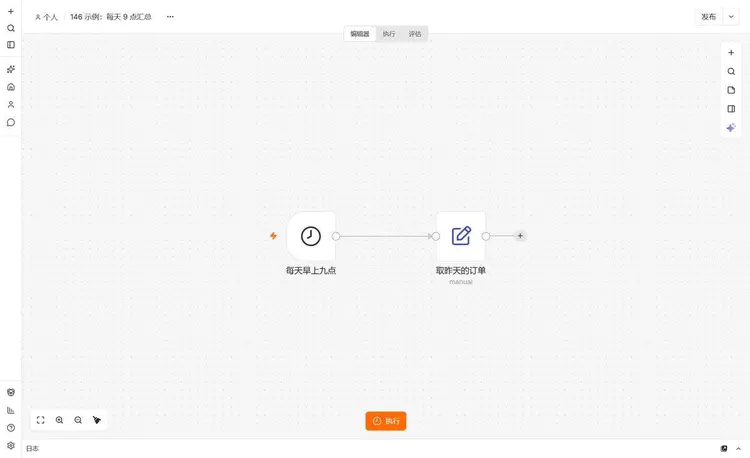
所以看到「发布」两个字亮着,先别急着怀疑时区、cron、服务器。点一下,再看。
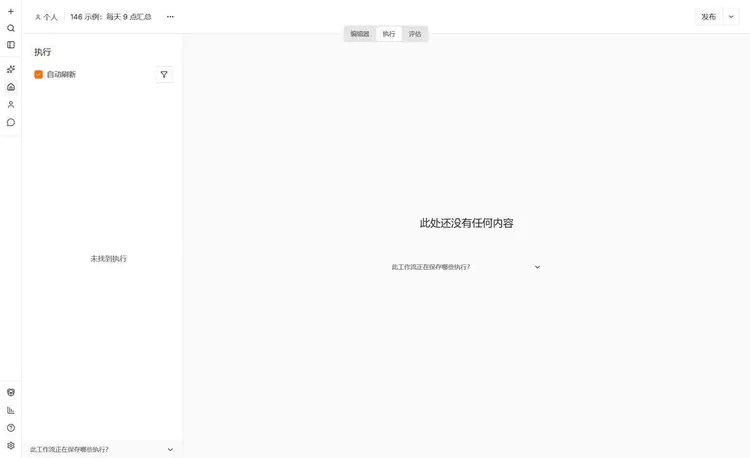
没发布的工作流,执行记录页是下面这样——左栏「未找到执行」,右边一片空白:
还有一种更隐蔽的:发布了,但后来改了参数没重发。界面上一模一样,区别只是 activeVersionId 落后于 versionId。我建议改完参数就顺手点一次发布,别攒着。
二、时区不是你以为的那个
这条最坑人,因为它不报错,只是晚几个小时,或者干脆晚一天。
文档里写得很清楚:Schedule Trigger 依赖时区设置,优先级是「工作流自己的时区」压过「实例时区」;两个都没设,自托管实例默认 America/New_York。
纽约。不是 UTC,不是你机器的时区,是纽约。也就是说,一台什么都没配的服务器上,你写「每天早上 9 点」,实际会在北京时间 21:00 或 22:00 触发(夏令时切换前后差一小时)。很多人第二天发现报表是「昨天晚上」发的,就是这个。
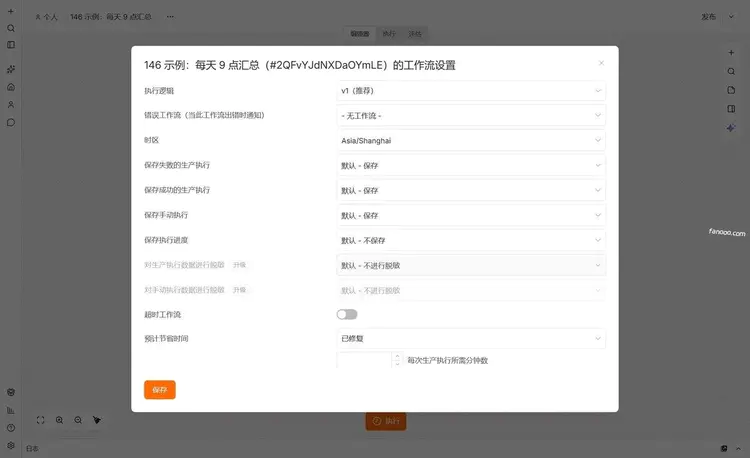
我这台是特意设过的,GENERIC_TIMEZONE 和 TZ 都是 Asia/Shanghai。工作流设置里也能再单独覆盖一层:
怎么一眼看出来是时区问题
看执行记录里的时间,跟你写的时间差多少:
- 差 12 或 13 小时 → 实例还在默认的纽约时区;
- 差 8 小时 → 有人把它当 UTC 用了;
- 差 1 小时 → 夏令时那几天,欧洲某些时区会这样;
- 只差几分钟到几十分钟 → 不是时区,看下一条。
容器部署的人还多一层:宿主机的时区、容器的 TZ、n8n 的 GENERIC_TIMEZONE,三个可以互不相同。Docker 那篇里提过容器里的 Node 版本跟宿主机不是一回事,时区同理,别假设它跟着宿主机走。
三、时间规则本身写错了
n8n 的 cron 是六段,秒在最前面,第六段(星期)可以省。
秒  分  时  日  月  星期
0   30  9   *   *   *     每天 9:30:00
*/10 *  *   *   *   *     每 10 秒
0   0   1   *   *   *     每月 1 号 0 点
从 crontab guru 抄五段过来,位置整体错一位。你以为是「每小时的 30 分」,n8n 读成「每分钟的第 30 秒」。这种错不会报错,只会让你觉得它疯了一样地跑,或者一直不跑。
我拿 30 * * * * 试过一次:激活正常,三分钟内一次没触发。它被当成「每小时第 30 分」,下一次要等到 10:30。这一段我没蹲到整点,不下结论。照文档来:写六段,别省。
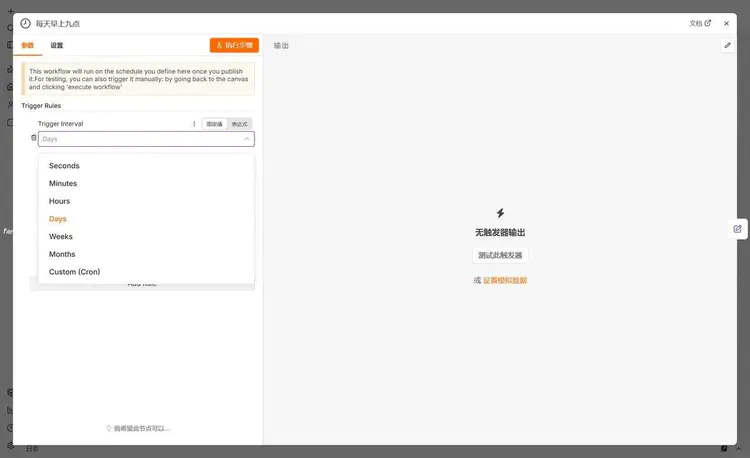
界面上的触发间隔有硬上限,填超了会被拦:秒和分都是 1–59,小时 1–23,天 1–31。所以「每 90 分钟」这种需求在界面上填不出来,只能切到 Custom (Cron) 写 0 */90 * * * * 之类(其实也不对,90 分钟没法用单个 cron 表达,得写两条规则或改用代码算)。
还有一个安静的死角:按月触发时填「31 号」,遇到 2 月、4 月、6 月这些月份,那个月一次都不会跑。文档原话是「If a month doesn't have this day, the node won't trigger」。月报、季度结算这类任务,填 28 号最省心。
另外,一个节点可以挂多条 Trigger Rules,它们是「并集」——每条规定的时间都会触发一次,不是后一条覆盖前一条。想表达「工作日 9 点 + 周末 11 点」,就挂两条,别指望一条写完。
四、重新发布改了计时起点
这条很少有人提,但它能解释一种奇怪现象:你改了间隔,它确实生效了,可时间点跟你算的不一样。
文档写得很直接:触发间隔随时可以改,但只在发布时更新;而且排期是从你发布的那一刻开始算的。原文举的例子是——原本每小时一次、应该在 12:00 跑,你在 11:30 改成两小时一次并发布,下一次是 13:30,也就是发布后两小时。
这解释了两类抱怨:
- 「我改成每天跑一次,结果它在下午三点跑了」——因为你是下午三点发布的。
- 「我设的每 6 小时,怎么时间每天都在漂」——因为起点是发布时刻,不是当天 0 点。
要精确到「每天 9:00」,别用「每 24 小时」,用 cron 0 0 9 * * *。间隔是相对时间,cron 是绝对时间,这两个混用最容易出这种事。
顺带说一个我实测到的细节:20 秒这种能整除 60 的间隔,触发点会落在整分钟的刻度上——09:30:40、09:31:00、09:31:20,毫秒偏移在 20–30ms 之间。所以看到执行记录整整齐齐排队,是正常的,不是假数据。
五、进程不在,停机期间的定时还不会补
前面四条都是配置问题,这条是运行环境问题。它最难查,因为你打开页面一切正常——服务已经起来了,只是中间那段时间的定时永远消失了。
我停了一次机器
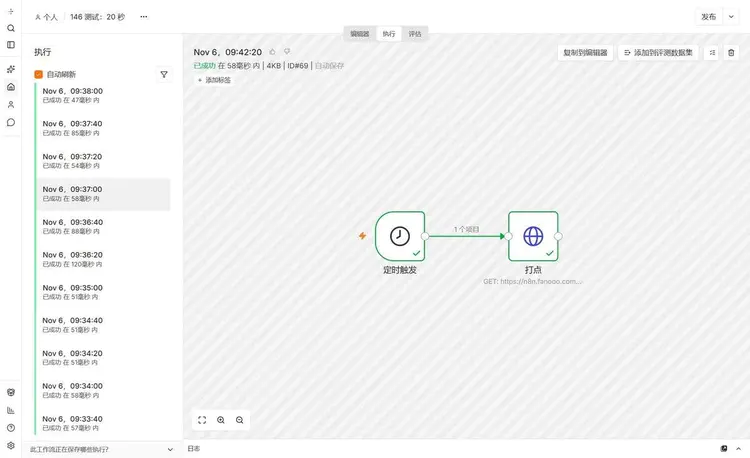
一个每 20 秒跑一次的任务,我 systemctl stop 掉 n8n,等了 45 秒再起。执行记录里是这样的:
09:35:00  已成功
09:36:20  已成功     ← 中间三条没了
09:36:40  已成功
缺的是 09:35:20、09:35:40、09:36:00 三条。恢复后它没有补跑,直接从下一个刻度继续。系统起来要二十来秒,所以 09:36:00 那次也赶不上。
为什么不补
我这台 2.43.7 的定时器跑在进程内存里。数据库里有张表记着每个触发器登记到了哪个调度器,trigger_kind 写的是 in-memory。内存里的计时器,进程一停就没了。文档的原话是「When an instance stops, its in-memory timers go with it. n8n skips any run whose time passed during the downtime rather than catching it up.」
2.45 之后换了做法,把待执行的排期先写进数据库,重启不丢,宽限期内的迟到还会补一次。补不补由节点设置里的 If Execution Is Missed 决定,三个选项:不跑、只补最近一次、每条规则各补最近一次。
这个选项在我的 2.43.7 上也有——节点「设置」页里能改,我截了图:
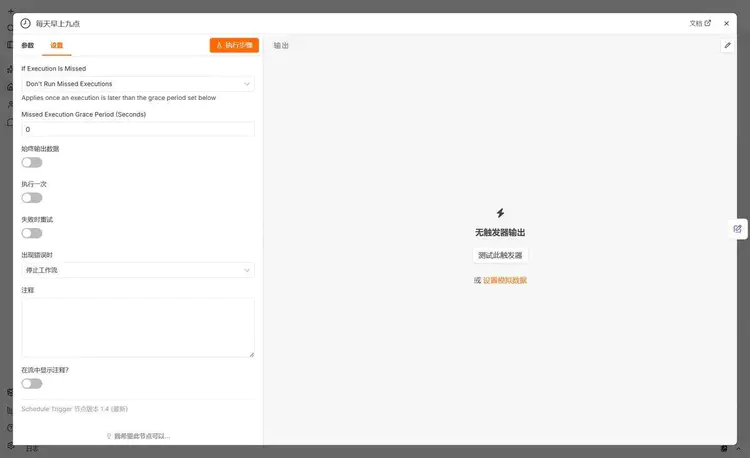
所以我给一个不太受欢迎的建议:2.45 之前别指望补跑,把「漏跑」当成常态来设计。日报停了要有人知道,比事后补数据重要得多。告警那篇还没到,先在工作流末尾加个「失败通知」的错误工作流也行。
还有一种「不在」
队列模式(EXECUTIONS_MODE=queue)下,主进程只负责触发,真正干活的是 worker。worker 没起,定时器照常响,执行记录里会留着一堆一直没开始的条目,看起来像卡住了。查这个看 /rest/settings 里的 executionMode,我这台是 regular,不存在这层。生产上用队列模式的,先确认 worker 进程还活着。
怎么确认它真的在跑
翻执行记录是最直觉的办法,但有两个前提:这个工作流没关掉执行保存,而且你看的是「执行」标签而不是「评估」。生产实例上还有一种情况——执行记录被裁剪策略清掉了,你看到的是空的,任务其实跑得好好的。
所以我更信另一种证据:让任务在 n8n 之外留下痕迹。这次我用的是最土的办法——在工作流末尾接一个 HTTP Request,打自己实例的健康检查地址,带个标记参数:
GET https://n8n.fanooo.com/healthz/ping?tag=146demo然后在服务器的 nginx 访问日志里按标记过滤:
grep 'tag=146demo' /var/log/nginx/n8n-ssl-access.log | tail -6110.42.50.232 - - [06/Nov/2026:09:30:40 +0800] "GET /healthz/ping?tag=146demo" 200
110.42.50.232 - - [06/Nov/2026:09:31:00 +0800] "GET /healthz/ping?tag=146demo" 200
110.42.50.232 - - [06/Nov/2026:09:31:20 +0800] "GET /healthz/ping?tag=146demo" 200一行一个时间,精确到秒,不受执行保存策略影响,也不受分页影响。停机那次缺口,就是从这串日志里先看出来的,回执行记录里一对,一模一样。
三种证据的用法:
| 证据 | 证明什么 | 什么时候不够用 |
|---|---|---|
执行记录里有 trigger 模式的条目 |
定时器响了,而且跑到了最后一个节点 | 保存被关、被裁剪时会为空 |
| 时间戳间隔是否规律 | 间隔参数有没有真的生效 | 只能看已经发生的,看不到下一次 |
| 外部打点日志 | 任务真的动过,且能对齐到秒 | 需要多一个请求,得自己清理 |
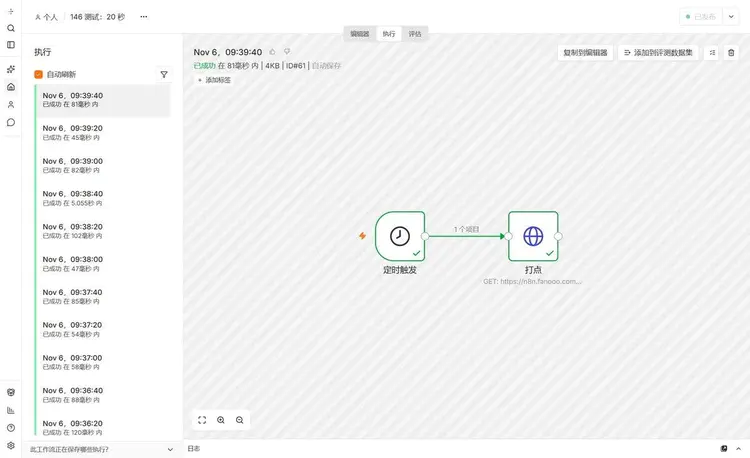
验证完记得把临时工作流删掉。2.x 里删之前得先归档,不然接口会返回「must be archived」,我是先归档再删的。
几个真会撞上的报错
Invalid cron expression。切到 Custom (Cron) 之后表达式解析不了就报这个。文档给的排查法是:先对照官方示例的段数,再把你写的表达式去掉秒那一段,丢到 crontab guru 上验证。剩下五段能过,说明段数对了,问题在第一段。
发布按钮一直是灰的,鼠标停上去提示「此工作流没有需要发布的触发节点」。 只有一个 Manual Trigger 的工作流永远发不出去,它没有生产形态。加一个 Schedule Trigger 或者 Webhook 才亮。这个细节四个词那篇里写过。
用接口发布时报 path: ["versionId"], message: "Required"。 发布这个动作必须指明钉哪一版,接口不会替你猜。我是先 GET 一次拿到 versionId 再提交的。手工在界面上点按钮不会遇到。
执行记录里有一条耗时 5 秒多,其余都是几十毫秒。 那是我重启之后的第一条,进程冷启动还没热起来。不是任务卡住,第二三条就回到 50ms 上下了。
cron 里写了变量,改了没反应。 变量只在发布那一刻求值,之后改设置不会重排。要让它认新值,取消发布再发一次。
定时任务自己的风险
定时器这个东西,配错了不会报错,只会在某个不该跑的时间跑起来。三条具体的:
时区错位的代价不只是「晚了几小时」。凌晨跑批的任务如果落在白天,压的是数据库和上游接口;反过来,白天的任务挪到半夜,第二天早上没人看结果,出了问题要隔一天才发现。上线前把执行记录里的实际时间跟你写的时间对一遍,比读十遍配置管用。
停机漏跑必须人工补。n8n 不会告诉你「昨天少跑了一次」,下游拿着空数据算出来的报表看着是正常的。日切类任务建议在流程里带一个「上次成功时间」的检查,间隔超过预期就报警,而不是闷头跑。
打点用的 URL 别带 token 和密钥。访问日志是明文留档的,我这次只用了 tag= 一个参数,就是不想在日志里留下任何能用的东西。
20 秒一次是我为了几分钟内出结果才这么设的。真实业务里这个频率会把自己和上游一起压住,外部接口基本都会限流。十分钟一次已经算很勤了。
小结
定时不触发,先看右上角是不是还写着「发布」。写着,后面都不用查。
发布过了,就看执行记录里的时间和自己写的时间差多少。差十小时以上是时区,差几分钟是规则,一条都没有是进程或者调度器。
最后记住一件事:2.45 之前,停机期间的定时是直接丢掉的,没有补跑。设计的时候把漏跑当默认,比事后追数据省事。
接着往下
触发器不止定时一种,Webhook、轮询、应用事件各有各的坑,课程目录里按阶段排着:n8n 中文课程目录。
上一篇是 Workflow、Node、Connection、Execution:四个词讲清 n8n 的世界。启动报错和端口占用看 这篇。
参考资料
- Schedule Trigger 节点文档(参数、时区优先级、cron 六段说明)
- Schedule Trigger Common issues(Invalid cron expression、改间隔需重新发布)
- Configure workflow settings(工作流时区、执行保存策略)
- Durable scheduler(内存调度器与数据库调度器的差别、misfire 策略)
- Timezone and localization(GENERIC_TIMEZONE 默认值)
最后更新:2026 年 11 月 6 日,用的是 n8n 2.43.7。