n8nとは何か?基礎から学ぶ入門、ユースケース、学習ロードマップ


ネットで「n8n とは何か」を検索すると、たいていこんな答えが出てくる:オープンソースのワークフロー自動化ツールで、さまざまなアプリをつなげられる。この説明は間違いではないが、何も言っていないに等しい——それが誰の作業を代わりにこなし、あなたのどの時間を節約するのかを教えてくれない。
もっと平たく言えば、n8n は、自分で何度も手作業で繰り返していることを、自動で動く一本のパイプラインに変えるツールだ。
これは一連のコースの最初の記事で、目標はただ一つ:実際に手を動かす前に、それが何か、何ができるか、学ぶ価値があるかをまずはっきりさせることだ。全文を読み終えれば、「自分の手元にあるどの作業を、これに任せるべきか」という一つの問いに答えられるはずだ。
誰に向けた記事か、読む前に必要な準備は何か
自動化の経験がまったくなくても読める。プログラミングができる必要も、サーバーを買う必要も、先にソフトウェアをインストールする必要すらない。この記事では概念と判断の基準だけを扱い、実際に手を動かす部分は次の記事で扱う。
Zapier を使ったことがある、あるいはスクリプトを書いたことがあるなら、第3節と第4節を重点的に読むとよい。そこでは両者の実際の違いを説明しており、乗り換えるべきかどうかの判断に役立つ。
まずはそれが動く様子を見てみよう
概念をいくら説明するよりも、一度見たほうがいい。次の画像は、私があるサーバー上で作った最初の練習用ワークフローで、3つのブロックが左から右へ一度実行され、所要時間は 233 毫秒だった。
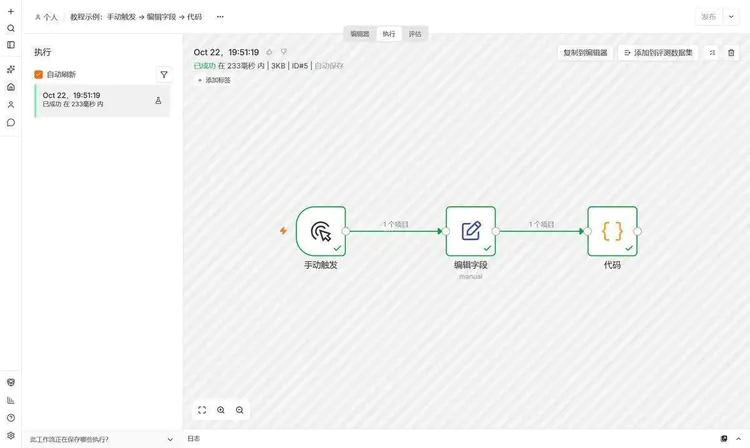
図の中の3つのブロックはノードだ。一番左にある稲妻マーク付きのものが起点で、トリガーと呼ばれ、「この処理がどこから始まるか」を表す;真ん中のものは「フィールド編集」と呼ばれ、2つのフィールドを作り出す役割を担う;一番右はコードノードで、短い JavaScript を実行する。
ブロック間の矢印はデータが流れる方向だ。起点から終点までのこの一連の全体を、次のように呼ぶ:ワークフロー。
このパイプラインがやっていることはとても単純だ:「福州」と「27」という2つの値を作り、一文に組み立てる。しかしこれを実際の業務に置き換えると、「Webページを開いてデータを写し、表に貼り付け、さらにメールを送る」という一連の動作を機械に任せることになる。構造は同じだ。
3つの言葉で十分だ:ノード、接続線、ワークフロー
- ノード(Node):一つの具体的な動作。HTTP リクエストを1つ送る、表の1行を読む、条件を1つ判定する、コードを一区切り実行する、といったことはいずれも1つのノードだ。私のこのインスタンスのノード一覧では、千近い数までスクロールでき、さまざまな一般的なシステムをカバーしている。
- 接続線:誰が先で誰が後かを決める。データは線に沿って下流へ流れ、分岐でき、合流できる。
- ワークフロー(Workflow):ノードと接続線を組み合わせ、一つの物事の完全な流れを作る。これこそが、あなたが n8n の中で作る「プロダクト」だ。
本当のハードルはこの3つの名詞ではなく、一つの概念にある:データがノード間でどのように受け渡されるか。
n8n の中のデータは常に「項目の配列」だ。前のノードが 10 行のデータを取得すると、次のノードに渡るのは 10 個の項目で、次のノードはこの 10 個の項目それぞれに対して一度ずつ実行し、最初の1行だけを処理するのではない。この点を理解すれば、以降の大部分の「なぜ自分の出力は空なのか」という問題は、自分で調べられるようになる。
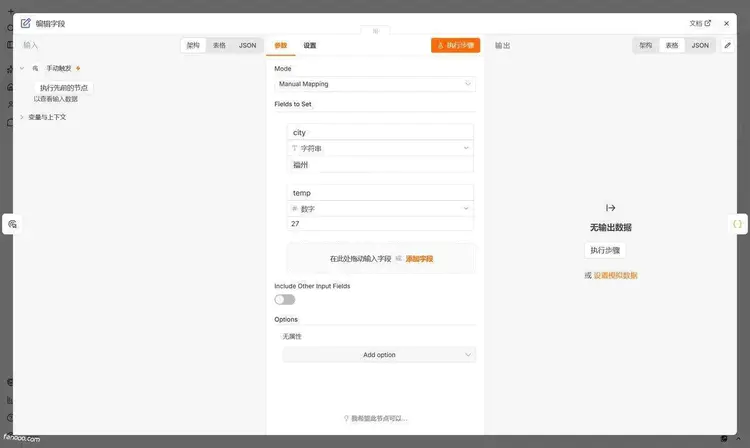
このパネルは n8n 2.x で変更されています。左が入力、中央がパラメータ、右が出力で、デバッグ時にタブを切り替える必要がなく、1.x よりかなり使いやすいです——ネット上の多くの中華語チュートリアルはまだ 1.x の画面のままで、その通りにやると位置が合わず、初心者が最も戸惑いやすい点の一つです。
もう一つ小さな点:このインスタンスは簡体字中国語環境ですが、パラメータ名は依然として英語で、Mode、Fields to Set、Include Other Input Fields といった並びです。n8n の中国語化は外側だけで、ノードのパラメータは翻訳されていません。英語を見ても慌てず、見比べながら入力すれば大丈夫です。
結局何を解決するのか
オフィス内の大部分の繰り返し作業は、本質的に同じことです:データを A から B へ移し、ついでに形を変える。
例を挙げます。顧客が Web サイトでフォームに入力する → あなたが情報を表に転記する → 営業にメッセージを送る → 三日後にフォローを促す。四つのステップで、どれも難しくはありませんが、一日に二十回やると面倒になり、しかも必ず漏れます。
n8n がやるのはまさにこれです:時間どおりに、条件に従って、ミスなくデータを届くべき場所へ送り、ついでに知るべき人へ通知します。
この位置づけは覚えておいてください。データを生成せず、判断も代行しません。これを明確に理解すれば、「今月の売上状況を分析して」と期待することはなくなります——それは n8n にはできず、データベースとスクリプトに頼る必要があります。
Zapier、Make、自作スクリプトと比べて、どこが違うか
| n8n | Zapier | Make | 自分でスクリプトを書く | |
|---|---|---|---|---|
| デプロイ方式 | クラウド版またはセルフホスト | クラウドのみ | クラウドのみ | 自分で決める |
| 課金ロジック | セルフホストは回数課金なし | タスク数に応じて | 操作数に応じて | サーバー代のみ |
| 自由度 | 高、コードも書ける | 中 | 比較的高い | 最高 |
| 習得難易度 | 中 | 最も簡単 | やや急 | 人による |
| 誰が保守を担当するか | 自分 | プラットフォーム | プラットフォーム | 自分 |
実際の感想を少し。Zapier は最も手間が少なく、登録すればすぐ使える。代償はタスク数課金で、量が増えると請求額がかなり厳しくなり、少し込み入ったデータ処理では回避策を考える必要がある。Make は可視化がより強力で、本当の分岐やループを描ける。価格も穏やかだが、UI の学習コストはやや高い。
n8n の違いは2点にある。自分でデプロイでき、データは自分のマシン上にある。タスク数課金ではなく、何回実行しても追加料金は不要で、コストはサーバーだけになる。代償も現実的で、アップグレード、バックアップ、深夜の障害対応をすべて自分で処理する必要がある。これは小さな話ではなく、後で運用保守について專門に説明する。
自分で Python スクリプトを書く場合:より柔軟だが、UI がなく、条件を1つ変えるにはコードを変更する必要があり、問題が起きても実行記録を振り返れない。私の分担はこうだ。一回限りの、ロジックが込み入ったデータ処理はスクリプトを書く。長期的に定時実行し、進捗を人に見せ、複数の外部システムと連携する必要があるものは n8n に置く。
ついでに n8n のライセンスについて。標準的なオープンソースライセンスではなく、fair-code の Sustainable Use License を使っている。自分用、社内用は問題ない。ただし n8n をラップして顧客に販売したい場合は、条項を先にしっかり確認する必要があり、当然だと思うのはやめたほうがいい。
どんなことを任せるのに適し、何を任せるべきでないか
適するものは、基本的に次のような形だ:
- 定時集約:毎朝、いくつかのソースから情報を取得し、重複を除去して朝報を生成する
- イベントトリガー:誰かがフォームを送信した、メールを送った、注文ステータスが変わった場合に、自動で分類し、データベースに格納し、通知する
- システム同期:表計算、データベース、CRM 間で突合し、差異を個別に出力する
- コンテンツパイプライン:取得、クリーニング、AI リライト、人によるレビュー、定時公開
- 監視アラート:サイトが落ちた、API がエラーを返した、データが異常になったときに、誰かが即座に把握できる
- AI 関連の作業:大規模モデルを業務フローに組み込み、分類、抽出、質問応答を行う
適さないものもはっきり言っておく。遠回りを避けられるように:
- 毫秒级の高頻度リアルタイム取引、それはこのために設計されていない
- 複雑な計算とアルゴリズムは、直接コードを書くほうが手間が少ない
- 1か月に1回だけ実行し、手作業で10分のフローは、ワークフローにするとかえって保守が難しくなる
n8n と AI はどんな関係なのか
ここ2年で n8n が人気になったのは、大きな部分で AI の存在による。大規模モデルに接続するノードを内蔵し、Agent を作るためのノードも一通り揃っている。モデルにツールを割り当て、記憶を設定し、どのツールを先に呼ぶかをモデル自身に決めさせる
ただし、加減が重要だ。ワークフローは決定論的であり、条件を満たせば左へ、満たさなければ右へ進み、100回実行しても結果は同じになる。モデルはそうではない。同じプロンプトでも、今日は分類が正しくても、明日は間違うことがある
私の原則は、確定性のあることはノードに任せ、曖昧なことはモデルに任せ、お金や約束に関わる部分は必ず人によるレビューを残すことだ。この原則は、以降の AI 関連記事すべてに通底する
いくら費用がかかるのか
道は2つあり、コスト構造はまったく異なる
公式クラウド版を使う場合:月額課金で、インストールと保守を省ける。価格は公式サイトを基準とする(変更されるため、数字は固定で書かない)。自分でデプロイする場合:ソフトウェア自体は無料で、コストはサーバー1台。2 核 4G で日常タスクを動かすには十分すぎるほどで、一年几百块のマシンで足りる。本当に高いのは時間だ。インストール、設定、アップグレード、トラブルシュートはすべて自分で行う必要がある
クラウドかセルフホストか、どう判断するか
判断基準は実質1つだけだ:そのデータが自分のマシンの外に出せるかどうか
顧客リスト、注文、カルテのようなデータを扱う場合はセルフホストを勧める。公開情報に接続するだけ、RSS 通知を作るだけなら、クラウドのほうが手間が少ない。セルフホストには中国国内特有の落とし穴が2つある。サーバーから国外の API にアクセスできない場合があり、ネットワークを別途処理する必要がある。逆に、クラウド版は社内ネットワークのシステムに入れない。この点は価格よりはるかに重要で、データを取得できないと気づくのは完成後になるまで待つべきではない
これを学ぶにはどんな基礎が必要か
コピー&ペーストができ、表を読めれば始められる。第1段階ではコードを書く必要はまったくない
しかし中盤に進むと2つの壁に突き当たる。1つは JSON で、データがどんな形をしているか、その中の1層をどう取り出すか。もう1つは HTTP で、リクエスト、レスポンス、ステータスコードがそれぞれ何を意味するか。この2つは精通する必要はないが、避けては通れない。さらに先で AI と Agent を作るなら、エラーを読解し、データの問題なのか設定の問題なのかを自分で判断できることが求められる
ゼロから使えるようになるまで、どういうルートをたどるか
私はプロセス全体を 8 つの段階に分解し、各段階には明確な成果物があり、それは以下に書いてある学習ロードマップのページに。ここでは順序に関する3つの注意点だけを挙げる:
- まず n8n を安定してインストールし、それからワークフローを作る。データボリュームを正しく設定していないと、container を削除した時点でワークフローがすべて消える。こういう事例は1度ならず見てきた
- まず手元にある小さなフローを1つ動くようにしてから、新しいノードを学ぶ。ドキュメントを読むだけで成果物を出さなければ、1週間で完全に忘れる
- 焦って AI に手を出さないこと。データフローとエラー処理を理解していないうちにモデルを接続すると、問題の調査が難しくなるだけだ
初心者が最も道を外しやすい4つのポイント
新着ノードを追う。ノードライブラリには1,000近いノードがあり、使わないものはすべてノイズだ。実際に高頻度で使うのは20数個だけ:トリガー、HTTP、フィールド編集、IF、Switch、Merge、ループ、コード。
成功パスだけを実行する。APIはタイムアウトし、レート制限され、500を返す。初めて本番投入したときに痛い目を見る人は、ほぼここでつまずく。
実行記録を見ない。エラー時はまず実行記録で最初に赤くなったノードを確認する。グループチャットで人に聞くよりずっと速い。
n8nをローコードプラットフォームとして扱う。コードは書けるが、強みは計算ではなく調整にある。重い処理はスクリプトやデータベースに任せる。
セキュリティ上の注意
セルフホストのn8nは、あなたの複数システムの鍵をこのマシン上に置くことに等しい。三つは必ず守る:ドメインを紐付けてHTTPS化し、5678ポートをインターネットにむき出しにしない;n8n用のAPI Keyには必要十分な権限だけを付与する;バックアップ時にn8nの暗号化キーを漏らさない——キーを失うとデータベース内の認証情報は復号できず、データだけあっても復元できない。
まとめ
n8nは繰り返し作業をパイプラインに変えるツールだ。その価値はノードの数ではなく、「この作業はどうやるべきか」を書き下した後、n8nが毎日それに従って実行し、忘れも漏れもしないことにある。
学習の順序は次の三つ:安定して導入する、1つを最後まで動かす、そこから外へ広げる。
次回は具体的な導入方法を扱う:n8nのインストール方法、初心者向けローカルデプロイと初回実行の完全チュートリアル。インストール後に戻ってきて、上記の3ノードのワークフローをもう一度実行すると、かなりスムーズになる。
参考資料
最終更新:2026年10月22日、使用バージョンはn8n 2.43.7。そちらのバージョンがこれより新しければ、UIはまた位置が変わっているかもしれない。



