Workflow、Node、Connection、Execution:4つの言葉でn8nの世界を明確に説明する


キャンバス上には5つのブロックと4本の線がある。これをJSONにエクスポートすると、キーは2つだけになる:nodes 和 connections。実行記録は別の場所にあり、1件ずつ並んでいて、それぞれに番号が付いている。
3つの箇所が語っているのは同じ事柄で、4つの単語で表される:workflow、node、connection、execution。この4つの単語を整理できれば、以降どんなノードのチュートリアルを読むのも楽になる;整理できなければ、「確かに実行をクリックしたのに」と「なぜ動かないのか」の間で行き来し続けることになる。
コードが書けなくても大丈夫。インストール済みのn8nを開けて、一度workflowを実行したことがあれば十分だ(未インストールならこの記事を見てほしい。インターフェースにまだ慣れていないなら先にインターフェースガイドを読んでほしい)。私の環境は2.43.7で、そちらはマイナーバージョンが異なるとボタンの位置が多少違うかもしれない。
- 4つの単語、4つのもの
- Workflow:1つのコンテナ、外加两个状态
- Node:名前こそが主キー
- Connection:2層の配列で、1層目は出口の番号
- Execution:1回の実行で、1つのsnapshotを伴う
- つなげて見る:トラブルシューティングの順序
- どうなれば本当に理解したと言えるか
- 本当にぶつかる5つの間違い
- エクスポート、共有、痕跡が残るリスク
4つの単語、4つのもの
まず対照表を1枚置く。後の数節はそれを分解して説明する。
| 词 | それは何か | どこに存在するか | 数量関係 |
|---|---|---|---|
| Workflow | 一群のノードをつないで1つのことを行う | データベース内のワークフローテーブル、1つの JSON | 1つのワークフローに N 個のノードがある |
| Node | 1つの実行ユニット、1ステップの作業を行う | ワークフロー JSON の nodes 配列の中 |
1 個のノードは 1 つのワークフローに属する |
| Connection | 前のノードの出力を次のノードの入力に接続する | 同じ JSON の connections オブジェクト内で |
1 つのワークフローには N 本の線がある |
| Execution | このワークフローが一度実行された | 実行テーブル、ワークフローとは独立している | 1 つのワークフローには N 件の実行がある |
最も混同しやすいのは最後の行だ。ワークフローは図面、実行は施工である。図面を十回変更しても、以前に施工したものはそれに追随して変わらない。
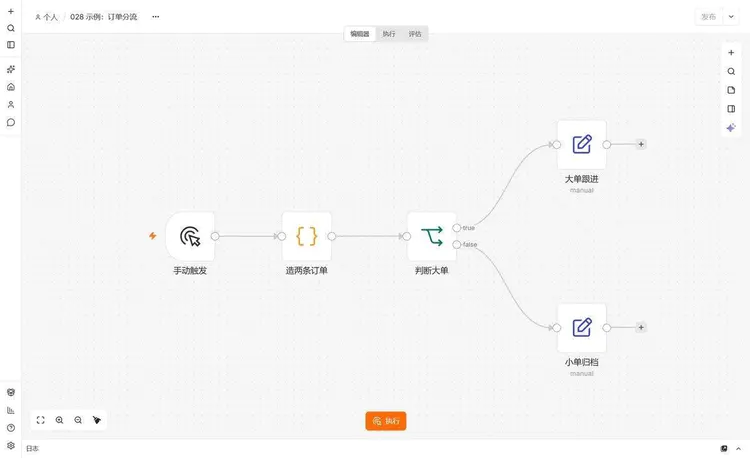
Workflow:一つのコンテナ、外加二つの状態
公式の定義は短い:連なって自動的に何かを完成させる一組のノード;トリガーが鳴った、あなたが手でクリックした、他のフローがそれを呼び出した、それが走り始め、ノードごとに一つずつ実行し、分岐、合流、循環できる。
定義には特に問題はない。本当に注意すべきは 2.x 以降に増えたあの状態である:下書きと公開済みは別物。
キャンバス上で変更すると、n8n が自動保存し、1秒から5秒以内にDBへ書き込まれる。保存ボタンはない。ただしこれは下書きに保存されるだけ。変更を本番に反映するには、右上の「公開」をクリックして、特定のバージョンを本番に固定する必要がある。以降、タイマー、Webhook、アプリイベントが実行するのはその固定されたバージョンであり、今画面に表示されているバージョンではない。
このルールは古い問題(変更途中で定期タスクに衝突される)を解決したが、新たな落とし穴も生んだ。パラメータを変更した後に公開を忘れると、本番では昨日のロジックが動き続け、キャンバス上はすべて正常に見える。初めて遭遇したとき、2つのバージョンのパラメータを10分見比べて、ようやく上のボタンがまだ点灯していることに気づいた。
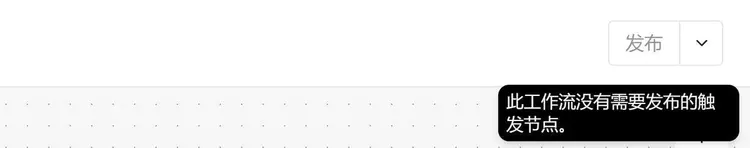
これにより、一部の人の最初のワークフローがどうしても「アクティブ化」できない理由も説明できる。手動トリガーだけでは、本質的に本番形態を持たず、公開ボタンは永遠にグレーのまま。定期実行なら Schedule Trigger を追加し、外部リクエストを受けるなら Webhook を追加する。こうしたトリガーがあって初めて、ボタンが点灯する。
インターフェースから見るとより明確だ。このインスタンス上では、新規作成したワークフロー active 是 false,activeVersionId 是 nullは、1つだけ versionId が毎回の変更に追従して変化している。公開したことがなければ、本番バージョンは存在しない。
Node:名前こそが主キー
ノードは実行単位である。開始を担当するもの(トリガー)、データを取得・送信・計算するもの、フロー制御だけを行うものがあり、1行でも IF ノードになれる。
JSON に落とし込むと、1つのノードは7つの要素で構成される:
{
  "parameters": { "jsCode": "return [{ json: { amount: 620 } }];" },
  "id": "n2",
  "name": "造两条订单",
  "type": "n8n-nodes-base.code",
  "typeVersion": 2,
  "position": [-400, 0]
}type:どの種類のノードか。n8n-nodes-base.codeは Code ノードであり、-base.後ろの部分はノード名の小文字である。typeVersion:ノード定義のバージョン。同じノードでもバージョンが違えばパラメータ構造が変わる。私の这份では IF は2.2、Edit Fields は3.5、Code は2、Manual Trigger は1。この数字はあなたが入力するものではなく、作成時にその時点の定義に従って書き込まれるものだ。parameters:右側パネルで入力したすべてがここに入る。ノードタイプを変えれば、この部分は丸ごと入れ替わる。position:キャンバス座標。純粋に表示用で、実行順序とは無関係。id:ワークフロー内部で使う短い識別子。ノードをコピーすると新しいものが生成される。
name 最も地味に見えるが、実際にはこの4つの用語の中で最も損をしやすい箇所だ:これは主キーだ。接続が記録するのは名前であり、id ではない。
私はキャンバス上で「小单归档」を「小单归档(改)」に変更したが、4本の接続線は1本も切れず、保存後のインターフェース内の connections も新しい名前に変わった——これはUIが代わりに補完したものだ。別の方法として、JSON 内の nameを直接変更し、接続を変えない場合、サーバー側はその場で拒否し、エラーは一度に2つ返る:
Workflow structure is invalid. nodes[4].name (duplicate_node_name):
Duplicate node name "大单跟进"; connections.判断大单.main[1][0].node
(unknown_connection_target): Connection target "小单归档" does not
reference an existing node
1文目は重複名を述べ、2文目は1本の線が存在しないノードを指していると述べる。2つの文は実は同じ事柄の裏表だ:あなたがあるノードを別のノードの名前に変更し、その押しのけられた名前を接続がまだ指しているのだ。
そのため、ノード名は変数名のように付けることをおすすめします。「Set」「Code 1」のような名前は避け、2日おきに変えるのもやめましょう。名前にスペース、括弧、中国語が含まれていてもn8nは認識しますが、自分で式に書く $('小单归档(改)') ときに括弧を1つ漏らしやすくなります。
Connection:2層の配列で、1層目は出口の番号です
接続とは、あるノードの出力を別のノードの入力に接続することです。JSONでは次のようになります:
"connections": {
  "造两条订单": { "main": [[{ "node": "判断大单", "type": "main", "index": 0 }]] },
  "判断大单": { "main": [
    [{ "node": "大单跟进", "type": "main", "index": 0 }],
    [{ "node": "小单归档", "type": "main", "index": 0 }]
  ]}
}分解して読むと、最も外側のキーはソースノード名;main は接続タイプです(通常のデータフロー;AIの場合は ai_tool、ai_languageModel これらです);内側の配列の添字が何番目の出口かを表します;さらに内側はターゲットのリストで、1つの出口から複数の下流に接続できます。
大単判断には2つのグループがあるため、それは [[...],[...]]です。第1グループはノード上の true が付いた円点に対応し、第2グループは falseに対応します。ざっと見ると配列が余分にネストされているように思えますが、実際は「何番目の出口 → 誰に接続するか」というだけです。
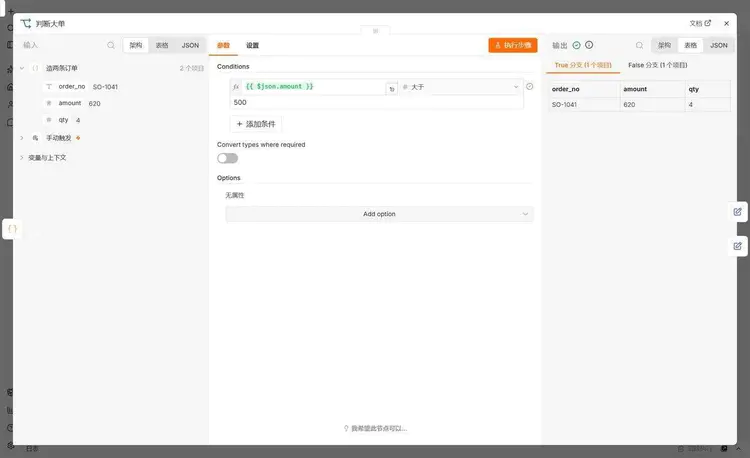
ここには概念上の誤解があるので、噛み砕いておく価値がある。多くの人は IF を「二者択一」だと思っている。条件が成立すればこちらへ、成立しなければあちらへ、片方だけ通る、と。
そうではない。IF は条件ごとに振り分ける。2 件の注文、620 と 180 を流したところ、結果は true 分岐が 1 件、false 分岐が 1 件で、両方のラインが点灯した。100 件のデータを入れれば、各データ自身の金額に応じて両側に分かれ、左に 30 件、右に 70 件になることもあれば、片側が 0 件になることもある。
だから「IF の後ろのノードが実行されない」という言葉は、まずその側にそもそもデータがなかったのではないかと確認すべきだ。これは故障ではない。
Execution:1 回の実行、1 つの snapshot を伴う
実行とは、このワークフローが一度走ったということだ。手動で一度クリックすれば 1 回、タイマーが一度鳴れば 1 回、Webhook に 1 つのリクエストが来れば 1 回。これはワークフロー JSON には属さず、別のテーブルに保存され、 workflowId によって紐付けられる。
1 つの実行レコードで私が気にするフィールド:
| フィールド | このレコード内の値 | 何の役に立つか |
|---|---|---|
id |
35 | インスタンス全体で 1 つの自動増加シーケンスであり、ワークフローごとに 1 から始まるわけではない |
workflowId |
9biNEw9D0DqWOVV1 | それがどのワークフローに属するか |
mode |
manual | 手動で実行したのか、本番で実行したのか |
status |
success | 成功、失敗、キャンセル、クラッシュ、待機中 |
startedAt / stoppedAt |
01:17:42.352 / 01:17:42.513 | 161 ミリ秒差、つまり画面上の「161ミリ秒以内に」 |
workflowVersionId |
1 つの uuid | 今回実行されたのはどのバージョンか |
最後の行は見落としやすいが非常に有用だ:実行が認識するのはバージョンである。パラメータを変更して公開していない場合、本番で実行されるのは依然として旧バージョンであり、実行記録に紐づくのも旧バージョンの id である。
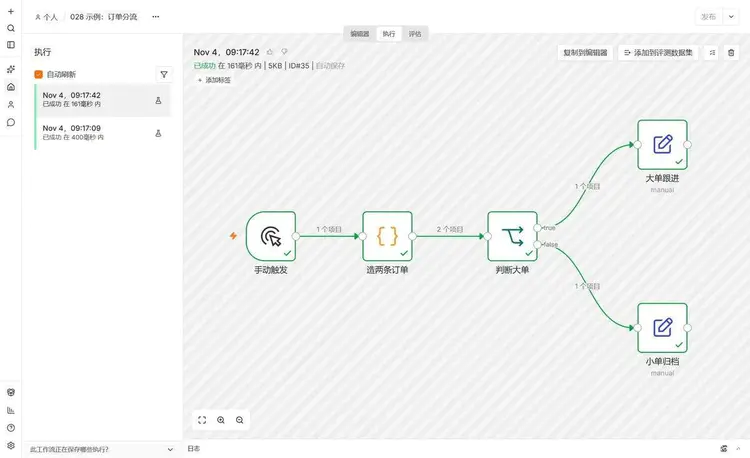
もう一つ今回初めて気づいた細かい点:各実行にはその時点のワークフローのスナップショットが保存されている(workflowData)。「小单归档」を「小单归档(改)」に変更した後、09:17:42 の実行を振り返ると、キャンバス上には依然として「小单归档」と表示されている——レンダリングに使われるのはその実行に付属するスナップショットであり、現在のキャンバスではないからだ。
これは 2 つのことを説明している。良い面:パラメータを変更したりノードを削除しても、古い記録は改ざんされず、問題を後から調査するときに見えるのはその時点の現場そのものだ。悪い面:古い記録を現在のキャンバスと照合すると、ノード名が一致しないことがあり、自分が覚え間違えたと思わないことだ。
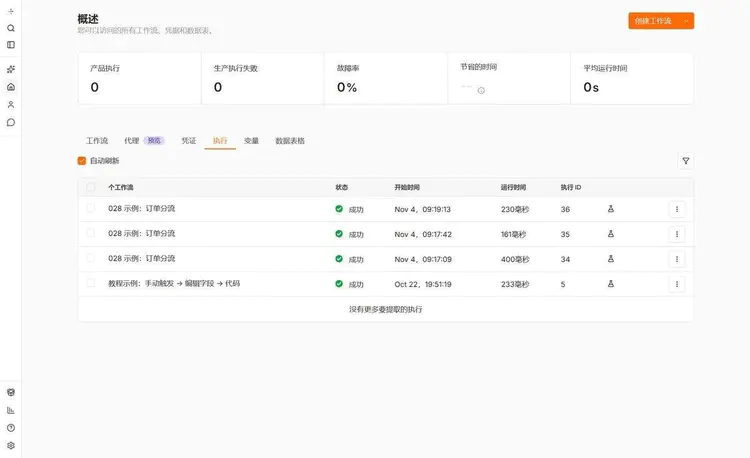
保存期間は現実的な問題だ。デフォルトで自動クリーンアップが有効になっている:336 時間(14 日)を超えたものは削除され、総量が 10000 件を超えた場合も古いものから削除される。成功も失敗も保存され、手動実行も保存される。2 つのルールはどちらが先に該当した方が適用される:5 分ごとに実行されるワークフローは 1 日 288 回、14 日で 4032 件に達し、先に年齢条件に該当する;1 日 2000 回のものは 5 日目に 1 万件に達し、先に件数条件に該当する。したがって「実行リストにあの回がない」というのは、必ずしも実行されなかったのではなく、すでに削除された可能性がある。
まとめて見ると:トラブルシューティングの順序
4つの単語は分けてなら分かるが、使うには順序が要る。私の習慣は外から内へ収束させることだ:
- まず実行記録の状態を見る。記録がなければ、そもそもトリガーされていない——問題はトリガーか公開状態にあり、ノードの中ではない。
- 状態が失敗なら、クリックしてどのノードが赤いか見る。ノード詳細で入力を見るが、多くの場合入力の時点で既に正しくない。
- 状態が成功でも結果が違うなら、接続線上の項目数を見る。ある線が 0 なら、後続のノードは当然何もしない。
- 数字は合っているがフィールドが違うなら、そこで初めてノードパラメータや上流が型を変えたことを疑う。
この順序の利点は、各ステップで大きな可能性の塊を否定できることだ。逆に、いきなり Code ノードのコードを見始めると、30 分見てから上流が 0 件しか送っていないことに気づくことがよくある。
どうなれば本当に理解したと言えるか
定義を暗記する必要はなく、3 つのことをすれば十分で、それぞれに観察可能な結果がある。
一、数える。キャンバス上に四角がいくつあるか、エクスポートした JSON の nodes 配列も同じ数だけあるはずだ。私のものは 5 個で、配列長は 5。接続線の本数も同じで、4 本の線は connections 内の 4 つのソースキーに対応する(大単判断は 1 つのキーに 2 組入っているが、それでも 4 本の線)。
二、線を 1 本変える。false 側のノードを削除してから再エクスポートすると、判断大单 の 2 組目の配列は空配列になるはずで、組全体が消えるのではない。このステップで「出口は位置で決まり、下流があるかどうかでは決まらない」ことを覚えられる。
三、2回実行する。実行が終わったら「すべての実行」に行くと、1件増えているはずで、IDは前のものより1大きく、時刻はクリックした瞬間になっている。さらにパラメータを1つ変更し、公開せずに1回実行し、その後オンライン(スケジュールまたはWebhook)で確認すると、まだ古いパラメータが使われている——これが実際の業務であれば、この手順はテスト用ワークフローで行うことを勧める。
実際にぶつかる5つの誤り
1. 2つのノードが同名になる。ノードをコピーした後に名前を変え忘れる、または手作業でJSONを編集する。保存時にサーバー側が拒否し、次のエラーを報告する Duplicate node name、そして同時に次のメッセージも出す unknown_connection_target。2つ表示されても慌てず、一意の名前に戻せばよい。
2. ノード名を変えたのに、式が追随していない。接続はUIが自動で補うが、式は補わない。前のノードがAという名前で、下流で $('A').item.json.amount を使って値を取得している場合、名前をBに変えるとこの式は何も見つけられなくなり、エラーは名前変更ではなく式の行を指す。
3. 公開ボタンがグレーになっている。ワークフロー内に手動トリガーしかなく、公開できるものが存在しない。マウスを乗せると「このワークフローには公開が必要なトリガーノードがありません」と表示される。Schedule TriggerまたはWebhookを追加して初めて公開できる。
4. パラメータを変更したのに、スケジュールタスクがまだ古いロジックで動く。変更したのはドラフトで、公開をクリックしていない。この種の問題は最も調査が難しく、キャンバス、パラメータ、テスト実行はすべて正常で、オンラインの動作だけがおかしい。
5. 実行記録が見つからない。三つの可能性:保持期間を超えてクリーンアップされた、ワークフローが削除されて記録も一緒に消えた、または「成功時も保存」のスイッチをオフにした(EXECUTIONS_DATA_SAVE_ON_SUCCESS=none)。前の二つが最もよくある。
エクスポート・共有・痕跡に関するリスク
ワークフロー JSON は丸ごとエクスポートして他人に送ることができる。ここに三箇所、情報が漏れるポイントがある。
パラメータ内の平文。クレデンシャル本体は JSON の中にはない(名前の参照だけが残る)が、 parameters の中には何でもあり得る:URL に付いた token、HTTP リクエストヘッダに手書きした key、Webhook の path。grep 一遍 key、token、Bearer そのまま送信する、二分の手間。
実行記録には生データが入っている。ノードが実行した内容は、そのまま原文が記録に残る。注文番号、顧客名、住所もすべて。セルフホストなら保持期間を自分で制御できるので、 EXECUTIONS_DATA_MAX_AGE を小さくするのが一番手軽な方法;複数人で共用するインスタンスなら、最初から設定しておくのがよい。
他人から送られた JSON をそのまま貼り付け。貼り付けた時点で、あなたのインスタンス上で彼の書いたコードが実行される。Code ノード内の JS は実行するかどうかを聞いてこない。出所不明のワークフローは空のテストインスタンスに投入して、確認してから使う。
まとめ
ワークフローは図面、ノードは図面上のブロック、接続はブロック間の矢印、実行は図面に従って施工するその一度。四つの言葉は四つのものに対応し、位置が違い、変更の結果も違う:ノードパラメータを変えると以後の毎回の実行に影響し、実行記録を変えても何も変わらない(そもそも記録なのだから)、名前を変えると接続はついてくるが式はそうとは限らない。
あえて最も先に覚えるべきものを一つ挙げるなら、「実行はスナップショットを伴う」ということだ。これはなぜ古い記録があなたを騙さないのか、なぜ新しい変更が必ずしも反映されないのか、なぜクリーンアップ期間を過ぎると何も調べられなくなるのかを同時に説明してくれる。
自分が理解したかどうかを判断するには、愚直な方法がある:他人が作ったワークフローを適当に開き、キャンバスを見ずにエクスポートした JSON だけを見て、それが動いたときにノードがいくつ、経路がいくつ、どれが空実行かを言えるかどうか。言えれば、この四つの言葉は合格だ。
続きは
まだ最初のワークフローを走らせたことがない人は、まず『最初のワークフロー:手動トリガー → フィールド編集 → コード』を見てほしい。あの記事は三つのノードをつないで走らせる方法を説明している。起動エラー、ポート占有など門に入れない問題はここ。コース全体の目次はこのページにあり、ノード関連はすべてこのカテゴリの下にある。
トリガーの中で最も問題が起きやすい定時タイプについては、別に一本書いた:ワークフローの定時トリガーが発火しない:5 つの原因を一つずつ潰す。
参考資料
- Key concept glossary:workflow、node、execution、publish 这几个词的公式定義、本文が揃えているのはここ
- Understand workflows:ワークフローとは何か、およびワークフロー作成、コンポーネント、実行の4ブロックの分冊
- Connect nodes together:接続の作成と削除、あるノードの出力を別のノードの入力に接続する
- Save and publish workflows:自動保存の時間範囲、公開はバージョンをオンラインに固定する、本番実行は公開済みバージョンを使用する
- Understand executions:手動実行と本番実行の違い、どの実行がクォータに計上されるか
- If:条件のデータ型と比較方法、2つの出力
- Executions 環境変数:336 時間保持、上限 10000 件、成功と失敗の両方を保存するこれらのデフォルト値
最終更新:2026年11月4日、n8n 2.43.7を使用。



