n8n の起動エラーとポート占有の調べ方


サーバー側の n8n が起動しないのは、比較的調べやすい種類の障害だ——必ずエラー行を一行残してくれる。厄介なのは、そのエラー行がしばしば誤った方向を指すことだ。この記事を書くために、私は python で http.server を起動して port を占有したが、n8n はそれでも「別の n8n がすでに動いていないか」と告げてきた。
以下では「ログがどの行で止まるか」によって起動失敗を四種類に分け、それぞれにすぐ叩けるコマンドを一つ添える。エラー原文はすべて私の手元の 2.43.7 上で出力されたもので、一字も変えていない。
セルフホストする人向け:npm でグローバルインストールしたもの、Docker で動かすもの、systemd で管理するものすべてを含む。クラウド版を使う人は飛ばしてよい、そちらの起動はあなたが気にする番ではない。前提条件は一つだけ、マシンの shell にログインできるか、container のログを見られることだ。
- 起動は四段の流れで、ログがどの段で止まるかで調べる内容が決まる
- port が占有されている:三つのコマンドと、人を騙す一言のヒント
- port が占有されていなくても起動しない:アドレスの書き間違い、権限不足
- ECONNREFUSED は一体誰があなたを拒否しているのか
- 「SQLite package has not been found installed」の那条
- .n8n ディレクトリに書き込めない
- 私の実際の調査順序
- 本当に起動したとどう判断するか
- 画面の中のあの「サービスが接続を拒否しました」という一言
- 六つのエラー原文早見表
- 三つのセキュリティ上の注意
起動は四段の流れで、ログがどの段で止まるかで調べる内容が決まる
まず正常起動時のログがどんなものかを覚えておく。そうでないと、途中までのログを見てもどこが欠けているのか全く分からない。これは自分のマシンでの完全な起動ログで、空のディレクトリから始まる:
No encryption key found - Auto-generating and saving to: /data/n8n/.n8n/config
Initializing n8n process
n8n ready on 127.0.0.1, port 5678
Migrations in progress, please do NOT stop the process.
Starting migration InitialMigration1588102412422
Finished migration InitialMigration1588102412422
Editor is now accessible via:
「No encryption key found」の行は初回起動時のみ表示され、その後キーは .n8n/config に書き込まれ、以降は出力されない。キーとデータベースは対になっており、キーを変えるとDBに保存された認証情報はすべて復号できなくなる。それは別の記事の話で、ここでは起動の第一段階に属するということだけ覚えておけばよい。
フロー全体を4つのブロックに分けた。各ブロックで失敗したときのエラー形態は全く異なる:
| 順序 | 何をしているか | この段階で落ちたときの典型的なエラー |
|---|---|---|
| 1 | 設定ファイルを読み、暗号化キーをロードまたは生成する | EACCES: permission denied, mkdir、Failed to load command "start" |
| 2 | データベースに接続する。5回のリトライが組み込まれている | Initial database connection attempt N failed: connect ECONNREFUSED、SQLite package has not been found installed |
| 3 | HTTPリスニングを開始する | n8n's port 5678 is already in use、n8n webserver failed, exiting listen EADDRNOTAVAIL |
| 4 | データベースマイグレーションを実行し、task runnerを起動する | Migrations in progress その後は一行も出力されず Finished、プロセスが消える |
非常に誤判定しやすい細かい点がある:n8n ready on 127.0.0.1, port 5678 は使用可能を意味しない。それは Migrations in progress 以前、port はすでに開いていて、ライブラリはまだアップグレード中。この時点で editor を開いても開けないのは正常で、migration が終わるまで待つ。
第4段落には 2.x だけにあるものもある:Code ノードは main process では実行されず、n8n は別に1つ起動する n8n task-runner。ps で親子関係を見れば分かる。
# ps -o pid,ppid,etime,cmd -p 1053,7782
    PID    PPID   ELAPSED CMD
   1053       1  6-09:37:45 n8n start
   7782    1053  6-09:33:32 n8n task-runner
main process はいて、runner がいないと、main UI は開けるが、Code ノードを実行するとすぐエラーになる。この症状を見たら code を疑わず、まず ps runner がいるかを見る。
port が占有されている:3つの command、plus 1つの人を騙す hint
まず n8n 自身がどう言うかを見る。port 衝突時は stack の列を出さず、人間の言葉1行だけ出して、process は終了し、exit code は 1:
n8n's port 5678 is already in use. Do you have another instance of n8n running already?この文は8割の注意力を「別の n8n」に引く。実際は:port を占有しているのは何でもあり得る。私は python3 -m http.server 5693 で 5693 を占有し、n8n を 5693 に向けても、やはりこの文を言う。推測は無駄、調べる。
# ss -ltnp 'sport = :5678'
State  Recv-Q Send-Q Local Address:Port Peer Address:Port Process
LISTEN 0      511        127.0.0.1:5678      0.0.0.0:*    users:(("n8n start",pid=1053,fd=24))
ss Debian、Ubuntu、CentOS に標準搭載で、出力が最もきれいで、pid も直接出る。filter 構文を覚えたくなければ、lsof でもよい。ただし process 名に escape が付く:
# lsof -i :5678 -sTCP:LISTEN
COMMAND    PID USER   FD   TYPE DEVICE SIZE/OFF NODE NAME
n8nx20st 1053 root   24u  IPv4  33852      0t0  TCP localhost:5678 (LISTEN)
n8nx20st 文字化けではなく、x20 は space で、本当の名前は n8n start。初めて見ると見知らぬ program かと思うが、慌てない。pid だけ欲しければ、fuser が一番楽:
# fuser -n tcp 5678
5678/tcp:             1053
pid を取得し、ps -o pid,etime,cmd -p <pid> それがどれくらい動いているかを見る。このステップで全く異なる二つの状況を切り分けられる。
一つは自分の古いプロセスが死んでいないケース。systemd で stop した、あるいは docker rm したのに、プロセスがまだバックグラウンドに残っている。etime が数時間を示す n8n なら、まずそれだ。クリーンなやり方は先に systemctl stop n8nし、その後で killする。いきなり kill -9しないこと——移行の途中で強制 kill されると、データベースがアップグレード途中の状態で止まり、バックアップからの復元でしか救えなくなる。
もう一つは別のサービスが自分の port を占有しているケース。クラウドホスト上で 8080、3000 这样的 port がパネルやある Node の小サービスにこっそり占有されるのはよくある。この場合、道は二つだけ:相手に譲ってもらうか、自分が port を変えるか。N8N_PORT=5679 変更自体は一分で済むが、一箇所だけ変えてはいけない——リバースプロキシ、WEBHOOK_URL、N8N_EDITOR_BASE_URL にハードコードされた port も一緒にずれ、webhook が受け取れないのはそういう理由からだ。
もう一つ、port 競合に見えて実は listen アドレスの問題というケースもある。n8n の N8N_LISTEN_ADDRESS のデフォルト値は ::、デュアルスタックは、IPv4 も一緒に覆ってしまう。だから他人が占有しているのは 127.0.0.1:5678、デフォルト値で n8n を起動しても、同じく起動しない。実測済み:python は 127.0.0.1:5694 しかバインドしておらず、n8n をデフォルトアドレスで 5694 に起動すると、やはり「port 5694 is already in use」と報告される。
ついでに言うと、:: 全開にすると別の問題が生じる:n8n がすべてのネットワークインターフェースに直接露出し、公衆網のものも含まれる。私のマシンでは逆の書き方で、ローカルのみをリッスンし、外部は nginx に任せている。
Environment=N8N_HOST=127.0.0.1
Environment=N8N_LISTEN_ADDRESS=127.0.0.1
Environment=N8N_PORT=5678
Environment=N8N_PROTOCOL=http
ポートが占有されていなくても起動しない:アドレスの書き間違い、権限不足
ポートが空いているのに、なぜまだ起動しないのか。最も多いのは2つの原因で、エラーの見た目はまったく似ていない。
1つ目は、リッスンアドレスがローカルに存在しない。データセンターを変更したり、インスタンスを再構築したり、DHCP のリース更新で IP が変わったりすると、設定ファイル内の古い IP は誰にも認識されなくなる:
n8n webserver failed, exiting listen EADDRNOTAVAIL: address not available 10.9.9.9:5679これは私が N8N_LISTEN_ADDRESS を 10.9.9.9 と書いて出力したもので、そのマシンのネットワークインターフェースにこのアドレスはない。 EADDRNOTAVAIL を見たらポートを調べるのをやめて、 ip addr でローカルに実際にどの IP があるか確認するか、いっそ 127.0.0.1。
と書く。2つ目は、権限。1024 未満のポートには root が必要か、 CAP_NET_BIND_SERVICE このケーパビリティが必要。この層のエラーは Node が投げるもので、n8n がラップしたものではないため、 node:events のスタックトレースが付く:
node:events:505
    throw er; // Unhandled 'error' event
    ^
Error: listen EACCES: permission denied 0.0.0.0:80
    at Server.setupListenHandle [as _listen2] (node:net:2306:21)
手間を省くために n8n を 80 で起動することは勧めない。リバースプロキシを1層挟むだけで得られるものは多い:証明書の更新、gzip、レート制限、IP ホワイトリストは、n8n 自身の仕組みより気が楽で、設定変更時に n8n を再起動する必要もない。どうしても 80 を直接使うなら、きちんと権限を与えること。自分のマシンは root で動かしていて、手間を省くためだが、複数人で共用するマシンではこうするのは勧めない——n8n にはすべてのサードパーティサービスの認証情報が保存されており、プロセスの権限が大きくなれば、持ち出せるものもそれに応じて大きくなる。
ECONNREFUSED は一体誰があなたを拒否しているのか
このエラーは実は n8n が起動の第2段階で出している:データベースに接続しに行き、相手のポートで誰も応答しないため、カーネルが直接 RST を返す。n8n は 5 回リトライし、間隔は 1 秒、2 秒、4 秒、8 秒、16 秒、前後約 31 秒で、その後諦めて終了する。
Initial database connection attempt 1 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 1000ms
Initial database connection attempt 2 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 2000ms
Initial database connection attempt 3 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 4000ms
Initial database connection attempt 4 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 8000ms
Initial database connection attempt 5 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 16000ms
There was an error initializing DB
There was an error initializing DB
Error: There was an error initializing DB
    at Start.exitWithCrash (/usr/lib/node_modules/n8n/src/commands/base-command.ts:361:28)
上の部分は私が DB_TYPE を postgresdb に変更し、ポートを意図的に誰もリッスンしていない 5433 に指定して出力したもので、そのままコピーしている。There was an error initializing DB 2 回連続で実行しても本当で、コピペミスではなく、重複行を見ても自分を疑わなくてよい。
リトライについて正しく理解すべき:これは「起動時に DB に接続する」リトライであり、「永遠に待つ」わけではない。attempt 1 を見ても慌てて再起動せず、31 秒待つ;5 回すべて失敗したなら、それは本当に不通で、100 回再起動しても同じだ。
アドレス内のポートが唯一有用な手がかりだ。DB_POSTGRESDB_PORT デフォルトは 5432、5433 と表示されるなら自分で設定した証拠で、十中八九は設定をコピーして変更を忘れている;表示が 127.0.0.1:5432 しかし DB を明らかに別のマシンにインストールしているなら、環境変数が効いていない証拠——systemd 内で Environment= 一行書き間違える、Docker 内で -e 一つ欠ける、どちらでもこうなる。
最も厄介なのはコンテナ内の場合。n8n がコンテナ内で動作し、設定に DB_POSTGRESDB_HOST=127.0.0.1と書くと、この 127.0.0.1 はコンテナ自身のループバックであり、ホストではない。DB がホスト上で動作している場合、コンテナからはどう接続しても繋がらず、表示されるのはやはり ECONNREFUSED で、「DB が起動していない」と全く同じに見える。DB も compose に入れてサービス名を host にするか、コンテナにホストアドレスを認識させるかだ。
まず外部で疎通性を検証した方が、n8n のログで推測するよりはるかに速い:
# nc -vz 127.0.0.1 5678
Connection to 127.0.0.1 5678 port [tcp/*] succeeded!
# nc -vz 127.0.0.1 5433
nc: connect to 127.0.0.1 port 5433 (tcp) failed: Connection refused
nc が通ったのに n8n がまだ接続できないなら、問題は認証情報と DB 名にあり、postgres 自身のログを見に行くべきで、n8n 側で回り道しないこと。
「SQLite package has not been found installed」の件
これは起動の第2段階で最も誤読されやすいエラーで、自分も引っかかった。デフォルトの SQLite シナリオ、つまりほとんどの人が初めて n8n をインストールするときに現れる。ログはこうなる:
Initial database connection attempt 1 failed: SQLite package has not been found installed. Try to install it: npm install sqlite3 --save. Retrying in 1000ms
Initial database connection attempt 2 failed: SQLite package has not been found installed. ...
...
Error: There was an error initializing DB
DriverPackageNotInstalledError: SQLite package has not been found installed. Try to install it: npm install sqlite3 --save.
    at SqliteLibrary.loadLibrary (/usr/lib/node_modules/n8n/node_modules/@n8n/typeorm/dist/driver/sqlite-pooled/SqliteLibrary.js:30:19)
人は最後のスタックトレースに引っ張られて、「DB の初期化失敗」はデータベースが壊れたのだと思いがちだ。最初の行が実ははっきりと言っている:sqlite3 このネイティブモジュールが存在しない。npm で n8n をインストールするとネイティブモジュールが一緒にビルドされるが、ビルド環境が不完全だったり、Node のメジャーバージョンをアップグレードした後だったり、パッケージインストール時に --ignore-scriptsを付けた場合に、この部分が欠落する。このログは自分のマシンで2回成功した起動記録の間に挟まっていた。当時どのステップで直ったかは記録していないが、データベース自体とは無関係だとだけ分かっている。
修正の道は3つあり、コストの小さい順に並べると:ビルド環境(python3、make、g++)を整えてから n8n を再インストールする;または N8N_REINSTALL_MISSING_PACKAGES=trueを有効にして、起動時に不足パッケージを自動で補完させる。Dockerfile や systemd に書いてもよい;手間をかけたくなければ Docker イメージに切り替える。イメージ内ではこれらのネイティブモジュールはビルド済みだ。エラー内の npm install sqlite3 --save という記述は「n8n をローカル依存としてインストールする」シナリオ向けであり、グローバルインストール時にそのまま真似しても効かないことがある。
ついでにバージョン要件も記しておく:n8n は Node 20.19 から 24.x を要求し、この範囲外の Node では各種の奇妙なネイティブモジュール問題が発生する。自分のマシンは 24.21.0 だ。
.n8n ディレクトリに書き込めない
起動の第1段階の失敗で、エラーに EACCES 和 mkdirが含まれていれば、自身のデータディレクトリすら作成できていないことを示す。.n8n ディレクトリにはデータベースファイル、暗号化キー、設定が保存されており、ディレクトリが書き込み不可なら完全に起動できない:
No encryption key found - Auto-generating and saving to: /root/n8n_noperm/.n8n/config
Error: Failed to load command "start"
Error: EACCES: permission denied, mkdir '/root/n8n_noperm/.n8n'
    at mkdirSync (node:fs:1410:26)
at InstanceSettings.loadOrCreate (/usr/lib/node_modules/n8n/node_modules/n8n-core/src/instance-settings/instance-settings.ts:353:12)この段には罠がある:まず「キーがない、生成してあるパスに保存中」と出力し、その後に失敗する。前の行だけ見ると順調に進んでいるように見えるが、実際には1文字も書き込まれていない。判断基準は1つだけ——後ろに Editor is now accessible viaがあるかどうかで、なければ起動していない。
この部分はnobodyユーザーで実行し、対象ディレクトリが /root の下で出力されたもので、誰も書き込めない。実際の運用でもっとよくあるのはDocker:コンテナ内のn8nはuid 1000のnodeユーザーで動作し、ホスト上であなたが mkdir したディレクトリがroot 700だと、mountした時点でこのエラーになる。修正方法はホストディレクトリの所有者を正しく変更することで、権限を最大にすることではない:
chown -R 1000:1000 /srv/n8n-datachmod 777 起動させることはできるが、私は推奨しない。そのディレクトリには暗号化キーファイルがあり、同じマシンのどのユーザーでも読めるということは、ライブラリ内のすべてのサードパーティ認証情報の鍵をドアノブに掛けておくのと同じだ。
私の実際の調査順序
問題が発生したときはログの1行目から読み始めず、この順序で進めれば5分で原因箇所を特定できる:
- サービスの状態を確認する。
systemctl status n8nまたはdocker ps -a。重要なのはactiveかfailedかではなく、Restartの回数とRestarting (1) 3 seconds agoのようなループだ。ループは繰り返し起動して繰り返し死んでいることを意味するので、ログを見に行き、systemdで悩まないこと。 - ログを探す。まず試す
journalctl -u n8n -n 50。私のこのマシンが返すのは-- No entries --、unit 内で出力がファイルにリダイレクトされているため:StandardOutput=append:/data/logs/n8n.out.log。この場合は直接tail -100 /data/logs/n8n.out.log。Docker はつまりdocker logs --tail 100 n8n。 - 再起動回数を数える。
grep -c 'n8n ready on' /data/logs/n8n.out.log、私のこのマシンは 30。ログは追記式で書かれ、履歴はすべて残っており、同じエラーが繰り返し出現すれば起動ループ。 - ポートを確認する。
ss -ltnp 'sport = :5678'、上記と照らし合わせて該当するものを確認。 - ヘルスを検証する。
curl -s http://127.0.0.1:5678/healthz。プロセスが生きていれば返す{"status":"ok"}、これはデータベースを見ない。
ステップ 2 の journalctl が空を返すと、サービスがまったくログを書いていないと誤解しやすい。サービスは明らかに systemd 管理なのに、ログはファイルにある。だからまず systemctl cat n8n リダイレクトがあるか見るほうが、黙ってログを漁るより速い。
Docker 側ではさらに2ステップ必要:docker ps -a の STATUS 列に Restarting (1) 3 seconds agoと表示され、括弧内の数字が増え続けていれば繰り返し起動している;port が合わない場合はまず docker port n8nを確認する。host port と container port が一覧表示される。私の環境は npm インストールなので、container 内のエラー原文は自分で打って確認していない。これらの項目は docker の一般的な挙動に基づいて書いている。
本当に起動したかどうかの判断方法
port が listen しているからといって、正常に動作しているとは限らない。n8n には既成の確認 endpoint が2つあり、その違いは実用的だ:
# curl -s -o /dev/null -w '%{http_code}n' http://127.0.0.1:5678/healthz
200
# curl -s http://127.0.0.1:5678/healthz
{"status":"ok"}
# curl -s -o /dev/null -w '%{http_code}n' http://127.0.0.1:5678/healthz/readiness
200
/healthz 200 はプロセスが応答できることだけを示し、database は見ていない。/healthz/readiness が「database に接続でき、migration も完了した」状態だ。再起動後の数十秒間は、前者がすでに 200 でも後者がまだ追いついていないことがあり、それは migration がまだ実行中ということだ。監視スクリプトを書くときは readiness を使い、healthz は使わない——「このマシンが traffic を受けられるか」を反映できるのは前者だけだ。
両方とも 200 になったら、実際の動作を一通り確認する:
- エディタを開き、ログインでき、workflow 一覧が見えること。白画面でぐるぐる回っていないこと。
- Code ノードを含む workflow を適当に1つ実行し、成功すること。このステップで検証するのは task runner であり、前述の通りこれはよく見落とされる。
- workflow を publish し、実際に1回実行させ、実行記録にこの本番実行が表示され、ステータスが成功であること。
3番目の項目は省略しないこと。一部の deployment ではエディタはすべて正常なのに、時刻になっても実行されない。原因は queue モードの worker が接続されていないことであり、この種の問題は実際に1回実行して初めて露呈する。
画面に表示される「サービスが接続を拒否しました」
起動失敗時は画面にそもそも入れないので、この節で扱うのは別のケース——n8n は起動したが、workflow 内で接続しているものが起動していない場合だ。この2種類の故障は調査方向がまったく逆なので、混同しないこと。
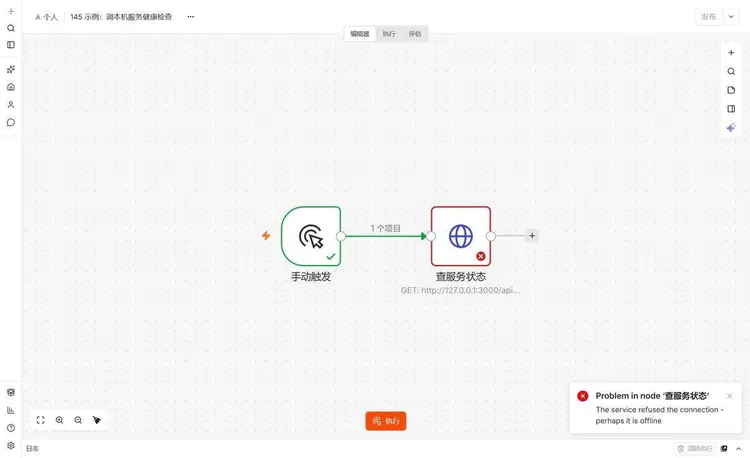
一度実行が失敗した後、キャンバス上のノードは赤くなり、右下にポップアップ表示される Problem in node '查服务状态'、その下に小さな文字が一行 The service refused the connection - perhaps it is offline。この文は n8n が翻訳した人間向けの言葉で、port にも protocol にも触れていない。
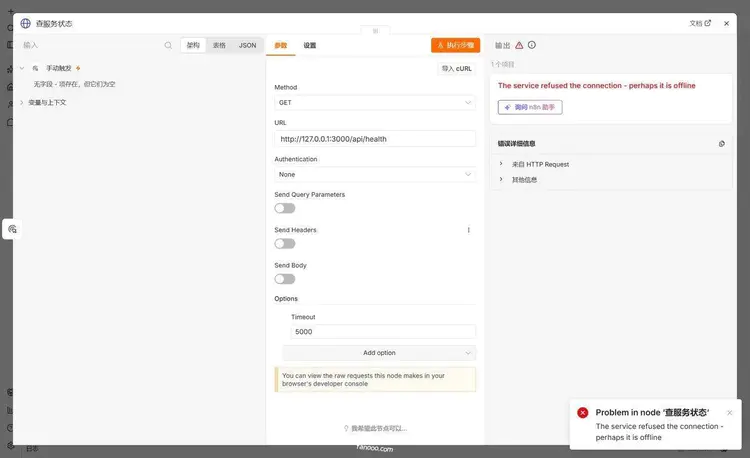
ノードをダブルクリックし、右側の出力パネルを下にスクロールすると、折りたたまれた「エラーの詳細」があり、開くと元の情報が見える。
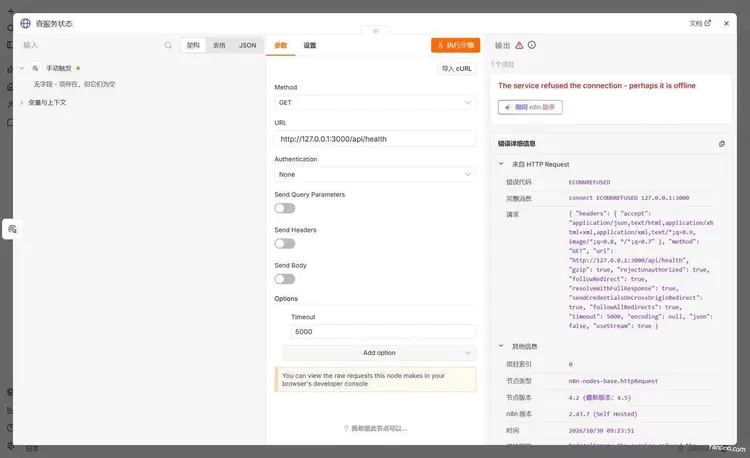
「エラーコード」の行は ECONNREFUSED、「完全なメッセージ」は connect ECONNREFUSED 127.0.0.1:3000。ここまで来ると起動時のあのエラーと一致する。同じエラーコードで、今回はノード内で発生しただけ。この port を使って nc -vz、通るかどうかすぐ分かる。
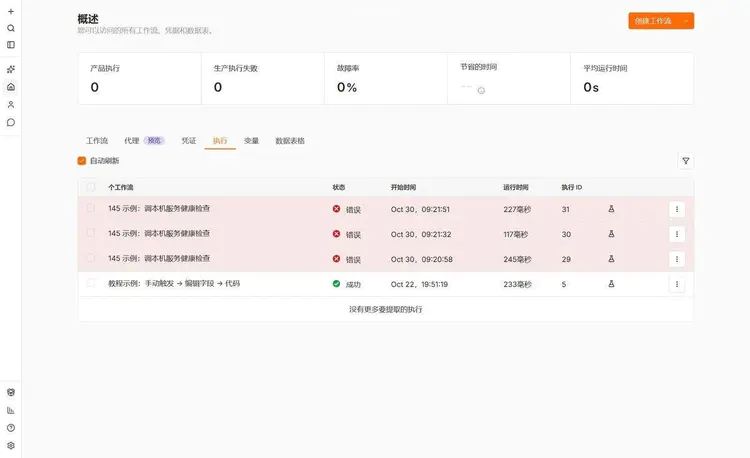
実行記録にはもう一つ無料の判断材料がある:実行時間。私の3回はそれぞれ 227、117、245 ミリ秒。TCP のハンドシェイクすらできていないからこそこれほど速い;相手に接続できたが 500 を返した場合、またはタイムアウトの場合は、数百ミリ秒から数秒かかり、甚至你设的 timeout に達することもある。200 ミリ秒以内のエラーは、「port/アドレス/サービスが起動していない」を直接疑い、「インターフェースの返却内容がおかしい」を疑うのは時間の無駄。
六つのエラー原文早見表
| エラー原文 | どこで詰まるか | 対処方針 |
|---|---|---|
n8n's port 5678 is already in use... |
第三段、port | ss -ltnp 'sport = :5678' pid を探し、古いものを停止するか port を変更する |
n8n webserver failed, exiting listen EADDRNOTAVAIL |
第三段、アドレス | 設定内の IP がローカルに存在しない、ip addr 照合する |
Error: listen EACCES: permission denied 0.0.0.0:80 |
第三段、権限 | 1024 未満の port は特権が必要、port を変更するか capability を追加する |
Initial database connection attempt N failed: connect ECONNREFUSED |
第二段、データベース | 5 回のリトライを満了するまで待ち、その後 nc -vz host port |
DriverPackageNotInstalledError: SQLite package has not been found installed |
第二段、依存関係 | 补 sqlite3、または n8n を再インストールする |
EACCES: permission denied, mkdir '/.../.n8n' |
第一段、ディレクトリ | データディレクトリの所有者が正しくない、owner を変更し 777 にしない |
3つのセキュリティ注意事項
調査中に一時的に緩めたリスニング設定は、忘れずに元に戻すこと。外部から起動しているか確認するために、 N8N_LISTEN_ADDRESS を 0.0.0.0 に変更する、または -p 5678:5678を1行追加する。確認が終わったら忘れること。n8n のエディタは公開ネット上ではログインフォームに過ぎず、スキャンスクリプトは1日に数千回試行できる。自分の環境では 127.0.0.1 のみをリスニングし、公開側は nginx 443 経由が常態であり、トラブルシューティングのために一時的な状態に変更したまま放置してはならない。
ログを貼る前に一通りスキャンすること。起動ログには完全な webhook URL が含まれており、webhook パス自体が認証情報である。パスを取得されればワークフローにデータを注入される。スタックにはインストールパス、内部アドレス、データベースホスト名が含まれる。グループやフォーラムで助けを求める前に、これらを置換してから貼ること。
データベースパスワードをコマンドラインに書かないこと。docker run -e DB_POSTGRESDB_PASSWORD=xxx は shell history に残り、 docker inspect の出力にも現れ、同じマシンで docker コマンドを実行できる誰からも見える。 --env-fileを使うか、systemd の EnvironmentFile=を使い、ファイル権限は 600 にする。先に貼った unit はまさにそのように書かれており、パスワードは /etc/n8n/instance-ai.env にあり、unit にはない。
まとめ
起動失敗は一見さまざまに見えるが、実際は4段階だけだ:鍵、データベース、リスニング、マイグレーション。ログがどの行で止まったかが、どのコマンドを打つべきかを決める。推測は無意味だ——あの「別の n8n がすでに動いているのではないか」という一文は、わざと人を惑わせるためのものだ。
3つのコマンドで十分だ:ss -ltnp 'sport = :端口' 占有者を見つけ、nc -vz host 端口 疎通を検証し、curl /healthz/readiness 準備完了を検証する。残りはエラー原文と照らし合わせてこの記事の表を確認するだけだ。
最後に経験則を一つ:n8n ready on 和 Editor is now accessible via の間の部分は、最も「もう直った」と誤認されやすい。マイグレーションが完了する前に再起動する、あるいはそのまま電源を切る——これは私が見てきた中で最もコストの高い「ちょっとした操作」だ。
続きはこちら
前回の記事は『最初のワークフロー:手動トリガー → フィールド編集 → コード』で、ゼロからフローを組むならそちらを参照してほしい。まだインストールしていない場合は『n8n のインストール方法』を、画面に不慣れなら『インターフェースガイド』を参照してほしい。散発的な障害記録はこちらにまとめてある:トラブルシューティングページ、コース全体の目次はここ。
参考資料
- Monitor n8n:
/healthzプロセスの生存のみを確認、/healthz/readinessデータベースが接続済みでマイグレーションが完了していることを要求 - Deployment 環境変数:
N8N_PORTデフォルト 5678、N8N_LISTEN_ADDRESSデフォルト::、N8N_USER_FOLDERの用途 - Database 環境変数:
DB_TYPEデフォルト sqlite、DB_POSTGRESDB_PORTデフォルト 5432、および実行中に切断された場合の自動復旧パラメータ - Logs 環境変数:
N8N_LOG_OUTPUTデフォルトは console、file に設定するとログは次に出力される<n8n 目录>/logs/n8n.log - Use the command line:
n8n start、n8n export:workflowこれらのサーバー側コマンドは、ほとんどが n8n の実行を必要としない - Install with Docker:公式 run コマンドの port マッピングと
/home/node/.n8n卷 - Install with npm:Node バージョン範囲 20.19 から 24.x
- Node.js errors:
EADDRINUSE、ECONNREFUSED、EACCES、EADDRNOTAVAILそれぞれの定義
最終更新:2026 年 10 月 30 日、使用したのは n8n 2.43.7。



