Workflow, Node, Connection, Execution: Vier Begriffe erklären die Welt von n8n


Auf der Leinwand sind fünf Blöcke und vier Linien. Exportiert man dieses Ding als JSON, bleiben nur zwei Schlüssel übrig:nodes 和 connections. Die Ausführungsaufzeichnungen liegen an einer anderen Stelle, eins nach dem anderen aufgereiht, jeder Eintrag mit einer Nummer.
Die drei Stellen beschreiben dieselbe Sache mit vier Wörtern: workflow, node, connection, execution. Sind diese vier Wörter geklärt, spart man sich beim Lesen jedes späteren Node-Tutorials Mühe; sind sie nicht geklärt, stößt man ständig zwischen „Ich habe doch auf Ausführen geklickt" und „Warum läuft es nicht" hin und her.
Man muss nicht programmieren können. Ein installiertes n8n, das sich öffnen lässt und einen Workflow einmal ausgeführt hat, reicht (falls nicht installiert, siehediesen Artikel, und wer mit der Oberfläche noch nicht vertraut ist, blättert zuerst durchdie Oberflächenübersicht). Meines hier ist 2.43.7; bei dir kann die Minor-Version abweichen, und die Button-Positionen können leicht unterschiedlich sein.
- Vier Wörter, vier Dinge
- Workflow: ein Container plus zwei Zustände
- Node: Der Name ist der Primärschlüssel
- Connection: zwei Array-Ebenen, die erste Ebene ist die Ausgangsnummer
- Execution: ein Lauf mit einem Snapshot
- Zusammengesetzt betrachtet: die Reihenfolge einer Fehlersuche
- Woran man erkennt, dass man es wirklich verstanden hat
- Fünf Fehler, die wirklich passieren
- Risiken bei Export, Freigabe und Nachvollziehbarkeit
Vier Wörter, vier Dinge
Zuerst eine Vergleichstabelle, die folgenden Abschnitte zerlegen sie im Detail.
| 词 | Was es ist | Wo es liegt | Mengenverhältnis |
|---|---|---|---|
| Workflow | Eine Gruppe von Nodes, die zusammen eine Aufgabe erledigen | Die Workflow-Tabelle in der Datenbank, ein JSON | 1 Workflow hat N Nodes |
| Node | Eine Ausführungseinheit, die einen Schritt erledigt | Im Workflow-JSON nodes Im Array |
1 Node gehört zu 1 Workflow |
| Connection | Die Ausgabe des vorherigen Nodes mit dem Eingang des nächsten verbinden | desselben JSON connections im Objekt |
1 Workflow hat N Linien |
| Execution | Dieser Workflow wurde einmal ausgeführt | Execution-Tabelle, unabhängig vom Workflow | 1 Workflow hat N Executions |
Am leichtesten verwechselt man die letzte Zeile. Der Workflow ist der Bauplan, die Execution ist die Ausführung. Ändert man den Bauplan zehnmal, ändert sich die zuvor ausgeführte Arbeit nicht mit.
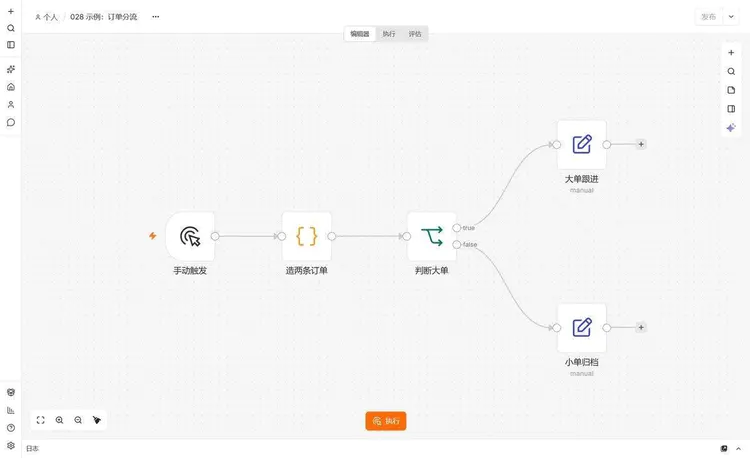
Workflow: ein Container, plus zwei Zustände
Die offizielle Definition ist kurz: eine Gruppe verbundener Nodes, die automatisch eine Aufgabe erledigen; wenn der Trigger auslöst, du manuell klickst oder ein anderer Prozess ihn aufruft, beginnt er zu laufen, führt Node für Node aus, kann verzweigen, zusammenführen, schleifen.
An der Definition gibt es nichts auszusetzen. Wirklich aufpassen muss man auf den Zustand, der ab 2.x hinzugekommen ist:Entwurf und veröffentlicht sind zwei verschiedene Dinge。
Du änderst etwas auf dem Canvas, n8n speichert selbst, innerhalb von einer bis fünf Sekunden landet es in der Datenbank, es gibt keinen Speichern-Button. Aber das ist nur der Entwurf. Damit die Änderung live geht, musst du oben rechts auf „Veröffentlichen" klicken und eine bestimmte Version auf die Produktion festnageln. Danach laufen Timer, Webhook und App-Events alle gegen die festgenagelte Version, nicht gegen die, die du gerade auf dem Bildschirm siehst.
Diese Regel löst ein altes Problem (mitten in der Änderung vom Timer-Job erwischt zu werden), schafft aber eine neue Falle: Parameter geändert und vergessen zu veröffentlichen, online läuft noch die Logik von gestern, während auf dem Canvas alles normal aussieht. Als ich das zum ersten Mal erlebt habe, habe ich zehn Minuten lang zwei Parameter-Versionen verglichen, bis mir einfiel, dass der Button oben noch leuchtet.
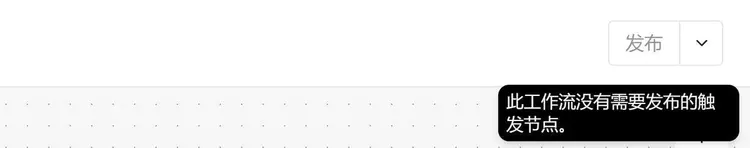
Das erklärt nebenbei auch, warum der erste Workflow mancher Leute partout nicht „aktiviert" werden kann. Es gibt nur einen manuellen Trigger, der hat von Natur aus keine Produktionsform, der Veröffentlichen-Button bleibt immer grau. Für Zeitplan: Schedule Trigger hinzufügen; für externe Anfragen: Webhook hinzufügen. Mit solchen Triggern leuchtet der Button erst.
Von der Schnittstelle aus ist es klarer: Auf meiner Instanz, ein neu erstellter Workflow active 是 false,activeVersionId 是 null, hat nur ein versionId , das sich mit jeder Änderung mitändert. Nie veröffentlicht, also keine Online-Version.
Node: Der Name ist der Primärschlüssel
Ein Node ist eine Ausführungseinheit. Manche sind für den Start zuständig (Trigger), manche holen Daten, senden Daten, berechnen Daten, manche machen nur Flusskontrolle, eine Zeile IF kann auch ein Node sein.
In JSON heruntergebrochen hat ein Node genau sieben Dinge:
{
  "parameters": { "jsCode": "return [{ json: { amount: 620 } }];" },
  "id": "n2",
  "name": "造两条订单",
  "type": "n8n-nodes-base.code",
  "typeVersion": 2,
  "position": [-400, 0]
}type: Welcher Node-Typ es ist.n8n-nodes-base.codeist der Code-Node,-base.der Teil danach ist der kleingeschriebene Node-Name.typeVersion: Die Version der Knotendefinition. Bei verschiedenen Versionen desselben Knotens ändert sich die Parameterstruktur. In meiner Version ist IF2.2, Edit Fields ist3.5, Code ist2, Manual Trigger ist1. Diese Zahl füllst du nicht selbst aus, sie wird beim Erstellen nach der damaligen Definition eingetragen.parameters: Alles, was du im rechten Panel ausfüllst, steht hier. Wechselst du den Knotentyp, wird dieser Block komplett ersetzt.position: Canvas-Koordinaten, rein zur Anzeige, unabhängig von der Ausführungsreihenfolge.id: Kurze Kennung für die interne Verwendung im Workflow; beim Kopieren eines Knotens wird eine neue erzeugt.
name Wirkt am unscheinbarsten, ist aber tatsächlich die Stelle unter diesen vier Begriffen, bei der man am leichtesten Schiffbruch erleidet:Es ist der Primärschlüssel. Verbindungen merken sich den Namen, nicht die id.
Ich habe auf dem Canvas „小单归档“ in „小单归档(改)“ geändert, keine der vier Verbindungen ist gerissen, und nach dem Speichern hat sich im Interface auch connections auf den neuen Namen geändert — das ergänzt die Oberfläche für dich. Andersherum: Änderst du direkt nameim JSON und lässt die Verbindungen unangetastet, lehnt der Server es sofort ab und meldet sogar zwei Fehler auf einmal:
Workflow structure is invalid. nodes[4].name (duplicate_node_name):
Duplicate node name "大单跟进"; connections.判断大单.main[1][0].node
(unknown_connection_target): Connection target "小单归档" does not
reference an existing node
Der erste Satz sagt doppelter Name, der zweite sagt, eine Linie zeigt auf einen nicht existierenden Knoten. Beide Sätze sind eigentlich zwei Seiten derselben Sache: Du hast einen Knoten in den Namen eines anderen umbenannt, und der verdrängte Name wird von den Verbindungen noch immer referenziert.
Deshalb empfehle ich, Knotennamen wie Variablennamen zu vergeben: Verwende nicht „Set" oder „Code 1" und ändere sie auch nicht alle paar Tage. Leerzeichen, Klammern und chinesische Zeichen im Namen sind in Ordnung, n8n akzeptiert das, aber wenn du selbst in Ausdrücken schreibst $('小单归档(改)') , übersieht man leicht eine Klammer.
Connection: zweistufiges Array, die erste Ebene ist die Ausgangsnummer
Eine Verbindung verbindet den Ausgang eines Knotens mit dem Eingang eines anderen Knotens. In JSON sieht das so aus:
"connections": {
  "造两条订单": { "main": [[{ "node": "判断大单", "type": "main", "index": 0 }]] },
  "判断大单": { "main": [
    [{ "node": "大单跟进", "type": "main", "index": 0 }],
    [{ "node": "小单归档", "type": "main", "index": 0 }]
  ]}
}
Aufgeschlüsselt gelesen: Der äußerste Schlüssel istder Quellknotenname;main ist der Verbindungstyp (normaler Datenfluss; bei der AI-Sache sind es ai_tool、ai_languageModel diese); das innere Array darin hat alsIndex die Nummer des Ausgangs; darin befindet sich die Zielliste, ein Ausgang kann mit mehreren Downstream-Knoten verbunden sein.
Die Entscheidung für große Aufträge hat zwei Gruppen, daher ist es [[...],[...]]. Die erste Gruppe entspricht dem mit true markierten Punkt am Knoten, die zweite Gruppe entspricht false. Auf den ersten Blick denkt man, das Array sei zu oft verschachtelt, aber es ist einfach „welcher Ausgang → verbunden mit wem".
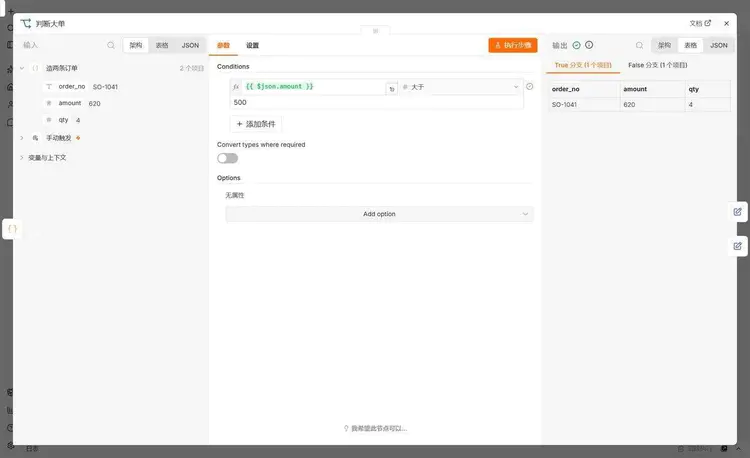
Hier gibt es ein konzeptionelles Missverständnis, das es sich lohnt auseinanderzunehmen. Viele Leute denken, IF sei „Entweder-oder": Bedingung erfüllt → dieser Weg, nicht erfüllt → jener Weg, es wird nur einer genommen.
Nein. IF isteine Aufteilung nach Datensätzen. Ich lasse es zwei Bestellungen annehmen, 620 und 180, das Ergebnis ist: true-Zweig 1 Eintrag, false-Zweig 1 Eintrag, beide Linien leuchten. Wenn du 100 Datensätze hineingibst, verteilt es sie nach ihrem jeweiligen Betrag auf beide Seiten, vielleicht links 30 und rechts 70, vielleicht auch auf einer Seite 0.
Wenn es also heißt „die Knoten nach dem IF wurden nicht ausgeführt", prüfe zuerst, ob auf dieser Seite überhaupt keine Daten vorhanden sind. Das ist kein Fehler.
Execution: ein Lauf, mit einem snapshot
Eine Execution bedeutet, dass dieser Workflow einmal ausgeführt wurde. Einmal manuell klicken zählt als einmal, ein Timer, der einmal auslöst, zählt als einmal, ein Request, der über Webhook hereinkommt, zählt als einmal. Sie gehört nicht zum Workflow JSON, sondern liegt in einer anderen Tabelle und wird über workflowId zurückverknüpft.
Felder, die mich in einem Execution-Datensatz interessieren:
| Feld | Wert in diesem Datensatz | Wofür es gut ist |
|---|---|---|
id |
35 | Eine instanzweite auto-increment-Sequenz, nicht pro Workflow ab 1 |
workflowId |
9biNEw9D0DqWOVV1 | Zu welchem Workflow es gehört |
mode |
manual | Manuell ausgeführt oder in der Produktion ausgeführt |
status |
success | Erfolg, Fehlschlag, Abbruch, Absturz, Wartend |
startedAt / stoppedAt |
01:17:42.352 / 01:17:42.513 | 161 Millisekunden Unterschied, genau das „innerhalb von 161 Millisekunden“ in der Oberfläche |
workflowVersionId |
eine uuid | Welche Version wurde diesmal ausgeführt |
Die letzte Zeile wird leicht übersehen, ist aber sehr nützlich: Die Ausführung richtet sich nach der Version. Wenn du Parameter geändert, aber nicht veröffentlicht hast, läuft in der Produktion weiterhin die alte Version, und im Ausführungsprotokoll hängt die ID der alten Version.
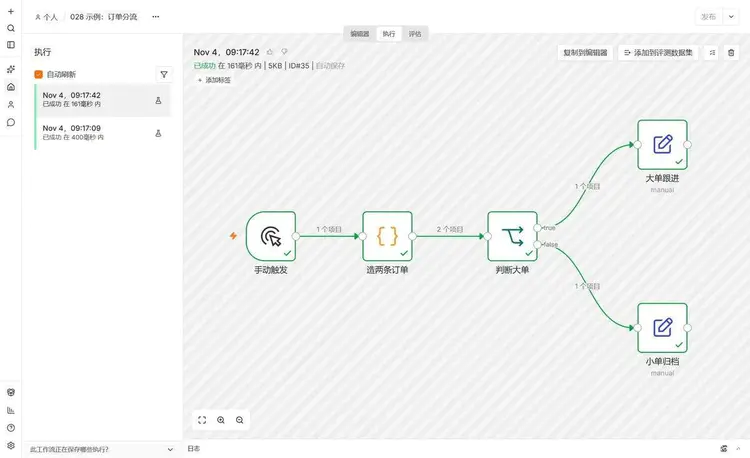
Ein Detail, das mir diesmal erst aufgefallen ist: In jeder Ausführung ist ein Snapshot des damaligen Workflows gespeichert (workflowData). Nachdem ich „Kleinauftrag archivieren“ in „Kleinauftrag archivieren (geändert)“ umbenannt hatte, habe ich die Ausführung von 09:17:42 aufgerufen – auf der Zeichenfläche stand weiterhin „Kleinauftrag archivieren“, weil das Rendering den Snapshot dieser Ausführung verwendet, nicht deine aktuelle Zeichenfläche.
Das erklärt zwei Dinge. Die gute Seite: Parameter ändern, Knoten löschen – alte Einträge werden nicht verfälscht, und bei der Fehlersuche siehst du den damaligen Zustand. Die schlechte Seite: Wenn du alte Einträge mit der aktuellen Zeichenfläche vergleichst, passen die Knotennamen möglicherweise nicht zusammen – denk nicht, du hättest dich falsch erinnert.
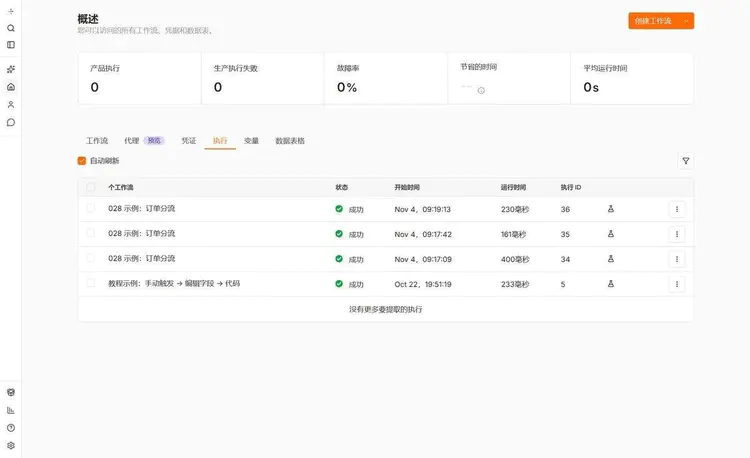
Wie lange gespeichert wird, ist eine praktische Frage. Standardmäßig ist die automatische Bereinigung aktiv: Älter als 336 Stunden (14 Tage) wird gelöscht, und wenn die Gesamtmenge 10000 überschreitet, wird ebenfalls von den ältesten an gelöscht. Erfolg und Fehlschlag werden beide gespeichert, manuelle Ausführungen ebenfalls. Welche der beiden Regeln zuerst greift, entscheidet: Ein Workflow, der alle 5 Minuten läuft, kommt auf 288 Mal pro Tag, nach 14 Tagen auf 4032 Einträge – zuerst greift das Alter; bei 2000 Mal pro Tag ist die Zehntausendergrenze am fünften Tag erreicht – zuerst greift die Anzahl. Dass „diese Ausführung nicht in der Liste steht“, heißt also nicht unbedingt, dass sie nicht gelaufen ist – möglicherweise wurde sie bereits bereinigt.
Zusammengefasst: die Reihenfolge einer Fehlersuche
Die vier Begriffe versteht man einzeln, aber in der Anwendung braucht es eine Reihenfolge. Meine Gewohnheit ist, von außen nach innen einzugrenzen:
- Zuerst den Status des Ausführungsprotokolls prüfen. Gibt es keinen Eintrag, wurde gar nicht ausgelöst – das Problem liegt beim Trigger oder beim Veröffentlichungsstatus, nicht in den Nodes.
- Ist der Status fehlgeschlagen, hineinklicken und sehen, welcher Node rot ist. In den Node-Details die Eingabe prüfen – meistens ist schon die Eingabe falsch.
- Ist der Status erfolgreich, aber das Ergebnis falsch, die Item-Anzahl auf den Verbindungen prüfen. Ist eine Leitung bei 0, tun die nachfolgenden Nodes natürlich nichts.
- Stimmen die Zahlen, aber die Felder nicht, dann erst kommen Node-Parameter in Verdacht, oder ein Upstream hat den Typ geändert.
Der Vorteil dieser Reihenfolge ist, dass jeder Schritt eine große Menge Möglichkeiten ausschließt. Umgekehrt: Wenn man sofort auf den Code-Node starrt und den Code liest, stellt man oft nach einer halben Stunde fest, dass der Upstream nur 0 Items gesendet hat.
Wie man wirklich versteht, was man tut
Man muss keine Definitionen auswendig lernen – drei Dinge reichen, und jedes hat ein beobachtbares Ergebnis.
Erstens: zählen.Wie viele Blöcke auf dem Canvas sind, so viele sollten im exportierten JSON nodes im Array stehen. Bei mir sind es 5 Blöcke, Array-Länge 5. Dasselbe gilt für die Verbindungen: 4 Leitungen entsprechen connections 4 Source-Keys (die Verzweigung für Großaufträge hat zwei Gruppen in einem Key, aber es bleiben 4 Leitungen).
Zweitens: eine Leitung ändern.Die Nodes auf dem false-Pfad löschen und erneut exportieren –判断大单 die zweite Array-Gruppe sollte zu einem leeren Array werden, nicht komplett verschwinden. Dieser Schritt merkt man sich: „Der Ausgang ist durch die Position bestimmt, nicht dadurch, ob es Downstream gibt."
Drittens: zweimal ausführen.Nach der Ausführung zu „Alle Ausführungen“ gehen; dort sollte ein Eintrag mehr vorhanden sein, dessen ID um 1 größer ist als die vorherige, und die Zeit entspricht dem Moment, in dem du geklickt hast. Ändere dann einen Parameter, ohne zu veröffentlichen, führe einmal aus und prüfe online (per Zeitplan oder Webhook), ob weiterhin die alten Parameter verwendet werden – wenn dies dein echter Geschäftsbetrieb ist, sollte dieser Schritt besser in einem Test-Workflow durchgeführt werden.
Fünf Fehler, die wirklich auftreten
1. Zwei Nodes haben denselben Namen.Nach dem Kopieren eines Nodes vergessen, den Namen zu ändern, oder das JSON manuell bearbeitet. Beim Speichern lehnt der Server ab und meldet Duplicate node name, und wirft gleichzeitig eine unknown_connection_targetaus. Wenn du zwei siehst, keine Panik – einfach den eindeutigen Namen wiederherstellen.
2. Node-Name geändert, Ausdruck nicht mitgeändert.Verbindungen werden von der Oberfläche automatisch ergänzt, Ausdrücke nicht. Der vorherige Node hieß A, du verwendest downstream $('A').item.json.amount zur Datenabfrage; nach der Umbenennung in B findet dieser Ausdruck nichts mehr, und der Fehler zeigt auf die Zeile mit dem Ausdruck, nicht auf die Umbenennung.
3. Die Schaltfläche „Veröffentlichen“ ist ausgegraut.Der Workflow enthält nur einen manuellen Trigger, nichts, was online gehen kann. Beim Darüberfahren mit der Maus erscheint „Dieser Workflow hat keine Trigger-Nodes, die veröffentlicht werden müssen“. Füge einen Schedule Trigger oder Webhook hinzu, dann lässt sich etwas veröffentlichen.
4. Nach Parameteränderung läuft der geplante Task weiterhin mit der alten Logik.Geändert wurde der Entwurf, aber nicht auf „Veröffentlichen“ geklickt. Diese Art von Problem ist am schwersten zu finden, weil Canvas, Parameter und Testausführung alle normal sind und nur das Online-Verhalten falsch ist.
5. Ausführungsprotokoll nicht auffindbar.Drei Möglichkeiten: über die Aufbewahrungsfrist hinaus und bereinigt, Workflow gelöscht und die Datensätze sind mit weg, oder der Schalter „auch bei Erfolg speichern" wurde ausgeschaltet (EXECUTIONS_DATA_SAVE_ON_SUCCESS=none). Die ersten beiden sind am häufigsten.
Risiken beim Exportieren, Teilen und bei der Nachverfolgung
Workflow-JSON lässt sich vollständig exportieren und an andere weitergeben. An drei Stellen können Dinge durchsickern.
Klartext in den Parametern.Die Credentials selbst stehen nicht im JSON (nur eine Namensreferenz), aber parameters kann alles Mögliche enthalten: Token in der URL, handgeschriebene Keys in HTTP-Request-Headern, den Path des Webhook.grep Einmal key、token、Bearer und wieder rausschicken, zwei Minuten Sache.
In den Ausführungsprotokollen stehen die Rohdaten.Was ein Node ausgeführt hat, steht im Protokoll als Originaltext – Bestellnummer, Kundenname, Adresse, alles da. Self-Hosting erlaubt eigene Kontrolle über die Aufbewahrungsfrist, das EXECUTIONS_DATA_MAX_AGE kleiner zu stellen ist der einfachste Weg; bei von mehreren Personen genutzten Instanzen sollte man es besser von Anfang an einstellen.
JSON von anderen direkt einfügen.Eingefügt läuft sein Code auf deiner Instanz, das JS im Code-Node fragt nicht, ob du es ausführen willst. Workflows unbekannter Herkunft in eine leere Testinstanz werfen, erst anschauen, dann entscheiden.
Kurzfassung
Ein Workflow ist ein Bauplan, ein Node ist ein Kästchen auf dem Bauplan, eine Verbindung ist ein Pfeil zwischen den Kästchen, und eine Ausführung ist der eine Durchgang, bei dem nach dem Bauplan gebaut wird. Die vier Wörter entsprechen vier Dingen, ihre Position ist unterschiedlich, und die Folgen einer Änderung sind ebenfalls unterschiedlich: Eine Änderung der Node-Parameter wirkt sich auf jede zukünftige Ausführung aus, eine Änderung des Ausführungsdatensatzes kann gar nichts ändern (er ist ohnehin ein Datensatz), und eine Namensänderung lässt Verbindungen mitwandern, aber Ausdrücke nicht unbedingt.
Wenn ich wirklich eines auswählen müsste, das man sich zuerst merken sollte, dann ist es „Ausführung mit Snapshot“. Es erklärt gleichzeitig, warum alte Datensätze einen nicht täuschen, warum neue Änderungen nicht unbedingt wirksam werden und warum nach Ablauf der Aufbewahrungsfrist nichts mehr nachvollziehbar ist.
Um zu beurteilen, ob man es verstanden hat, gibt es eine einfache Methode: Öffne irgendeinen Workflow von jemand anderem, schau nicht auf das Canvas, sondern nur auf das exportierte JSON, und sag, wie viele Nodes er beim Laufen haben wird, wie viele Pfade es gibt und welcher davon ein Leerlauf ist. Wenn du das sagen kannst, hast du die vier Wörter bestanden.
Weiter geht es
Wer den ersten Workflow noch nicht erfolgreich zum Laufen gebracht hat, schaut zuerst„Erster Workflow: manueller Trigger → Feld bearbeiten → Code“, dort wird erklärt, wie man drei Nodes verbindet und zum Laufen bringt. Probleme beim Start wie Fehler beim Starten und belegte Ports, bei denen man gar nicht erst hineinkommt, stehenhier. Das Inhaltsverzeichnis des gesamten Kurses ist aufdieser Seite, alles zu Nodes steht unterdieser Kategorie.
Der zeitgesteuerte Typ unter den Triggern, der am leichtesten Probleme macht, hat einen eigenen Artikel:Workflow-Zeitplan wird nicht ausgelöst: 5 Ursachen einzeln durchgehen。
Referenzmaterial
- Key concept glossary: die offiziellen Definitionen von workflow, node, execution, publish – hieran orientiert sich dieser Artikel
- Understand workflows: was ein Workflow ist, sowie die vier Teile zum Erstellen von Workflows, Komponenten und Ausführung
- Connect nodes together: Verbindungen herstellen und löschen, der Output eines Nodes wird mit dem Input eines anderen Nodes verbunden
- Save and publish workflows: der Zeitraum für das automatische Speichern, Veröffentlichen fixiert die Version online, Produktionsausführungen verwenden die veröffentlichte Version
- Understand executions: der Unterschied zwischen manueller und Produktionsausführung, welche Ausführungen auf das Kontingent angerechnet werden
- If: Datentypen und Vergleichsmethoden für Bedingungen, zwei Outputs
- Executions Umgebungsvariablen: 336 Stunden Aufbewahrung, Obergrenze 10000 Einträge, Erfolg und Fehler werden beide gespeichert – diese Standardwerte
Letzte Aktualisierung: 4. November 2026, verwendet wird n8n 2.43.7.



