Comment diagnostiquer les erreurs de démarrage de n8n et les conflits de port


Le n8n côté serveur qui ne démarre pas fait partie des pannes plutôt faciles à diagnostiquer — il vous laisse toujours une ligne d'erreur. Le problème, c'est que cette ligne d'erreur pointe souvent dans la mauvaise direction. Pour écrire cet article, j'ai lancé un http.server avec python pour occuper le port, et n8n m'a quand même dit « est-ce qu'un autre n8n est déjà en cours d'exécution ».
Ci-dessous, je classe les échecs de démarrage en quatre catégories selon « la ligne sur laquelle le log s'arrête », chacune accompagnée d'une commande à taper immédiatement. Les messages d'erreur originaux proviennent tous de ma propre machine en 2.43.7, sans un seul caractère modifié.
Destiné à ceux qui auto-hébergent : installation globale via npm, exécution sous Docker, gestion par systemd, tout compte. Ceux qui utilisent la version cloud peuvent passer, le démarrage là-bas ne vous concerne pas. Un seul prérequis : pouvoir se connecter au shell de la machine, ou pouvoir consulter les logs du container.
- Le démarrage est un pipeline en quatre étapes, l'étape où le log s'arrête détermine ce qu'il faut vérifier
- Port occupé : trois commandes, plus un message trompeur
- Le port n'est pas occupé mais ça ne démarre pas : adresse erronée, permissions insuffisantes
- ECONNREFUSED : qui donc vous refuse la connexion
- La ligne « SQLite package has not been found installed »
- Impossible d'écrire dans le répertoire .n8n
- Mon ordre de diagnostic réel
- Comment savoir si c'est vraiment démarré
- Ce « le service refuse la connexion » dans l'interface
- Référence rapide des six messages d'erreur originaux
- Trois rappels de sécurité
Le démarrage est un pipeline en quatre étapes, l'étape où le log s'arrête détermine ce qu'il faut vérifier
Retenez d'abord à quoi ressemble un démarrage normal, sinon face à un log tronqué vous ne saurez pas ce qui manque. Voici un démarrage complet sur ma machine, en partant d'un répertoire vide :
No encryption key found - Auto-generating and saving to: /data/n8n/.n8n/config
Initializing n8n process
n8n ready on 127.0.0.1, port 5678
Migrations in progress, please do NOT stop the process.
Starting migration InitialMigration1588102412422
Finished migration InitialMigration1588102412422
Editor is now accessible via:
La ligne « No encryption key found » n'apparaît qu'au premier démarrage, ensuite la clé est déjà écrite dans .n8n/config , elle n'est plus affichée. La clé et la base de données vont de pair : si vous changez la clé, toutes les credentials stockées dans la base deviennent indéchiffrables, mais c'est une autre histoire ; ici retenez simplement qu'elle fait partie de la première phase du démarrage.
J'ai découpé tout le processus en quatre blocs, chacun échouant avec des formes d'erreur complètement différentes :
| Ordre | Ce qui se passe | Erreur typique quand ce bloc échoue |
|---|---|---|
| 1 | Lecture du fichier de configuration, chargement ou génération de la clé de chiffrement | EACCES: permission denied, mkdir、Failed to load command "start" |
| 2 | Connexion à la base de données, avec 5 tentatives intégrées | Initial database connection attempt N failed: connect ECONNREFUSED、SQLite package has not been found installed |
| 3 | Démarrage de l'écoute HTTP | n8n's port 5678 is already in use、n8n webserver failed, exiting listen EADDRNOTAVAIL |
| 4 | Exécution des migrations de base de données, lancement du task runner | Migrations in progress Plus aucune ligne ensuite Finished, le processus disparaît |
Un détail particulièrement trompeur :n8n ready on 127.0.0.1, port 5678 n'équivaut pas à pouvoir l'utiliser. Il apparaît dans Migrations in progress Avant, le port était déjà ouvert, la base était encore en cours de mise à niveau. À ce moment-là, il est normal que l'éditeur ne s'ouvre pas ; attendez que la migration soit terminée.
Dans la quatrième section, il y a aussi un élément propre à la 2.x : le nœud Code ne s'exécute pas dans le processus principal, n8n en lance un autre n8n task-runner. On peut le voir avec ps en regardant la relation parent-enfant.
# ps -o pid,ppid,etime,cmd -p 1053,7782
    PID    PPID   ELAPSED CMD
   1053       1  6-09:37:45 n8n start
   7782    1053  6-09:33:32 n8n task-runner
Le processus principal est là, le runner ne l'est pas : l'interface principale s'ouvre, mais dès qu'on exécute le nœud Code, ça renvoie une erreur. Face à ce symptôme, ne pensez pas au code, d'abord ps vérifiez si le runner est présent.
Port occupé : trois commandes, plus un message trompeur
Regardez d'abord ce que n8n dit lui-même. Quand il entre en collision de port, il ne balance pas une pile d'appels, juste une phrase en langage humain, puis le processus se termine avec le code de sortie 1 :
n8n's port 5678 is already in use. Do you have another instance of n8n running already?Cette phrase détourne 80 % de l'attention vers « un autre n8n ». La réalité est que : ce qui occupe le port peut être n'importe quoi. J'ai pris python3 -m http.server 5693 occupé 5693, puis pointé n8n vers 5693, il dit encore la même phrase. Deviner ne sert à rien, vérifiez.
# ss -ltnp 'sport = :5678'
State  Recv-Q Send-Q Local Address:Port Peer Address:Port Process
LISTEN 0      511        127.0.0.1:5678      0.0.0.0:*    users:(("n8n start",pid=1053,fd=24))
ss Disponible nativement sur Debian, Ubuntu, CentOS, la sortie est la plus propre et donne directement le pid. Si vous ne voulez pas retenir la syntaxe de filtrage,lsof c'est possible aussi, mais le nom du processus contiendra des échappements :
# lsof -i :5678 -sTCP:LISTEN
COMMAND    PID USER   FD   TYPE DEVICE SIZE/OFF NODE NAME
n8nx20st 1053 root   24u  IPv4  33852      0t0  TCP localhost:5678 (LISTEN)
n8nx20st Ce ne sont pas des caractères illisibles,x20 ce sont des espaces, le vrai nom est n8n start. La première fois, on croit à un programme inconnu, pas de panique. Si vous ne voulez que le pid,fuser le plus simple :
# fuser -n tcp 5678
5678/tcp:             1053
Récupérez le pid,ps -o pid,etime,cmd -p <pid> regardez depuis combien de temps il tourne. Cette étape permet de distinguer deux situations complètement différentes.
L'une est que votre ancien processus n'est pas mort.Vous l'avez dans systemd stop , ou docker rm , le processus est toujours suspendu en arrière-plan. Un etime affichant plusieurs heures pour n8n, c'est très probablement lui. La méthode propre consiste d'abord à systemctl stop n8n, puis à utiliser kill, ne pas kill -9dès le départ — une migration interrompue en pleine écriture par un kill brutal peut laisser la base de données bloquée dans un état de semi-mise à niveau, et il faudra restaurer une sauvegarde pour s'en sortir.
L'autre est qu'un autre service occupe votre port.Sur un cloud host, les ports comme 8080, 3000 sont très souvent occupés discrètement par un panel ou un petit service Node. Dans ce cas, il n'y a que deux options : faire céder l'autre, ou changer de port soi-même.N8N_PORT=5679 La modification prend une minute, mais ne changez pas qu'un seul endroit — le reverse proxy,WEBHOOK_URL、N8N_EDITOR_BASE_URL les ports codés en dur ailleurs vont aussi se tromper, c'est exactement comme ça qu'on ne reçoit plus les webhook.
Il y a aussi un cas qui ressemble à un conflit de port, mais qui est en réalité un problème d'adresse d'écoute. La valeur par défaut de N8N_LISTEN_ADDRESS de n8n est ::, dual-stack, couvrira aussi l'IPv4. Donc les autres n'occupent que 127.0.0.1:5678, si tu démarres n8n avec les valeurs par défaut, il ne démarrera pas non plus. Je l'ai testé : python n'écoute que sur 127.0.0.1:5694, n8n démarre sur 5694 avec l'adresse par défaut, et l'erreur affichée est toujours « port 5694 is already in use ».
Soit dit en passant,:: tout ouvrir pose un autre problème : n8n est directement exposé sur toutes les cartes réseau, y compris celle côté Internet. Sur ma machine, c'est l'inverse : il n'écoute que sur localhost, et l'extérieur est confié à nginx.
Environment=N8N_HOST=127.0.0.1
Environment=N8N_LISTEN_ADDRESS=127.0.0.1
Environment=N8N_PORT=5678
Environment=N8N_PROTOCOL=http
Le port n'est pas occupé mais le démarrage échoue quand même : adresse mal écrite, permissions insuffisantes
Le port est libre, pourquoi ça ne démarre toujours pas. Deux causes sont les plus fréquentes, et les messages d'erreur ne se ressemblent pas du tout.
La première : l'adresse d'écoute n'existe pas sur la machine. Après un changement de datacenter, une reconstruction d'instance ou un renouvellement DHCP qui change l'IP, l'ancienne IP dans le fichier de configuration n'est plus reconnue :
n8n webserver failed, exiting listen EADDRNOTAVAIL: address not available 10.9.9.9:5679C'est ce que j'obtiens en mettant N8N_LISTEN_ADDRESS à 10.9.9.9, cette machine n'a pas cette adresse sur sa carte réseau. Si tu vois EADDRNOTAVAIL ne cherche pas du côté du port, va ip addr voir quelles IP existent réellement sur la machine, ou écris simplement 127.0.0.1。
La seconde : les permissions. Les ports inférieurs à 1024 nécessitent root, ou la capacité CAP_NET_BIND_SERVICE Cette erreur est levée par Node, pas emballée par n8n, donc elle inclut une pile node:events :
node:events:505
    throw er; // Unhandled 'error' event
    ^
Error: listen EACCES: permission denied 0.0.0.0:80
    at Server.setupListenHandle [as _listen2] (node:net:2306:21)
Je ne recommande pas de démarrer n8n sur le port 80 pour simplifier. Une couche de reverse proxy apporte beaucoup : renouvellement de certificats, gzip, limitation de débit, liste blanche d'IP, tout cela est plus simple que le système intégré à n8n, et on peut modifier la configuration sans redémarrer n8n. Si vraiment il faut utiliser directement le port 80, alors accorde les permissions correctement. Ma propre machine tourne en root, par facilité ; sur une machine partagée par plusieurs personnes, je ne le recommande pas — n8n stocke les identifiants de tous tes services tiers, et une fois les permissions du processus élargies, ce qui peut être dérobé l'est aussi.
ECONNREFUSED : qui vous refuse exactement
Cette erreur est en fait émise par n8n lors de la deuxième phase de démarrage : il tente de se connecter à la base de données, le port en face ne répond pas, et le noyau renvoie directement un RST. n8n réessaie 5 fois, avec des intervalles de 1 seconde, 2 secondes, 4 secondes, 8 secondes, 16 secondes, soit environ 31 secondes au total, puis abandonne et quitte.
Initial database connection attempt 1 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 1000ms
Initial database connection attempt 2 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 2000ms
Initial database connection attempt 3 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 4000ms
Initial database connection attempt 4 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 8000ms
Initial database connection attempt 5 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 16000ms
There was an error initializing DB
There was an error initializing DB
Error: There was an error initializing DB
    at Start.exitWithCrash (/usr/lib/node_modules/n8n/src/commands/base-command.ts:361:28)
Le passage ci-dessus, je l'ai obtenu en remplaçant DB_TYPE par postgresdb et en pointant délibérément le port vers 5433 où personne n'écoute, copié tel quel.There was an error initializing DB Le double lancement est réel aussi, ce n'est pas une erreur de copier-coller de ma part, si vous voyez des lignes en double, ne doutez pas de vous-même.
Il faut bien comprendre la logique de retry : c'est un retry de « connexion à la base au démarrage », pas une « attente infinie ». Si vous voyez attempt 1, ne vous précipitez pas pour redémarrer, attendez 31 secondes ; si vous voyez 5 échecs complets, c'est vraiment injoignable, redémarrer cent fois ne changera rien.
Le port dans l'adresse est le seul indice utile.DB_POSTGRESDB_PORT Par défaut 5432, si vous voyez 5433 cela signifie que vous l'avez configuré vous-même, probablement une copie de configuration oubliée sans modification ; si vous voyez 127.0.0.1:5432 mais vous avez bien installé la base sur une autre machine, cela signifie que la variable d'environnement n'a pas pris effet — dans systemd Environment= une ligne erronée, dans Docker -e un élément manquant, et cela se produit.
Le cas le plus piégeux est dans le container. n8n tourne dans un container, la configuration indique DB_POSTGRESDB_HOST=127.0.0.1, ce 127.0.0.1 est le loopback du container lui-même, pas celui de l'hôte. La base tourne sur l'hôte, le container ne pourra jamais s'y connecter, et l'erreur reste ECONNREFUSED, identique en apparence à « la base n'est pas démarrée ». Soit vous mettez aussi la base dans le compose, en utilisant le nom de service comme host ; soit vous faites en sorte que le container reconnaisse l'adresse de l'hôte.
Vérifiez d'abord la connectivité depuis l'extérieur, c'est bien plus rapide que de deviner dans les logs n8n :
# nc -vz 127.0.0.1 5678
Connection to 127.0.0.1 5678 port [tcp/*] succeeded!
# nc -vz 127.0.0.1 5433
nc: connect to 127.0.0.1 port 5433 (tcp) failed: Connection refused
Si nc passe mais que n8n ne se connecte toujours pas, le problème vient des identifiants et du nom de la base, consultez les logs de postgres lui-même, ne tournez pas en rond du côté de n8n.
Le message «SQLite package has not been found installed»
C'est l'erreur la plus facilement mal interprétée de la deuxième partie du démarrage, je m'y suis moi-même heurté. Elle apparaît dans le scénario SQLite par défaut — c'est-à-dire lors de la toute première installation de n8n pour la grande majorité des gens. Le log ressemble à ceci :
Initial database connection attempt 1 failed: SQLite package has not been found installed. Try to install it: npm install sqlite3 --save. Retrying in 1000ms
Initial database connection attempt 2 failed: SQLite package has not been found installed. ...
...
Error: There was an error initializing DB
DriverPackageNotInstalledError: SQLite package has not been found installed. Try to install it: npm install sqlite3 --save.
    at SqliteLibrary.loadLibrary (/usr/lib/node_modules/n8n/node_modules/@n8n/typeorm/dist/driver/sqlite-pooled/SqliteLibrary.js:30:19)
On se laisse facilement emporter par la dernière partie de la pile d'appels et on croit que « l'initialisation de la DB a échoué » signifie que la base de données est cassée. La première ligne dit pourtant clairement :sqlite3 Ce module natif est absent. Lors de l'installation de n8n via npm, un module natif est compilé au passage ; un environnement de compilation incomplet, une mise à jour majeure de Node, ou l'ajout de --ignore-scriptslors de l'installation du paquet, peuvent tous provoquer cette absence. Ce log se trouve intercalé entre deux démarrages réussis de ma machine ; je n'ai pas noté à l'époque quelle étape l'avait corrigé, je sais seulement que cela n'a rien à voir avec la base de données elle-même.
Il y a trois pistes de correction, classées du coût le plus faible au plus élevé : installer l'environnement de compilation (python3、make、g++) puis réinstaller n8n ; ou activer N8N_REINSTALL_MISSING_PACKAGES=true, pour qu'il installe lui-même les paquets manquants au démarrage, que ce soit dans le Dockerfile ou dans systemd ; si c'est trop pénible, passer à l'image Docker, où ces modules natifs sont déjà compilés. La phrase npm install sqlite3 --save dans l'erreur concerne le scénario « n8n installé comme dépendance locale » ; la recopier telle quelle en installation globale ne fonctionne pas forcément.
Au passage, une note sur les versions requises : n8n exige Node 20.19 à 24.x ; en dehors de cette plage, Node provoque divers problèmes étranges de modules natifs. La mienne est en 24.21.0.
Impossible d'écrire dans le répertoire .n8n
L'échec de la première partie du démarrage, avec EACCES 和 mkdirdans l'erreur, indique qu'il n'arrive même pas à créer son propre répertoire de données..n8n Le répertoire contient les fichiers de base de données, les clés de chiffrement, la configuration ; si le répertoire n'est pas accessible en écriture, le démarrage est totalement impossible :
No encryption key found - Auto-generating and saving to: /root/n8n_noperm/.n8n/config
Error: Failed to load command "start"
Error: EACCES: permission denied, mkdir '/root/n8n_noperm/.n8n'
    at mkdirSync (node:fs:1410:26)
    at InstanceSettings.loadOrCreate (/usr/lib/node_modules/n8n/node_modules/n8n-core/src/instance-settings/instance-settings.ts:353:12)
Ce passage a un piège sournois :Il affiche d'abord « pas de clé, génération et sauvegarde vers un certain chemin », puis échoue ensuite. En ne regardant que la ligne précédente, on croit que tout va bien, alors qu'en réalité rien n'a été écrit. Le seul critère de jugement — y a-t-il ensuite Editor is now accessible via, sinon c'est qu'il n'a pas démarré.
Ce passage est le résultat de mon exécution avec l'utilisateur nobody, le répertoire cible étant sous /root , personne ne peut y écrire. En exploitation réelle, le cas plus courant est Docker : le n8n dans le container s'exécute avec l'utilisateur node d'uid 1000, et sur l'hôte, si le répertoire que vous avez mkdir est en root 700, une fois monté, cela produit cette erreur. La correction consiste à changer correctement le propriétaire du répertoire hôte, pas à ajouter toutes les permissions :
chown -R 1000:1000 /srv/n8n-datachmod 777 cela peut le faire démarrer, mais je ne le recommande pas. Ce répertoire contient le fichier de clé de chiffrement, lisible par tout utilisateur de la même machine, ce qui équivaut à accrocher la clé de tous les identifiants tiers de la base à la poignée de porte.
Mon ordre réel de diagnostic
En cas de problème, ne commencez pas par lire la première ligne du journal, suivez cet ordre, vous localiserez le segment en cinq minutes :
- Regarder l'état du service.
systemctl status n8noudocker ps -a. Le point important n'est pas active ou failed, maisRestartle nombre de fois etRestarting (1) 3 seconds agoce genre de boucle. Une boucle indique qu'il redémarre et meurt en boucle, allez voir les journaux, ne vous acharnez pas sur systemd. - Trouver les journaux.Essayez d'abord
journalctl -u n8n -n 50. Sur ma machine, il renvoie-- No entries --, car l'unité redirige la sortie vers un fichier :StandardOutput=append:/data/logs/n8n.out.log. Dans ce cas, directementtail -100 /data/logs/n8n.out.log. Docker, c'estdocker logs --tail 100 n8n。 - Comptez le nombre de redémarrages.
grep -c 'n8n ready on' /data/logs/n8n.out.log, sur ma machine c'est 30. Les logs sont écrits en append, tout l'historique est là, la même erreur qui revient en boucle signifie un redémarrage cyclique. - Vérifiez le port.
ss -ltnp 'sport = :5678', reportez-vous au tableau ci-dessus. - Vérifiez l'état de santé.
curl -s http://127.0.0.1:5678/healthz. Si le processus est vivant, il répondra{"status":"ok"}, cela ne consulte pas la base de données.
Le journalctl de l'étape 2 renvoie vide, ce qui laisse facilement croire que le service n'écrit aucun log. Le service est pourtant géré par systemd, mais les logs sont dans un fichier. Donc d'abord systemctl cat n8n vérifiez s'il y a une redirection, c'est plus rapide que de fouiller les logs tête baissée.
Côté Docker, deux étapes de plus :docker ps -a la colonne STATUS affichera Restarting (1) 3 seconds ago, le chiffre entre parenthèses qui ne cesse d'augmenter indique des redémarrages répétés ; si les ports ne correspondent pas, vérifiez d'abord docker port n8n, il liste les ports de l'hôte et les ports du container. Chez moi c'est installé via npm, je n'ai pas reproduit moi-même les messages d'erreur dans le container, ces points sont rédigés selon le comportement courant de Docker.
Comment savoir si c'est vraiment démarré
Le port qui écoute ne signifie pas que ça fonctionne. n8n a deux endpoints de vérification prêts à l'emploi, la différence est très utile :
# curl -s -o /dev/null -w '%{http_code}n' http://127.0.0.1:5678/healthz
200
# curl -s http://127.0.0.1:5678/healthz
{"status":"ok"}
# curl -s -o /dev/null -w '%{http_code}n' http://127.0.0.1:5678/healthz/readiness
200
/healthz 200 indique seulement que le processus répond, il ne consulte pas la base de données./healthz/readiness C'est ce qui signifie « base de données connectée, migrations terminées ». Dans les dizaines de secondes après un redémarrage, le premier peut déjà être à 200 alors que le second ne suit pas encore, ce qui veut dire que les migrations tournent encore. Pour un script de monitoring, utilisez readiness, pas healthz — seul le premier reflète « cette machine peut-elle recevoir du trafic ».
Une fois les deux à 200, faites un test réel :
- ouvrez l'éditeur, connectez-vous, voyez la liste des workflows, pas d'écran blanc avec un spinner.
- Lancez un workflow avec un nœud Code, succès. Cette étape valide le task runner, souvent négligé comme mentionné plus haut.
- Publiez (publish) le workflow, faites-le tourner une fois pour de vrai, l'historique d'exécution doit montrer cette exécution de production avec un statut réussi.
Ne sautez pas le troisième point. Certains déploiements ont un éditeur parfaitement fonctionnel mais n'exécutent rien à l'heure prévue, la cause étant que le worker en mode queue n'est pas connecté, ce genre de problème ne se révèle qu'en exécutant réellement une fois.
Le message « service refused connection » dans l'interface
En cas d'échec au démarrage, vous ne pouvez pas du tout accéder à l'interface, donc cette section traite d'un autre cas — n8n est démarré, mais ce à quoi le workflow se connecte ne l'est pas. Les directions de diagnostic de ces deux types de pannes sont totalement opposées, ne les confondez pas.
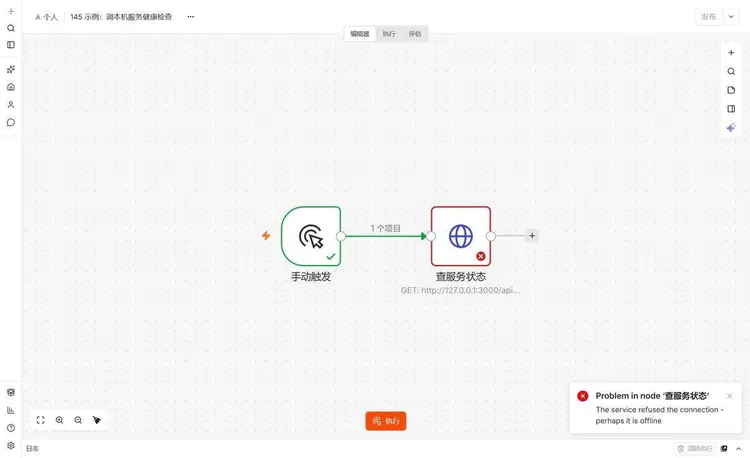
Après un échec d'exécution, le nœud sur le canevas est rouge, une popup s'affiche en bas à droite Problem in node '查服务状态', avec une petite ligne en dessous The service refused the connection - perhaps it is offline. Cette phrase est la version traduite en langage humain par n8n, elle ne mentionne ni le port ni le protocole.
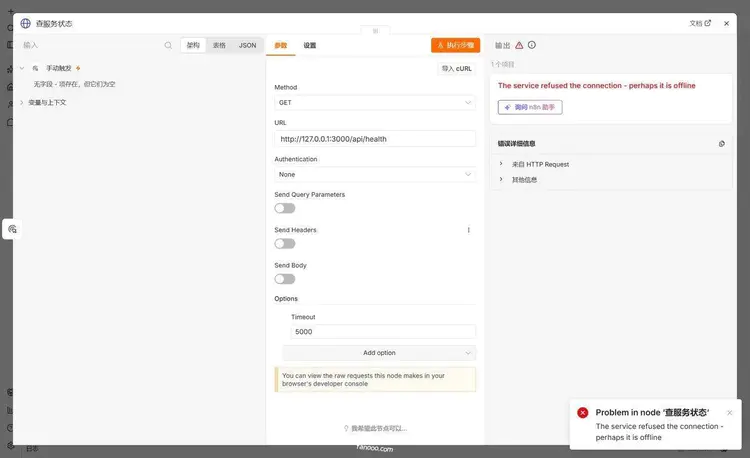
Double-cliquez sur le nœud, faites défiler le panneau de sortie à droite, il y a un bloc replié « Détails de l'erreur », cliquez dessus pour voir le message brut.
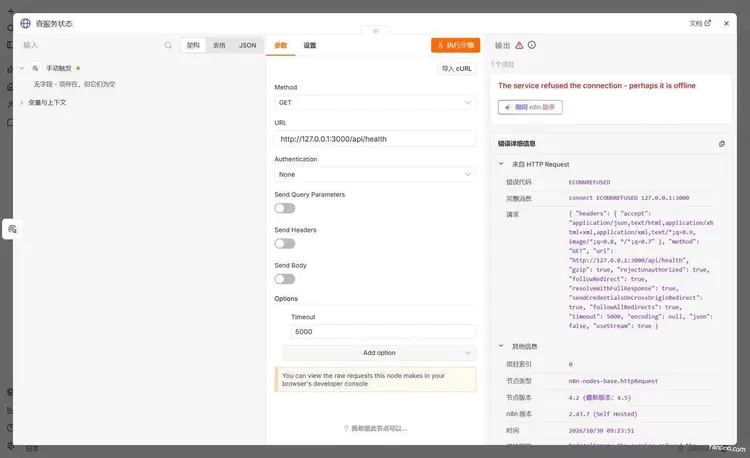
La ligne « Code d'erreur » est ECONNREFUSED, le « Message complet » est connect ECONNREFUSED 127.0.0.1:3000. On retrouve ici l'erreur du démarrage, même code d'erreur, sauf que cette fois elle se produit dans le nœud. Prenez ce port et testez avec nc -vz, on sait tout de suite si ça passe.
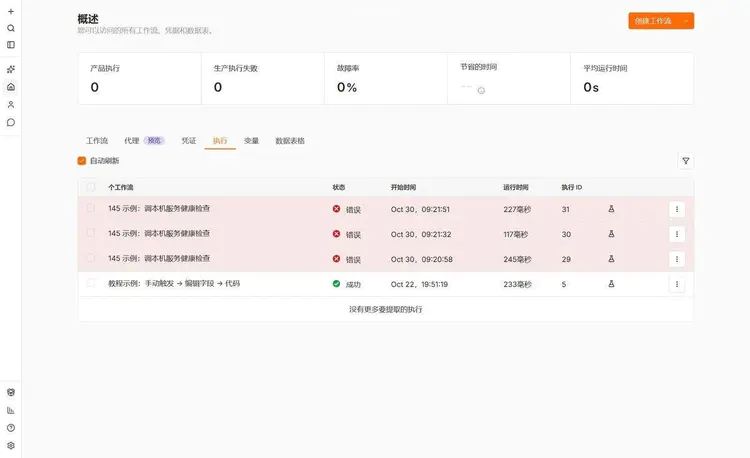
L'historique d'exécution offre un autre critère gratuit : le temps d'exécution. Mes trois exécutions ont pris respectivement 227, 117, 245 millisecondes. Une telle rapidité signifie que même la poignée de main TCP n'a pas abouti ; si le pair s'était connecté mais avait renvoyé un 500, ou en cas de timeout, la durée aurait été de plusieurs centaines de millisecondes à plusieurs secondes, voire aurait atteint le timeout que vous avez défini. Une erreur en dessous de deux cents millisecondes pointe directement vers « port/adresse/service non démarré » ; chercher du côté de « réponse incorrecte de l'interface » est une perte de temps.
Aide-mémoire des six messages d'erreur bruts
| Message d'erreur brut | Où ça bloque | Piste de traitement |
|---|---|---|
n8n's port 5678 is already in use... |
Troisième partie, port | ss -ltnp 'sport = :5678' Trouver le pid, arrêter l'ancien ou changer de port |
n8n webserver failed, exiting listen EADDRNOTAVAIL |
Troisième partie, adresse | L'IP dans la configuration n'existe pas sur la machine,ip addr Vérifier |
Error: listen EACCES: permission denied 0.0.0.0:80 |
Troisième partie, permissions | Les ports inférieurs à 1024 nécessitent des privilèges, changer de port ou ajouter des capabilities |
Initial database connection attempt N failed: connect ECONNREFUSED |
Deuxième partie, base de données | Attendre les 5 tentatives complètes, puis nc -vz host port |
DriverPackageNotInstalledError: SQLite package has not been found installed |
Deuxième partie, dépendances | 补 sqlite3, ou réinstaller n8n |
EACCES: permission denied, mkdir '/.../.n8n' |
Première partie, répertoire | Le propriétaire du répertoire de données est incorrect, changer le owner, pas 777 |
Trois rappels de sécurité
Les écoutes temporairement élargies pendant le diagnostic, pensez à les rétablir.Pour vérifier de l'extérieur si le service a démarré, remplacez N8N_LISTEN_ADDRESS par 0.0.0.0 ou ajoutez une ligne -p 5678:5678, puis oubliez-le une fois vérifié. L'éditeur de n8n exposé sur l'Internet public n'est qu'un formulaire de connexion ; un script de balayage peut essayer des milliers de fois par jour. Ma machine n'écoute que sur 127.0.0.1, le public passe par nginx 443, c'est l'état normal, ne le passez pas en état temporaire pour le dépannage puis ne le laissez pas traîner.
Avant de coller les logs quelque part, passez-les au crible.Les logs de démarrage contiennent l'URL webhook complète, et le chemin webhook lui-même est un identifiant : quiconque obtient le chemin peut injecter des données dans votre workflow ; la pile contient le chemin d'installation, l'adresse interne, le nom d'hôte de la base de données. Avant de coller dans un groupe ou de poster sur un forum pour demander de l'aide, remplacez ces éléments, puis collez.
Ne mettez pas le mot de passe de la base de données sur la ligne de commande.docker run -e DB_POSTGRESDB_PASSWORD=xxx Il restera dans l'historique du shell, et apparaîtra aussi dans docker inspect la sortie de , toute personne sur la même machine pouvant exécuter des commandes docker le verra. Utilisez --env-file, ou le EnvironmentFile=de systemd, permissions du fichier 600. L'unité collée plus haut est écrite ainsi, le mot de passe est dans /etc/n8n/instance-ai.env , pas dans l'unité.
Résumé
Un échec de démarrage semble très varié, mais il se résume en fait à quatre étapes : clé, base de données, écoute, migration. La ligne sur laquelle le journal s'arrête détermine la commande à taper ; deviner ne sert à rien — la phrase « est-ce qu'un autre n8n tourne déjà ? » est là pour tromper.
Trois commandes suffisent :ss -ltnp 'sport = :端口' trouver le processus qui occupe le port,nc -vz host 端口 vérifier la connectivité,curl /healthz/readiness vérifier l'état de préparation. Le reste consiste à consulter le tableau de cet article en fonction du message d'erreur original.
Un dernier retour d'expérience :n8n ready on 和 Editor is now accessible via l'intervalle entre les deux est ce qui est le plus souvent pris pour un état déjà bon. Redémarrer avant la fin de la migration, ou couper carrément l'alimentation, est la « petite opération » au coût le plus élevé que j'aie vue.
Continuer plus bas
L'article précédent est« Premier workflow : déclenchement manuel → édition de champs → code »; pour construire un flux de bout en bout, voir cet article. Si ce n'est pas encore installé, voir« Comment installer n8n »; si l'interface n'est pas familière, consulter« Visite guidée de l'interface ». J'ai regroupé les incidents isolés dansDépannagepage, la table des matières du cours complet se trouve àici。
Références
- Monitor n8n:
/healthzVérifie uniquement que le processus est actif,/healthz/readinessexige que la base de données soit connectée et que la migration soit terminée - Variables d'environnement Deployment:
N8N_PORTPar défaut 5678,N8N_LISTEN_ADDRESSPar défaut::、N8N_USER_FOLDERutilisation de - Variables d'environnement Database:
DB_TYPEPar défaut sqlite,DB_POSTGRESDB_PORTPar défaut 5432, ainsi que les paramètres de reprise automatique en cas de déconnexion pendant l'exécution - Variables d'environnement Logs:
N8N_LOG_OUTPUTPar défaut console, une fois configuré en file, les logs atterrissent dans<n8n 目录>/logs/n8n.log - Utiliser la ligne de commande:
n8n start、n8n export:workflowCes commandes côté serveur, la plupart ne nécessitent pas que n8n soit en cours d'exécution - Installer avec Docker: le mappage de port de la commande run officielle et
/home/node/.n8n卷 - Installer avec npm: plage de versions Node 20.19 à 24.x
- Erreurs Node.js:
EADDRINUSE、ECONNREFUSED、EACCES、EADDRNOTAVAILleurs définitions respectives
Dernière mise à jour : 30 octobre 2026, avec n8n 2.43.7.



