Workflow, Node, Connection, Execution : quatre mots pour clarifier l’univers de n8n


Sur le canvas, il y a cinq blocs et quatre lignes. Exportez cela en JSON, il ne reste que deux clés :nodes 和 connections. Les enregistrements d'exécution sont ailleurs, alignés un par un, chacun avec un numéro.
Les trois endroits parlent de la même chose, avec quatre mots : workflow, node, connection, execution. Une fois ces quatre mots clarifiés, lire n'importe quel tutoriel sur les nodes devient plus facile ; si vous ne les clarifiez pas, vous continuerez à osciller entre « j'ai clairement cliqué sur exécuter » et « pourquoi ça n'a pas tourné ».
Pas besoin de savoir coder. Un n8n installé qui s'ouvre et sur lequel vous avez exécuté un workflow une fois suffit (si ce n'est pas installé, voircet article, et si l'interface ne vous est pas encore familière, parcourez d'abordla visite guidée de l'interface). La mienne est en 2.43.7, votre version mineure peut différer, l'emplacement des boutons peut varier légèrement.
- Quatre mots, quatre choses
- Workflow : un container, plus deux états
- Node : le nom est la clé primaire
- Connection : un tableau à deux niveaux, le premier niveau est l'index de sortie
- Execution : une exécution, avec un snapshot
- Vue d'ensemble : l'ordre d'un dépannage
- Comment savoir si vous avez vraiment compris
- Cinq erreurs sur lesquelles on tombe vraiment
- Risques liés à l'export, au partage et à la traçabilité
Quatre mots, quatre choses différentes
Commençons par un tableau comparatif ; les sections suivantes le détaillent point par point.
| 词 | Ce que c'est | Où cela se trouve | Relation de quantité |
|---|---|---|---|
| Workflow | Un ensemble de nodes reliés pour accomplir une tâche | La table des workflows dans la base de données, un fichier JSON | 1 workflow contient N nodes |
| Node | Une unité d'exécution, qui effectue une étape | Dans le JSON du workflow nodes Dans le tableau |
1 nœud appartient à 1 workflow |
| Connection | Relier la sortie du nœud précédent à l'entrée du suivant | du même JSON connections dans l'objet |
1 workflow a N lignes |
| Execution | Ce workflow a été exécuté une fois | Table d'exécution, indépendante du workflow | 1 workflow a N exécutions |
La ligne la plus facile à confondre est la dernière. Le workflow est le plan, l'exécution est la construction. Modifiez le plan dix fois, les constructions précédentes ne changent pas.
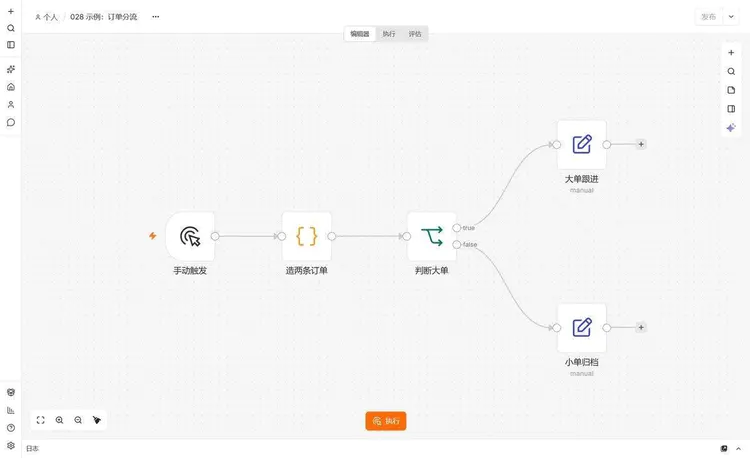
Workflow : un container, plus deux états
La définition officielle est très courte : un ensemble de nœuds connectés pour accomplir automatiquement quelque chose ; le trigger se déclenche, vous cliquez manuellement, un autre flux l'appelle, il commence à s'exécuter, nœud par nœud, avec possibilité de branchement, de fusion et de boucle.
La définition n'a rien à redire. Ce qu'il faut vraiment surveiller, c'est l'état supplémentaire apparu après la 2.x :Un brouillon et une version publiée sont deux choses différentes。
Vous modifiez des éléments sur le canevas, n8n les enregistre automatiquement, la persistance en base se fait en une à cinq secondes, il n'y a pas de bouton d'enregistrement. Mais cela ne fait qu'enregistrer dans le brouillon. Pour mettre les modifications en ligne, il faut cliquer sur « Publier » en haut à droite, pour épingler une version précise en production. Ensuite, les timers, les Webhook et les événements applicatifs exécutent tous cette version épinglée, pas celle actuellement affichée à l'écran.
Cette règle résout un ancien problème (une modification à moitié terminée percutée par une tâche planifiée), mais crée aussi un nouveau piège : on modifie les paramètres et on oublie de publier, la production exécute encore la logique d'hier, alors que le canevas semble parfaitement normal. La première fois que je l'ai rencontré, j'ai fixé les deux jeux de paramètres pendant dix minutes avant de me rappeler que le bouton en haut était encore actif.
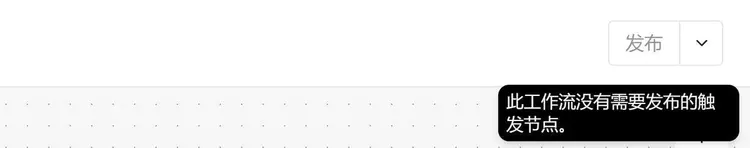
Cela explique aussi pourquoi le premier workflow de certaines personnes ne peut absolument pas être « activé ». Avec seulement un déclencheur manuel, il n'a pas de forme de production par nature, et le bouton de publication reste toujours grisé. Pour planifier, ajoutez un Schedule Trigger ; pour recevoir des requêtes externes, ajoutez un Webhook. Avec ce type de déclencheur, le bouton s'active.
C'est plus clair vu depuis l'interface : sur mon instance, le workflow nouvellement créé active 是 false,activeVersionId 是 null, n'a qu'un seul versionId qui suit chaque modification. S'il n'a jamais été publié, il n'y a pas de version en ligne.
Node : le nom est la clé primaire
Un nœud est une unité d'exécution. Certains servent à démarrer (déclencheurs), d'autres récupèrent des données, en envoient, en calculent, d'autres ne font que du contrôle de flux, une seule ligne IF peut aussi être un nœud.
Dans le JSON, un nœud contient sept éléments :
{
  "parameters": { "jsCode": "return [{ json: { amount: 620 } }];" },
  "id": "n2",
  "name": "造两条订单",
  "type": "n8n-nodes-base.code",
  "typeVersion": 2,
  "position": [-400, 0]
}type: c'est le type de nœud.n8n-nodes-base.codec'est le nœud Code,-base.la partie suivante est le nom du nœud en minuscules.typeVersion: la version de la définition du nœud. Pour un même nœud, les différentes versions ont une structure de paramètres qui change. Dans la mienne, IF est2.2, Edit Fields est3.5, Code est2, Manual Trigger est1. Ce nombre, ce n'est pas vous qui le remplissez, il est inscrit lors de sa création selon la définition de l'époque.parameters: tout ce que vous remplissez dans le panneau de droite se trouve ici. Si vous changez de type de nœud, tout ce bloc est remplacé.position: coordonnées du canevas, purement pour l'affichage, sans rapport avec l'ordre d'exécution.id: identifiant court utilisé en interne par le workflow, la copie d'un nœud en génère un nouveau.
name Le plus discret en apparence, mais en réalité le point le plus piégeux parmi ces quatre termes :c'est la clé primaire. Les connexions enregistrent le nom, pas l'id.
J'ai renommé « 小单归档 » en « 小单归档(改) » sur le canevas, les quatre liens n'ont pas été rompus, et après sauvegarde, dans l'API le connections a aussi suivi et est devenu le nouveau nom — c'est l'interface qui l'a corrigé pour vous. Autrement, si vous modifiez directement le namedans le JSON sans toucher aux connexions, le serveur refusera sur-le-champ, et l'erreur en signale même deux d'un coup :
Workflow structure is invalid. nodes[4].name (duplicate_node_name):
Duplicate node name "大单跟进"; connections.判断大单.main[1][0].node
(unknown_connection_target): Connection target "小单归档" does not
reference an existing node
la première phrase dit qu'il y a un doublon de nom, la seconde dit qu'une ligne pointe vers un nœud inexistant. Les deux phrases sont en fait les deux faces d'une même chose : vous avez renommé un nœud avec le nom d'un autre, et le nom évincé, les connexions pointent toujours vers lui.
Donc pour le nom des nœuds, je recommande de les nommer comme des variables : n'utilisez pas des choses comme « Set » ou « Code 1 », et ne les renommez pas tous les deux jours. Les espaces, parenthèses et caractères chinois dans le nom sont acceptables, n8n les reconnaît, mais quand vous écrivez vous-même dans une expression $('小单归档(改)') il est facile d'oublier une parenthèse.
Connection : tableau à deux niveaux, le premier niveau est le numéro de sortie
Une connexion consiste à relier la sortie d'un nœud à l'entrée d'un autre nœud. Dans le JSON, cela ressemble à ceci :
"connections": {
  "造两条订单": { "main": [[{ "node": "判断大单", "type": "main", "index": 0 }]] },
  "判断大单": { "main": [
    [{ "node": "大单跟进", "type": "main", "index": 0 }],
    [{ "node": "小单归档", "type": "main", "index": 0 }]
  ]}
}
Décortiquons : la clé la plus externe estle nom du nœud source;main est le type de connexion (flux de données normal ; pour l'ensemble AI, c'est ai_tool、ai_languageModel ceux-ci) ; l'index du tableau internecorrespond au numéro de la sortie; à l'intérieur se trouve la liste des cibles, une sortie peut être reliée à plusieurs downstream.
Le jugement de commande importante comporte deux groupes, donc c'est [[...],[...]]. Le premier groupe correspond au point marqué true sur le nœud, le second groupe correspond à false. À première vue, on pourrait croire qu'il y a trop de tableaux imbriqués, mais en réalité c'est simplement « quelle sortie → reliée à qui ».
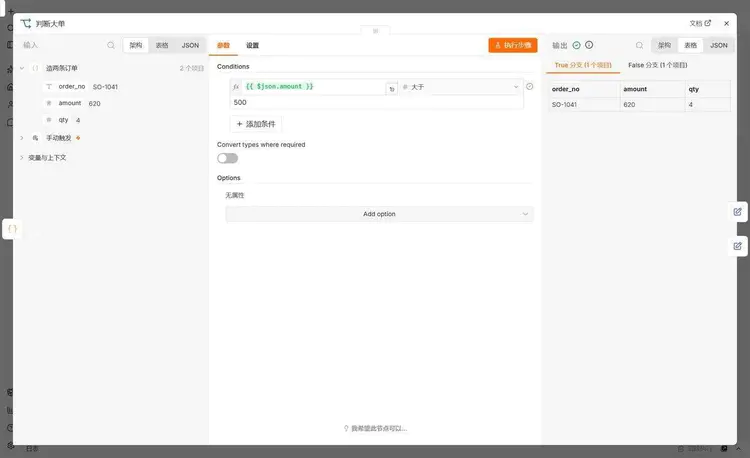
Il y a ici un malentendu conceptuel qu'il vaut la peine de dissiper. Beaucoup de gens pensent que IF est un « choix binaire » : si la condition est vraie on va par ici, sinon on va par là, et on ne prend qu'un seul chemin.
Non. IF estun routage par élément. Je lui fais recevoir deux commandes, 620 et 180, et le résultat est 1 élément dans la branche true, 1 élément dans la branche false, les deux lignes sont activées. Si vous lui passez 100 données, il répartit chaque élément selon son propre montant des deux côtés, il peut y avoir 30 éléments à gauche et 70 à droite, ou bien 0 d'un côté.
Donc quand on dit « les nœuds après le IF ne se sont pas exécutés », il faut d'abord vérifier si ce côté-là n'a tout simplement pas de données. Ce n'est pas une panne.
Execution : une exécution, avec un snapshot
Une exécution, c'est le fait que ce workflow a été lancé une fois. Un clic manuel compte pour une fois, un déclenchement de timer compte pour une fois, une requête Webhook compte pour une fois. Cela ne fait pas partie du JSON du workflow, c'est stocké dans une autre table, relié par workflowId un mount
Les champs qui m'intéressent dans un enregistrement d'exécution :
| Champ | Valeur dans cet enregistrement | À quoi ça sert |
|---|---|---|
id |
35 | Une séquence auto-incrémentée pour toute l'instance, pas un redémarrage à 1 par workflow |
workflowId |
9biNEw9D0DqWOVV1 | À quel workflow il appartient |
mode |
manual | exécution manuelle ou exécution en production |
status |
success | succès, échec, annulation, plantage, en attente |
startedAt / stoppedAt |
01:17:42.352 / 01:17:42.513 | un écart de 161 millisecondes, c'est le « en 161 millisecondes » affiché dans l'interface |
workflowVersionId |
un uuid | quelle version a été exécutée cette fois |
La dernière ligne est facile à négliger mais très utile : l'exécution se base sur la version. Si vous modifiez des paramètres sans publier, la production continue d'exécuter l'ancienne version, et l'enregistrement d'exécution référence l'id de l'ancienne version.
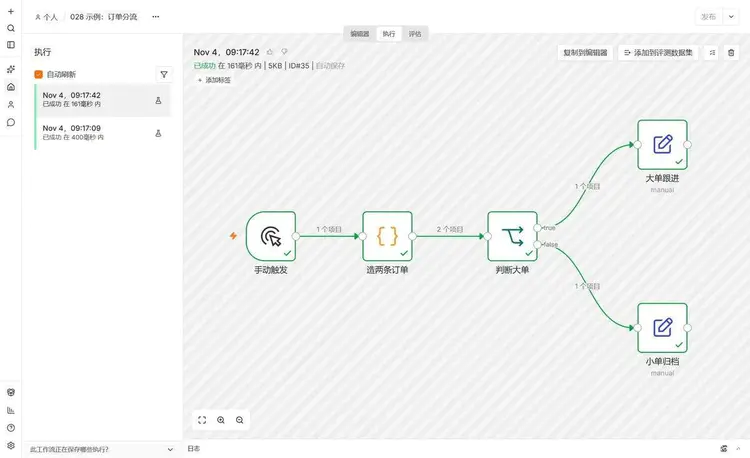
Un autre détail que je n'avais remarqué qu'à cette occasion : chaque exécution stocke un snapshot du workflow tel qu'il était à ce moment-là (workflowData). Après avoir renommé « 小单归档 » en « 小单归档(改) », je suis retourné consulter l'exécution de 09:17:42 : le canevas affichait toujours « 小单归档 » — parce que le rendu utilise le snapshot propre à cette exécution, pas votre canevas actuel.
Cela explique deux choses. Le bon côté : modifier des paramètres, supprimer des nœuds, les anciens enregistrements ne sont pas altérés ; en revenant enquêter sur un problème, on voit l'état des lieux de l'époque. Le mauvais côté : si vous comparez un ancien enregistrement avec le canevas actuel, les noms de nœuds peuvent ne pas correspondre ; ne croyez pas que vous avez mal mémorisé.
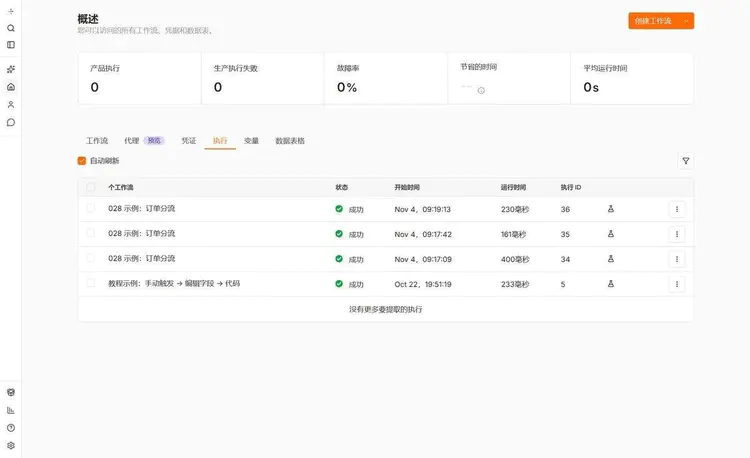
La durée de conservation est un problème concret. Le nettoyage automatique est activé par défaut : suppression au-delà de 336 heures (14 jours), et au-delà de 10000 entrées au total, suppression à partir des plus anciennes. Succès et échecs sont conservés, les exécutions manuelles aussi. La première des deux règles atteinte l'emporte : un workflow exécuté toutes les 5 minutes, soit 288 fois par jour, atteint 4032 entrées en 14 jours, c'est l'âge qui tranche en premier ; un workflow exécuté 2000 fois par jour atteint dix mille au cinquième jour, c'est le nombre d'entrées qui tranche en premier. Donc « cette exécution n'est pas dans la liste » ne signifie pas forcément qu'elle n'a pas tourné, elle a peut-être déjà été nettoyée.
Vue d'ensemble : l'ordre d'un dépannage
Les quatre termes sont compréhensibles séparément, mais leur utilisation exige un ordre. Mon habitude est de procéder de l'extérieur vers l'intérieur :
- Vérifiez d'abord l'état de l'historique d'exécution. S'il n'y a pas d'enregistrement, cela signifie que rien n'a été déclenché — le problème se situe au niveau du trigger ou de l'état de publication, pas dans les nodes.
- Si l'état est « échec », cliquez pour voir quel node est en rouge. Consultez l'entrée dans les détails du node ; la plupart du temps, l'entrée est déjà incorrecte.
- Si l'état est « succès » mais que le résultat est erroné, vérifiez le nombre d'éléments sur les connexions. Si une connexion affiche 0, les nodes en aval ne font évidemment rien.
- Si les chiffres sont corrects mais les champs incorrects, c'est seulement à ce moment qu'il faut suspecter les paramètres du node, ou que l'upstream a modifié le type.
L'avantage de cet ordre est que chaque étape permet d'éliminer un grand nombre de possibilités. À l'inverse, si l'on se précipite sur le code du node Code, on passe souvent une demi-heure avant de découvrir que l'upstream n'a envoyé que 0 élément.
Comment savoir si l'on a vraiment compris
Pas besoin de mémoriser les définitions ; faire trois choses suffit, chacune avec un résultat observable.
Premièrement, comptez.Combien de blocs sur le canvas, autant dans le JSON exporté nodes le array devrait en contenir autant. Le mien en a 5, la longueur du array est 5. Le nombre de connexions est identique : 4 lignes correspondent à connections 4 clés source (le nœud de jugement des grosses commandes contient deux groupes dans une clé, mais cela reste 4 lignes).
Deuxièmement, modifiez une connexion.Supprimez les nodes de la branche false, puis exportez à nouveau,判断大单 le deuxième groupe du array devrait devenir un array vide, et non disparaître entièrement. Cette étape vous permet de retenir que « la sortie est déterminée par la position, pas par la présence ou l'absence de downstream ».
III. Exécuter deux fois.Après l'exécution, allez dans « Toutes les exécutions » ; il devrait y en avoir une de plus, avec un ID supérieur de 1 à la précédente, et l'horodatage correspondant au moment où vous avez cliqué. Modifiez ensuite un paramètre, sans publier, exécutez une fois, puis allez voir en ligne (planification ou Webhook) si c'est toujours l'ancien paramètre qui est utilisé — s'il s'agit de votre véritable activité, il est recommandé de faire cette étape sur un workflow de test.
Cinq erreurs que vous rencontrerez vraiment
1. Deux nœuds portent le même nom.Après avoir copié un nœud, vous avez oublié de le renommer, ou vous avez modifié le JSON à la main. À l'enregistrement, le serveur refuse, renvoie Duplicate node name, et en même temps émet un unknown_connection_target. Ne paniquez pas en voyant les deux ; il suffit de rétablir un nom unique.
2. Le nom du nœud a été modifié, mais pas l'expression.Les connexions sont complétées automatiquement par l'interface, les expressions non. Le nœud précédent s'appelait A, vous utilisez en aval $('A').item.json.amount pour récupérer les données ; après l'avoir renommé en B, cette expression ne trouve plus rien, et l'erreur pointe vers la ligne de l'expression, pas vers le renommage.
3. Le bouton de publication est grisé.Le workflow ne contient qu'un déclencheur manuel, rien qui puisse être mis en ligne. En survolant avec la souris, il est indiqué « Ce workflow n'a aucun nœud déclencheur à publier ». Ajoutez un Schedule Trigger ou un Webhook pour pouvoir publier.
4. Après modification des paramètres, la tâche planifiée exécute toujours l'ancienne logique.C'est le brouillon qui a été modifié, sans cliquer sur publier. Ce type de problème est le plus difficile à diagnostiquer, car le canevas, les paramètres et les exécutions de test sont tous normaux ; seul le comportement en ligne est incorrect.
5. Impossible de retrouver l'historique d'exécution.Trois possibilités : dépassement de la période de rétention et nettoyage, suppression du workflow entraînant la perte des enregistrements associés, ou désactivation de l'option « enregistrer aussi les succès » (EXECUTIONS_DATA_SAVE_ON_SUCCESS=none). Les deux premières sont les plus fréquentes.
Risques liés à l'export, au partage et à la traçabilité
Le JSON d'un workflow peut être exporté en entier et envoyé à quelqu'un. Trois endroits peuvent fuiter des informations.
Le texte en clair dans les paramètres.Les credentials eux-mêmes ne sont pas dans le JSON (seule une référence par nom y figure), mais parameters peut contenir de tout : token dans l'URL, key écrite à la main dans les en-têtes HTTP, path du Webhook.grep Un passage key、token、Bearer et on renvoie, l'affaire de deux minutes.
Les enregistrements d'exécution contiennent les données brutes.Ce que le node a exécuté, l'enregistrement en conserve le texte original : numéro de commande, nom du client, adresse, tout y est. En auto-hébergement, on contrôle soi-même la période de rétention ; réduire EXECUTIONS_DATA_MAX_AGE est la solution la plus simple ; sur une instance partagée par plusieurs personnes, mieux vaut la définir dès le départ.
Coller directement un JSON envoyé par quelqu'un d'autre.Le coller revient à exécuter son code sur votre instance ; le JS dans un node Code ne vous demandera pas si vous voulez l'exécuter. Un workflow de source inconnue se teste dans une instance de test vide, on regarde d'abord, on décide ensuite.
En résumé
Un workflow est un plan, un nœud est un bloc sur ce plan, une connexion est une flèche entre les blocs, et une exécution est l'acte de construire en suivant ce plan. Ces quatre mots correspondent à quatre choses différentes, leurs positions ne sont pas les mêmes, et les conséquences d'une modification non plus : modifier les paramètres d'un nœud affecte chaque exécution future, modifier un enregistrement d'exécution ne change rien (c'est un enregistrement, par nature), renommer fait suivre les connexions mais pas nécessairement les expressions.
S'il fallait vraiment que j'en choisisse un à retenir en premier, ce serait le fait que « l'exécution embarque un snapshot ». Cela explique à la fois pourquoi les anciens enregistrements ne vous trompent pas, pourquoi les nouvelles modifications ne prennent pas forcément effet, et pourquoi après la période de rétention on ne retrouve plus rien.
Pour juger si vous avez compris, il y a une méthode simple : ouvrez n'importe quel workflow fait par quelqu'un d'autre, sans regarder le canevas, seulement le JSON exporté, et voyez si vous pouvez dire combien de nœuds il exécutera, combien de chemins, et lequel est un passage à vide. Si vous y arrivez, ces quatre mots sont acquis.
On continue ensuite
Ceux qui n'ont pas encore fait tourner leur premier workflow, lisez d'abord《Premier workflow : déclenchement manuel → édition de champ → code》, cet article explique comment connecter trois nœuds et les faire tourner. Les erreurs au démarrage, l'occupation de port et autres problèmes d'accès, c'estici. Le sommaire du cours complet est surcette page, tout ce qui concerne les nœuds se trouve souscette catégorie.
Parmi les triggers, le type planifié est le plus sujet aux problèmes, un article dédié :Workflow planifié qui ne se déclenche pas : 5 causes à vérifier une par une。
Références
- Key concept glossary: les définitions officielles des termes workflow, node, execution, publish ; c'est là-dessus que cet article s'aligne
- Understand workflows: ce qu'est un workflow, ainsi que les quatre volets création de workflow, composants, exécution
- Connect nodes together: création et suppression de connexions, la sortie d'un node reliée à l'entrée d'un autre node
- Save and publish workflows: la plage temporelle de la sauvegarde automatique, la publication qui fige la version en ligne, l'exécution de production qui utilise la version publiée
- Understand executions: la différence entre exécution manuelle et exécution de production, quelles exécutions sont comptées dans le quota
- If: les types de données et modes de comparaison des conditions, deux sorties
- Executions variables d'environnement: conservation 336 heures, limite 10000 entrées, succès et échecs sont tous conservés, ces valeurs par défaut
Dernière mise à jour : 4 novembre 2026, avec n8n 2.43.7.



