Qu’est-ce que n8n ? Initiation pour débutants, cas d’usage et parcours d’apprentissage


Si vous cherchez « qu'est-ce que n8n » en ligne, vous verrez probablement cette réponse : un outil d'automatisation de workflows open source qui permet de connecter différentes applications. Ce n'est pas faux, mais ça ne dit rien — cela ne vous dit pas pour qui cet outil travaille réellement, ni quel temps il vous fait gagner.
Pour le dire simplement : n8n est un outil qui transforme ce que vous faites répétitivement à la main en un pipeline capable de tourner tout seul.
Ceci est le premier article de la série complète, avec un seul objectif : avant de passer à la pratique, que vous compreniez ce que c'est, ce que ça peut faire, et si ça vaut la peine d'apprendre. Après lecture, vous devriez pouvoir répondre à une question — laquelle de mes tâches est adaptée pour lui être confiée.
À qui cela s'adresse, ce qu'il faut préparer avant de commencer
Aucune expérience en automatisation n'est nécessaire. Pas besoin de savoir programmer, pas besoin d'acheter un serveur, ni même d'installer un logiciel au préalable. Cet article ne traite que des concepts et du raisonnement, la partie pratique est dans le suivant.
Si vous avez déjà utilisé Zapier ou écrit des scripts, concentrez-vous sur les sections trois et quatre, qui expliquent leurs différences concrètes et vous aident à juger s'il faut changer.
Regardons d'abord à quoi ça ressemble en fonctionnement
Les concepts, c'est bien beau, mais un coup d'œil vaut mieux. L'image ci-dessous est le premier workflow d'exercice que j'ai réalisé sur un serveur, trois blocs, exécuté une fois de gauche à droite, en 233 millisecondes.
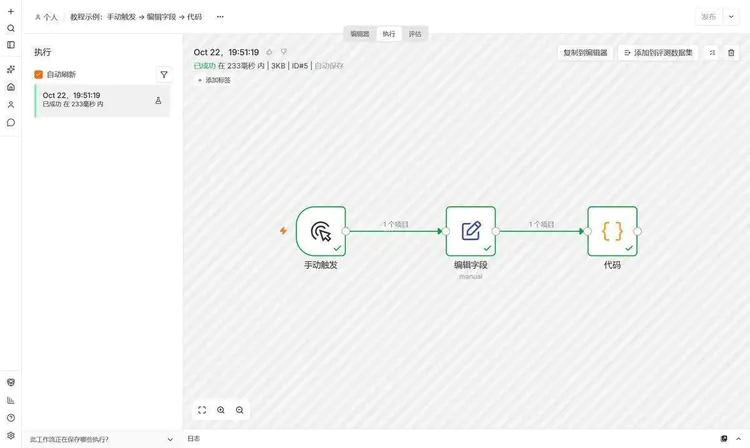
Les trois blocs dans l'image s'appellentnœuds. Celui à l'extrême gauche avec l'éclair est le point de départ, appelé déclencheur, qui indique « où commence cette chose » ; celui du milieu s'appelle modifier les champs, chargé de créer deux champs ; celui de droite est un nœud de code, qui exécute un petit bout de JavaScript.
Les flèches entre les blocs indiquent la direction du flux de données. L'ensemble, du point de départ au point d'arrivée, s'appelleworkflow。
Ce que fait ce pipeline est très bête : créer deux valeurs « Fuzhou » et « 27 », et les assembler en une phrase. Mais transposez cela à un vrai métier, c'est confier à la machine la chaîne d'actions « ouvrir une page web, copier des données, les coller dans un tableur, puis envoyer un e-mail ». La structure est identique.
Trois mots suffisent : nœud, connexion, workflow
- Nœud (Node): une action concrète. Envoyer une requête HTTP, lire une ligne de tableur, évaluer une condition, exécuter un bout de code, tout cela est un nœud. Dans la liste des nœuds de mon instance, on peut en parcourir près d'un millier, couvrant divers systèmes courants.
- Connexion: détermine qui vient avant qui. Les données circulent le long des lignes, peuvent se diviser, peuvent converger.
- Workflow: des nœuds plus des connexions, formant le processus complet d'une tâche. C'est le « produit » que vous créez dans n8n.
Le vrai seuil n'est pas dans ces trois termes, mais dans un concept :comment les données circulent entre les nœuds。
Dans n8n, les données sont toujours un « tableau d'éléments ». Le nœud précédent renvoie 10 lignes de données, elles arrivent au nœud suivant sous forme de 10 éléments, et le nœud suivant exécute son traitement sur chacun de ces 10 éléments, et non seulement sur la première ligne. Une fois ce point assimilé, la plupart des questions « pourquoi ma sortie est vide » qui surviennent ensuite, vous pourrez les diagnostiquer vous-même.
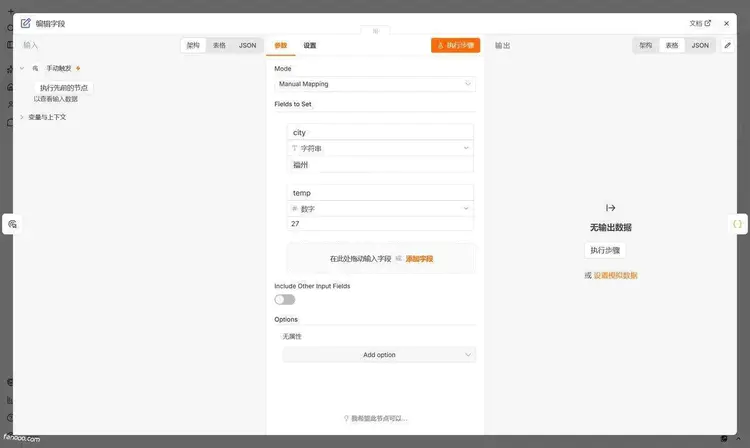
Ce panneau a été modifié dans n8n 2.x. Entrée à gauche, paramètres au centre, sortie à droite, pas besoin de basculer entre les onglets pendant le débogage, bien plus pratique que la 1.x — beaucoup de tutoriels chinois en ligne sont encore sur l'interface 1.x, si vous les suivez les emplacements ne correspondront pas, c'est l'un des points les plus déroutants pour les débutants.
Un autre petit détail : mon instance est installée en chinois simplifié, mais vous remarquerez que les noms de paramètres restent en anglais, Mode, Fields to Set, Include Other Input Fields, etc. La traduction chinoise de n8n ne couvre que l'interface, les paramètres des nœuds ne sont pas traduits, ne paniquez pas en voyant l'anglais, remplissez simplement en vous y référant.
Quel problème cela résout-il au juste
La plupart du travail répétitif au bureau est, par essence, la même chose :Déplacer les données de A vers B, et en profiter pour changer leur forme.
Un exemple. Un client remplit un formulaire sur le site → vous recopiez les informations dans un tableau → vous envoyez un message au commercial → trois jours plus tard, vous lui rappelez de faire un suivi. Quatre étapes, aucune n'est difficile, mais à vingt répétitions par jour c'est pénible, et vous en oublierez forcément.
C'est exactement ce que fait n8n : acheminer les données là où elles doivent aller, au bon moment, selon les bonnes conditions, sans erreur, puis notifier au passage les personnes concernées.
Retenez bien ce positionnement. Il ne produit pas de données et ne prend pas de décisions à votre place. Une fois cela clair, vous n'attendrez pas de lui qu'il « analyse les ventes de ce mois pour moi » — ce genre de tâche n'est pas de son ressort, elle repose sur une base de données et des scripts.
Comparé à Zapier, Make et l'écriture de scripts maison, où se situent les différences
| n8n | Zapier | Make | Écrire ses propres scripts | |
|---|---|---|---|---|
| Mode de déploiement | Version cloud ou auto-hébergement | Cloud uniquement | Cloud uniquement | À votre convenance |
| Logique de facturation | L'auto-hébergement ne facture pas à l'usage | Selon le nombre de tâches | Selon le nombre d'opérations | Seul le serveur est compté |
| Liberté | Élevée, possibilité d'écrire du code | 中 | Plutôt élevée | Maximale |
| Difficulté de prise en main | 中 | La plus facile | Plutôt abrupte | Selon les personnes |
| Qui est responsable de la maintenance | Soi-même | Plateforme | Plateforme | Soi-même |
Parlons un peu du ressenti réel. Zapier est le plus simple, utilisable dès l'inscription, au prix d'une facturation au nombre de tâches : dès que le volume monte, la facture devient difficile à regarder, et pour un traitement de données un peu tordu, il faut chercher des contournements. Make offre une visualisation plus poussée, permet de dessiner de vraies branches et boucles, à un prix modéré, mais l'interface a un coût d'apprentissage plus élevé.
n8n se distingue sur deux points : il peut être déployé soi-même, les données restent sur sa propre machine ; il ne facture pas au nombre de tâches, on peut l'exécuter autant de fois que voulu sans payer en plus, le coût se réduit au serveur. Le prix à payer est bien réel — mises à jour, sauvegardes, pannes au milieu de la nuit, tout est à votre charge. Ce n'est pas un détail, j'y consacrerai une partie dédiée à l'exploitation.
Quant à écrire soi-même des scripts Python : c'est plus flexible, mais sans interface, changer une condition impose de modifier le code, et en cas de problème, aucun historique d'exécution à consulter. Ma répartition est la suivante — les traitements de données ponctuels et à la logique tordue, en script ; ce qui doit tourner régulièrement sur la durée, montrer la progression à des humains et se connecter à plusieurs systèmes externes, dans n8n.
Une remarque en passant sur la licence de n8n. Ce n'est pas une licence open source standard, c'est la Sustainable Use License du modèle fair-code. Usage personnel ou interne à l'entreprise, aucun problème ; mais si vous voulez emballer n8n et le revendre à des clients, lisez bien les clauses avant, ne partez pas d'idées préconçues.
Quelles tâches lui confier, lesquelles éviter
Celles qui conviennent ressemblent基本上 toutes à ceci :
- Synthèse planifiée : récupérer chaque matin des informations de plusieurs sources, dédupliquer et générer un briefing matinal
- Déclenchement par événement : quelqu'un soumet un formulaire, envoie un e-mail, le statut d'une commande change — classification automatique, mise en base, notification
- Synchronisation de systèmes : rapprochement entre tableurs, bases de données, CRM, avec les écarts listés séparément
- Pipeline de contenu : collecte, nettoyage, réécriture par IA, relecture humaine, publication planifiée
- Surveillance et alertes : site down, erreur d'API, anomalie de données — que quelqu'un le sache immédiatement
- Tâches liées à l'IA : intégrer un grand modèle dans les processus métier, pour la classification, l'extraction, le question-réponse
Ce qui ne convient pas doit aussi être dit clairement, pour vous éviter des détours :
- Le trading haute fréquence en temps réel à l'échelle de la milliseconde, ce n'est pas pour cela qu'il est conçu
- Pour les calculs complexes et les algorithmes, écrire directement du code est plus simple
- Un processus qui ne s'exécute qu'une fois par mois et prend dix minutes à la main devient plus difficile à maintenir s'il est transformé en workflow
Quelle est la relation entre n8n et l'IA
Si n8n est populaire ces deux dernières années, c'est en grande partie grâce à l'IA. Il intègre des nœuds pour se connecter aux grands modèles, ainsi qu'une série complète de nœuds pour créer des Agents : fournir des outils et de la mémoire au modèle, et le laisser décider lui-même de l'ordre d'appel.
Mais il faut doser. Un workflow est déterministe : si la condition est remplie, on va à gauche, sinon à droite, et le résultat est identique après cent exécutions. Ce n'est pas le cas d'un modèle : avec le même prompt, il peut classer correctement aujourd'hui et se tromper demain.
Mon principe est le suivant : confier les tâches déterministes aux nœuds, confier les tâches ambiguës au modèle, et toujours conserver une validation humaine pour les étapes impliquant de l'argent et des engagements. Ce principe s'appliquera à tous les articles liés à l'IA qui suivront.
Combien cela coûte-t-il
Deux voies, avec des structures de coûts totalement différentes.
Utiliser la version cloud officielle : paiement mensuel, pas d'installation ni de maintenance, le prix est celui du site officiel (il peut être ajusté, je ne fixe pas de chiffre). Auto-hébergement : le logiciel lui-même ne coûte rien, le coût est celui d'un serveur ; 2 cœurs et 4 Go suffisent largement pour les tâches quotidiennes, une machine à quelques centaines de yuans par an suffit. Ce qui coûte vraiment cher, c'est le temps : installation, configuration, mise à niveau et dépannage sont à votre charge.
Cloud ou auto-hébergement, comment décider
Le critère de décision est en fait unique :Ces données peuvent-elles sortir de votre machine.
Pour traiter des données telles que des listes de clients, des commandes ou des dossiers médicaux, l'auto-hébergement est recommandé. Si vous ne vous connectez qu'à des informations publiques et faites juste un rappel RSS, le cloud est plus simple. L'auto-hébergement présente aussi deux pièges spécifiques à la Chine : l'accès du serveur aux API à l'étranger peut échouer, il faut traiter le réseau séparément ; inversement, la version cloud ne peut pas non plus accéder aux systèmes du réseau interne de votre entreprise. Ce point est bien plus important que le prix, ne découvrez pas trop tard que vous ne pouvez pas récupérer les données.
Quels prérequis faut-il pour l'apprendre
Savoir copier-coller et comprendre un tableau suffit pour commencer ; la première phase ne nécessite absolument aucune écriture de code.
Mais en avançant vers le milieu du parcours, on se heurte à deux murs : le JSON, à quoi ressemblent les données et comment en extraire un niveau ; et le HTTP, ce que signifient requête, réponse et code de statut. Pas besoin de les maîtriser, mais on ne peut pas les contourner. Plus loin, pour faire de l'AI et des Agent, il faut savoir lire une erreur et juger soi-même s'il s'agit d'un problème de données ou de configuration.
Comment suivre le parcours, de zéro à l'utilisation
J'ai découpé tout le processus en 8 phases, chaque phase ayant un livrable clair, décrit dansle parcours d'apprentissagesur cette page. Ici, je donne seulement trois rappels sur l'ordre :
- Installez d'abord n8n de façon stable, puis faites les workflows. Un volume de données mal configuré, et supprimer le container efface tous les workflows : j'ai vu ce genre de chose plus d'une fois.
- Faites d'abord fonctionner un petit processus sous la main, puis apprenez de nouveaux nœuds. Lire la documentation sans produire, on oublie tout en une semaine.
- Ne vous précipitez pas sur l'AI. Si le flux de données et la gestion des erreurs ne sont pas compris, brancher un modèle ne fera que rendre le problème plus difficile à diagnostiquer.
Les quatre endroits où les débutants se trompent le plus facilement
Courir après les nouveaux nœuds.La bibliothèque de nœuds compte près d'un millier de nœuds ; tout ce qui est inutile n'est que du bruit. Les vraiment fréquents ne sont qu'une vingtaine : déclencheur, HTTP, édition de champs, IF, Switch, Merge, boucle, code.
Ne tester que le chemin du succès.Les interfaces peuvent expirer, limiter le débit, renvoyer 500. Ceux qui trébuchent dès la première mise en production échouent presque tous là-dessus.
Ne pas regarder l'historique d'exécution.En cas d'erreur, consultez d'abord le premier nœud devenu rouge dans l'historique d'exécution, c'est bien plus rapide que de demander de l'aide dans le groupe.
Considérez n8n comme une plateforme low-code.Il peut écrire du code, mais sa force est la coordination, pas le calcul. Confiez les tâches lourdes à des scripts ou à une base de données.
Rappel de sécurité
Un n8n auto-hébergé revient à placer les clés d'une partie de vos systèmes sur cette machine. Trois choses sont indispensables : liez un domaine avec HTTPS, n'exposez pas le port 5678 à nu sur l'Internet public ; accordez aux API Key utilisées par n8n uniquement les permissions nécessaires ; lors de la sauvegarde, n'oubliez pas la clé de chiffrement de n8n — si la clé est perdue, les identifiants dans la base de données ne pourront plus être déchiffrés, et les données seules ne permettront pas de restaurer quoi que ce soit.
Résumé
n8n est un outil qui transforme les opérations répétitives en pipeline. Sa valeur ne réside pas dans le nombre de nœuds, mais dans le fait qu'après avoir écrit « comment faire cette chose », il l'exécute chaque jour, sans oublier ni omettre.
L'ordre d'apprentissage tient en trois phrases : installer stablement, faire fonctionner un cas, puis étendre vers l'extérieur.
Le prochain article explique concrètement comment installer :Comment installer n8n, tutoriel complet de déploiement local et de premier lancement pour débutants. Après l'installation, revenez exécuter le workflow à trois nœuds ci-dessus, cela sera bien plus fluide.
Références
- Documentation officielle de n8n
- Liste des nœuds d'intégration
- Instructions d'auto-hébergement
- Page de tarification officielle
Dernière mise à jour : 22 octobre 2026, avec n8n 2.43.7. Si votre version est plus récente, l'interface a peut-être encore changé de disposition.



