n8n 시작 오류와 port 점유 확인 방법


서버 쪽 n8n이 뜨지 않는 건 비교적 찾기 쉬운 유형의 장애다—반드시 한 줄의 오류를 남기기 때문이다. 문제는 그 오류 줄이 자주 엉뚱한 방향을 가리킨다는 점이다. 이 글을 쓰기 위해 나는 python으로 http.server를 띄워 port를 점유했는데, n8n은 여전히 「혹시 다른 n8n이 이미 실행 중인가요」라고 알려줬다.
아래에서는 「로그가 어느 줄에서 멈추는지」에 따라 시작 실패를 네 가지로 나누고, 각 유형마다 즉시 입력할 수 있는 명령 하나를 붙인다. 오류 원문은 모두 내 2.43.7에서 출력된 것이며 한 글자도 바꾸지 않았다.
자체 호스팅하는 사람에게 쓴다: npm 전역 설치, Docker 실행, systemd 관리 모두 해당된다. 클라우드 버전을 쓰는 사람은 건너뛰어라, 그쪽 시작은 네가 걱정할 일이 아니다. 전제 조건은 하나뿐이다, 기계의 shell에 로그인할 수 있거나 container 로그를 볼 수 있어야 한다.
- 시작은 네 단계 흐름이며, 로그가 어느 단계에서 멈추는지가 무엇을 확인할지를 결정한다
- port가 점유됨: 세 개의 명령, 그리고 사람을 속이는 안내 한 줄
- port가 점유되지 않았는데도 뜨지 않음: 주소 오류, 권한 부족
- ECONNREFUSED, 도대체 누가 너를 거부하는가
- 「SQLite package has not been found installed」 그 줄
- .n8n 디렉터리에 쓸 수 없음
- 내 실제排查 순서
- 어떻게 해야 정말로 뜬 것으로 간주하는가
- 인터페이스의 그 「서비스가 연결을 거부했습니다」라는 문구
- 여섯 개 오류 원문 속검
- 세 가지 보안 알림
시작은 네 단계 흐름이며, 로그가 어느 단계에서 멈추는지가 무엇을 확인할지를 결정한다
정상 기동이 어떤 모습인지 한 번 기억해 두세요. 그렇지 않으면 로그가 중간에 끊겼을 때 어느 부분이 빠졌는지 전혀 알 수 없습니다. 이것은 제 그 기계에서의 완전한 기동입니다. 빈 디렉터리에서 시작합니다:
No encryption key found - Auto-generating and saving to: /data/n8n/.n8n/config
Initializing n8n process
n8n ready on 127.0.0.1, port 5678
Migrations in progress, please do NOT stop the process.
Starting migration InitialMigration1588102412422
Finished migration InitialMigration1588102412422
Editor is now accessible via:
「No encryption key found」 그 줄은 첫 기동 시에만 나타나고, 이후에는 키가 이미 .n8n/config 에 기록되어 있어 더 이상 출력되지 않습니다. 키라는 것은 데이터베이스와 한 쌍입니다. 키를 바꾸면 데이터베이스에 저장된 자격 증명을 전부 풀 수 없게 되는데, 그건 다른 글의 주제입니다. 여기서는 이것이 기동 첫 단계에 속한다는 것만 기억하면 됩니다.
저는 전체 흐름을 네 블록으로 나눴습니다. 각 블록의 실패 오류 형태는 완전히 다릅니다:
| 순서 | 하는 일 | 이 단계가 실패했을 때의 전형적인 오류 |
|---|---|---|
| 1 | 설정 파일 읽기, 암호화 키 로드 또는 생성 | EACCES: permission denied, mkdir、Failed to load command "start" |
| 2 | 데이터베이스 연결, 기본 5회 재시도 포함 | Initial database connection attempt N failed: connect ECONNREFUSED、SQLite package has not been found installed |
| 3 | HTTP 리스닝 시작 | n8n's port 5678 is already in use、n8n webserver failed, exiting listen EADDRNOTAVAIL |
| 4 | 데이터베이스 마이그레이션 실행, task runner 기동 | Migrations in progress 이후에는 한 줄도 없이 Finished프로세스가 사라짐 |
특히 오판하기 쉬운 세부 사항이 하나 있습니다:n8n ready on 127.0.0.1, port 5678 는 사용 가능과 같지 않습니다. 이것은 Migrations in progress 이전에 port는 이미 열려 있었고, DB는 아직 업그레이드 중이었다. 이때 editor를 열면 안 되는 것은 정상이니, migration이 끝날 때까지 기다려야 한다.
네 번째 단락에는 2.x에만 있는 것이 하나 더 있다: Code node는 main process에서 실행되지 않고, n8n이 별도로 하나를 띄운다 n8n task-runner. ps로 부모-자식 관계를 보면 알 수 있다.
# ps -o pid,ppid,etime,cmd -p 1053,7782
    PID    PPID   ELAPSED CMD
   1053       1  6-09:37:45 n8n start
   7782    1053  6-09:33:32 n8n task-runner
main process는 있고 runner는 없으면, main UI는 열리지만 Code node를 실행하는 순간 error가 난다. 이런 증상을 보면 code를 의심하지 말고 먼저 ps runner가 있는지 확인해야 한다.
port가 점유됨: 명령 세 개, 그리고 사람을 속이는 안내 문구 하나
먼저 n8n이 스스로 뭐라고 하는지 보자. port가 충돌할 때 stack을 쏟아내지 않고, 사람 말 한 줄만 남긴 뒤 process가 종료되고 exit code는 1이다:
n8n's port 5678 is already in use. Do you have another instance of n8n running already?이 문장은 80%의 주의를 "또 다른 n8n"으로 끌어간다. 실제로는: port를 점유하고 있는 것은 무엇이든 될 수 있다. 나는 python3 -m http.server 5693 5693을 점유한 뒤 n8n을 5693으로 지정했는데, 그래도 이 문장을 그대로 말했다. 추측은 소용없으니 확인해야 한다.
# ss -ltnp 'sport = :5678'
State  Recv-Q Send-Q Local Address:Port Peer Address:Port Process
LISTEN 0      511        127.0.0.1:5678      0.0.0.0:*    users:(("n8n start",pid=1053,fd=24))
ss Debian, Ubuntu, CentOS에 모두 기본 포함되어 있고, 출력이 가장 깔끔하며 pid도 바로 준다. filter 문법을 기억하기 싫다면,lsof 그것도 된다. 다만 process 이름에 escape가 붙는다:
# lsof -i :5678 -sTCP:LISTEN
COMMAND    PID USER   FD   TYPE DEVICE SIZE/OFF NODE NAME
n8nx20st 1053 root   24u  IPv4  33852      0t0  TCP localhost:5678 (LISTEN)
n8nx20st 깨진 문자가 아니라,x20 공백이며, 실제 이름은 n8n start이다. 처음 보면 낯선 program이라고 생각할 수 있으니 당황하지 말자. pid만 원한다면,fuser 가장 간편하다:
# fuser -n tcp 5678
5678/tcp:             1053
pid를 확인하고,ps -o pid,etime,cmd -p <pid> 그것이 얼마나 오래 실행되었는지 본다. 이 단계에서 완전히 다른 두 가지 상황을 구분할 수 있다.
하나는 자신의 오래된 프로세스가 죽지 않은 경우다.systemd에서 stop 했거나, docker rm 했는데 프로세스가 여전히 백그라운드에 남아 있는 경우다. etime에 몇 시간짜리 n8n이 표시되면 기본적으로 이것이다. 깔끔한 방법은 먼저 systemctl stop n8n하고, 그다음 kill하는 것이지, 처음부터 kill -9하지 않는 것이다 — 마이그레이션이 절반쯤 쓰이다가 강제 종료되면 데이터베이스가 업그레이드 중간 상태에 걸릴 수 있고, 그러면 백업을 복원해야만 복구할 수 있다.
다른 하나는 다른 서비스가 당신의 port를 점유한 경우다.클라우드 호스트에서 8080, 3000 같은 port가 패널이나 어떤 Node 소규모 서비스에 의해 조용히 점유되는 것은 흔한 일이다. 이때는 두 가지 길밖에 없다: 상대가 자리를 비켜주게 하거나, 자신이 port를 바꾸는 것이다.N8N_PORT=5679 바꾸는 것은 1분이면 되지만, 한 곳만 바꾸지 마라 — reverse proxy,WEBHOOK_URL、N8N_EDITOR_BASE_URL 에 하드코딩된 port가 함께 틀어지고, webhook을 받지 못하는 것이 바로 이렇게 해서 생긴다.
또 다른 상황은 port 충돌처럼 보이지만 실제로는 listen address의 문제다. n8n의 N8N_LISTEN_ADDRESS 기본값은 ::, dual-stack는 IPv4까지 함께 덮습니다. 그래서 다른 사람이 점유한 것이 127.0.0.1:5678, 기본값으로 n8n을 시작해도 마찬가지로 뜨지 않습니다. 제가 실측해봤는데: python은 127.0.0.1:5694에만 바인딩했고, n8n은 기본 주소로 5694에서 시작했는데, 여전히 "port 5694 is already in use"가 나왔습니다.
덧붙여 말하자면,:: 전부 열면 또 다른 문제가 생깁니다: n8n이 모든 네트워크 인터페이스에 직접 노출되는데, 공인망 쪽 인터페이스도 포함됩니다. 제这台의 경우는 반대로 써서, 로컬만 리슨하고 외부는 nginx에 맡깁니다.
Environment=N8N_HOST=127.0.0.1
Environment=N8N_LISTEN_ADDRESS=127.0.0.1
Environment=N8N_PORT=5678
Environment=N8N_PROTOCOL=http
포트가 점유되지 않았어도 뜨지 않음: 주소를 잘못 썼거나 권한이 부족함
포트가 비어 있는데 왜 여전히 뜨지 않는가. 두 가지 원인이 가장 흔한데, 오류 메시지는 전혀 다른 모습입니다.
첫 번째, 리슨 주소가 로컬에 존재하지 않음. IDC를 옮겼거나, 인스턴스를 재생성했거나, DHCP 갱신으로 IP가 바뀌면, 설정 파일에 있는 그 옛 IP는 아무도 인식하지 못합니다:
n8n webserver failed, exiting listen EADDRNOTAVAIL: address not available 10.9.9.9:5679이건 제가 N8N_LISTEN_ADDRESS 를 10.9.9.9로 써서 나온 것입니다. 그 머신의 네트워크 인터페이스에는 이 주소가 없습니다. EADDRNOTAVAIL 를 보면 포트를 조회하지 말고, ip addr 로 로컬에 실제로 어떤 IP가 있는지 확인하거나, 그냥 127.0.0.1。
를 쓰세요. 두 번째, 권한. 1024 미만의 포트는 root가 필요하거나 CAP_NET_BIND_SERVICE 이 capability가 필요합니다. 이 계층의 오류는 Node가 던진 것이고 n8n이 래핑한 것이 아니므로, node:events 의 스택이 함께 나옵니다:
node:events:505
    throw er; // Unhandled 'error' event
    ^
Error: listen EACCES: permission denied 0.0.0.0:80
    at Server.setupListenHandle [as _listen2] (node:net:2306:21)
저는 편하려고 n8n을 80에서 시작하는 것을 권하지 않습니다. 리버스 프록시 한 계층을 두면 얻을 수 있는 것이 너무 많습니다: 인증서 갱신, gzip, rate limiting, ip 화이트리스트 모두 n8n 자체 것보다 편하고, 설정을 바꿔도 n8n을 재시작할 필요가 없습니다. 굳이 80을 직접 쓰겠다면, 제대로 권한을 주세요. 제那台는 root로 돌리고 있는데, 편하려고 그런 것입니다; 여러 명이 공유하는 머신에서는 이렇게 하는 것을 권하지 않습니다——n8n에는 모든 서드파티 서비스의 자격 증명이 저장되어 있어서, 프로세스 권한이 커지면 가져갈 수 있는 것도 함께 커집니다.
ECONNREFUSED는 대체 누가 당신을 거부하는가
이 오류는 사실 n8n이 두 번째 단계 시작 시 발생하는데, 데이터베이스에 연결하러 갔더니 상대 포트에서 응답이 없어 커널이 바로 RST를 반환하는 것이다. n8n은 1초, 2초, 4초, 8초, 16초 간격으로 5회 재시도하며 총 약 31초 후 포기하고 종료한다.
Initial database connection attempt 1 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 1000ms
Initial database connection attempt 2 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 2000ms
Initial database connection attempt 3 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 4000ms
Initial database connection attempt 4 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 8000ms
Initial database connection attempt 5 failed: connect ECONNREFUSED 127.0.0.1:5433. Retrying in 16000ms
There was an error initializing DB
There was an error initializing DB
Error: There was an error initializing DB
    at Start.exitWithCrash (/usr/lib/node_modules/n8n/src/commands/base-command.ts:361:28)
위 부분은 내가 DB_TYPE postgresdb로 바꾸고 포트를 아무도 리스닝하지 않는 5433으로 일부러 지정해서 출력한 것이며, 그대로 복사한 것이다.There was an error initializing DB 두 번 연속 실행한 것도 사실이며, 내가 복사 붙여넣기를 잘못한 것이 아니니 중복 줄을 봐도 자신을 의심하지 말라.
재시도에 대해 정확히 이해해야 한다: 이것은 '시작 시 DB 연결' 재시도이지 '영원히 기다리는' 것이 아니다. attempt 1을 보고 급하게 재시작하지 말고 31초를 기다려라; 5회 모두 실패하면 정말 연결이 안 되는 것이니 100번 재시작해도 마찬가지다.
주소의 포트가 유일하게 유용한 단서다.DB_POSTGRESDB_PORT 기본값은 5432이며, 5433이 보고된다면 직접 설정한 적이 있다는 뜻이고, 십중팔구 설정을 복사해놓고 수정하는 것을 잊은 것이다; 127.0.0.1:5432 그런데 분명히 DB를 다른 머신에 설치했는데도 이렇게 나온다면 환경 변수가 적용되지 않은 것이니, systemd에서 Environment= 한 줄 잘못 썼거나 Docker에서 -e 하나 빠뜨리면 이렇게 된다.
가장 까다로운 경우는 컨테이너 안에 있다. n8n이 컨테이너에서 실행되고 설정에 DB_POSTGRESDB_HOST=127.0.0.1이 127.0.0.1은 컨테이너 자체의 루프백이지 호스트가 아니다. DB가 호스트에서 실행 중이라면 컨테이너에서는 어떻게 연결해도 안 되고, 여전히 ECONNREFUSED가 보고되어 'DB가 시작되지 않은' 것과 똑같아 보인다. DB도 compose에 넣고 서비스명을 host로 쓰거나, 컨테이너가 호스트 주소를 인식하게 해야 한다.
먼저 외부에서 연결성을 검증하는 것이 n8n 로그에서 추측하는 것보다 훨씬 빠르다:
# nc -vz 127.0.0.1 5678
Connection to 127.0.0.1 5678 port [tcp/*] succeeded!
# nc -vz 127.0.0.1 5433
nc: connect to 127.0.0.1 port 5433 (tcp) failed: Connection refused
nc가 통과했는데 n8n이 여전히 연결되지 않는다면 문제는 자격 증명과 DB 이름에 있으니, postgres 자체 로그를 확인하고 n8n 쪽에서 맴돌지 말라.
"SQLite package has not been found installed" 그 항목
이 항목은 시작 두 번째 단락에서 가장 오해하기 쉬운 오류인데, 나도 직접 겪었다. 이것은 기본 SQLite 시나리오, 즉 대부분의 사람이 n8n을 처음 설치할 때 나타난다. 로그는 이렇게 생겼다:
Initial database connection attempt 1 failed: SQLite package has not been found installed. Try to install it: npm install sqlite3 --save. Retrying in 1000ms
Initial database connection attempt 2 failed: SQLite package has not been found installed. ...
...
Error: There was an error initializing DB
DriverPackageNotInstalledError: SQLite package has not been found installed. Try to install it: npm install sqlite3 --save.
    at SqliteLibrary.loadLibrary (/usr/lib/node_modules/n8n/node_modules/@n8n/typeorm/dist/driver/sqlite-pooled/SqliteLibrary.js:30:19)
사람은 쉽게 마지막 스택에 끌려가 "DB 초기화 실패"를 데이터베이스가 망가졌다고 생각한다. 첫 줄이 사실 명확히 말해준다:sqlite3 이 네이티브 모듈이 없다. npm으로 n8n을 설치할 때 네이티브 모듈을 함께 컴파일하는데, 컴파일 환경이 완전하지 않거나, Node 메이저 버전을 업그레이드했거나, 패키지 설치 시 --ignore-scripts를 추가하면 이 부분이 누락된다. 이 로그는 내 그 머신의 두 번 성공한 시작 기록 사이에 끼어 있었는데, 당시 어느 단계에서 고쳐졌는지 기록하지 못했고, 데이터베이스 자체와 무관하다는 것만 알았다.
수정 경로는 세 가지인데, 비용이 작은 것부터 큰 것 순으로: 컴파일 환경(python3、make、g++)을 설치한 후 n8n을 재설치하거나; N8N_REINSTALL_MISSING_PACKAGES=true를 켜서 시작 시 스스로 빠진 패키지를 보충 설치하게 하면 되는데, Dockerfile이나 systemd에 작성해도 된다; 손대기 어려우면 Docker image로 바꾸면 되고, image 안에는 이 네이티브 모듈들이 컴파일되어 있다. 오류 속 그 npm install sqlite3 --save 문구는 "n8n을 로컬 의존성으로 설치"하는 시나리오를 위한 것이므로, 전역 설치 시 그대로 따라 하면 효과가 없을 수 있다.
덧붙여 버전 요구 사항을 기록해 두자: n8n은 Node 20.19에서 24.x를 요구하며, 이 범위를 벗어난 Node에서는 각종 이상한 네이티브 모듈 문제가 발생한다. 내 이 머신은 24.21.0이다.
.n8n 디렉터리에 쓸 수 없음
시작 첫 단락의 실패인데, 오류에 EACCES 和 mkdir가 포함되어 있으면 자신의 데이터 디렉터리조차 만들 수 없다는 뜻이다..n8n 디렉터리에는 데이터베이스 파일, 암호화 키, 설정이 저장되는데, 디렉터리에 쓸 수 없으면 완전히 시작할 수 없다:
No encryption key found - Auto-generating and saving to: /root/n8n_noperm/.n8n/config
Error: Failed to load command "start"
Error: EACCES: permission denied, mkdir '/root/n8n_noperm/.n8n'
    at mkdirSync (node:fs:1410:26)
    at InstanceSettings.loadOrCreate (/usr/lib/node_modules/n8n/node_modules/n8n-core/src/instance-settings/instance-settings.ts:353:12)
이 단락에는 함정이 하나 있는데:먼저 "키가 없으므로 생성하여 특정 경로에 저장합니다"를 출력한 다음에야 실패한다. 앞의 그 줄만 보면 모든 게 순조롭다고 생각하게 되지만, 실제로는 한 글자도 기록되지 않았다. 판단 기준은 하나뿐이다 — 뒤에 Editor is now accessible via가 있는지, 없으면 뜨지 않은 것이다.
이 부분은 내가 nobody 사용자로 실행했고, 대상 디렉터리가 /root 아래에서 출력된 것으로, 누구도 쓸 수 없다. 실제 운영에서는 Docker가 더 흔하다: container 안의 n8n은 uid 1000의 node 사용자로 실행되는데, 호스트에서 네가 mkdir 한 디렉터리가 root 700이면 mount했을 때 바로 이 오류가 난다. 해결법은 호스트 디렉터리의 소유자를 올바르게 바꾸는 것이지, 권한을 최대로 주는 것이 아니다:
chown -R 1000:1000 /srv/n8n-datachmod 777 뜨게 할 수는 있지만, 나는 권하지 않는다. 그 디렉터리에는 암호화 키 파일이 있어서 같은 머신의 어떤 사용자든 읽을 수 있으므로, DB 안의 모든 서드파티 자격 증명 열쇠를 문손잡이에 걸어둔 셈이다.
내 실제排查 순서
문제가 생겼을 때 로그 첫 줄부터 읽지 말고, 이 순서대로 가면 5분 안에 구간을 특정할 수 있다:
- 서비스 상태를 본다.
systemctl status n8n또는docker ps -a. 중요한 것은 active냐 failed냐가 아니라,Restart횟수와Restarting (1) 3 seconds ago같은 루프다. 루프는 반복적으로 시작하고 반복적으로 죽는다는 뜻이니, 로그를 보러 가고 systemd에서 씨름하지 마라. - 로그를 찾는다.먼저 시도한다
journalctl -u n8n -n 50. 이 장비가 반환하는 것은-- No entries --, unit에서 출력을 파일로 리다이렉트했기 때문이다:StandardOutput=append:/data/logs/n8n.out.log. 이런 경우 바로tail -100 /data/logs/n8n.out.log. Docker는docker logs --tail 100 n8n。 - 재시작 횟수를 세어본다.
grep -c 'n8n ready on' /data/logs/n8n.out.log, 이 장비는 30이다. 로그는 append로 기록되어 히스토리가 모두 남아 있고, 같은 오류가 반복해서 나타나면 루프 기동이다. - port를 확인한다.
ss -ltnp 'sport = :5678', 위의 내용과 대조해서 맞춰본다. - health를 검증한다.
curl -s http://127.0.0.1:5678/healthz. 프로세스가 살아 있으면 응답한다{"status":"ok"}, 이것은 데이터베이스를 보지 않는다.
2단계의 journalctl 가 빈 값을 반환하면 서비스가 로그를 전혀 쓰지 않았다고 착각하기 쉽다. 서비스는 분명히 systemd가 관리하는데 로그는 파일에 있다. 그러므로 먼저 systemctl cat n8n 리다이렉트가 있는지 확인하는 것이, 무작정 로그를 뒤지는 것보다 빠르다.
Docker 쪽은 두 단계가 더 있다:docker ps -a 의 STATUS 열에 Restarting (1) 3 seconds ago이라고 표시되는데, 괄호 안 숫자가 계속 올라가면 반복 재시작이다; port가 맞지 않으면 먼저 docker port n8n를 보라, host port와 container port를 나열해 준다. 내这台는 npm으로 설치했고, container 안의 오류 원문은 직접 찍어본 적이 없어서 이几条는 docker의 일반적인表现에 따라 썼다.
정말로 떴는지怎么 판단하는가
port가 listen 중이라고 해서 일할 수 있는 건 아니다. n8n에는 바로 쓸 수 있는 검사 endpoint가 두 개 있는데, 차이가 실용적이다:
# curl -s -o /dev/null -w '%{http_code}n' http://127.0.0.1:5678/healthz
200
# curl -s http://127.0.0.1:5678/healthz
{"status":"ok"}
# curl -s -o /dev/null -w '%{http_code}n' http://127.0.0.1:5678/healthz/readiness
200
/healthz 200은 process가 응답할 수 있다는 것만 의미하고, database는 보지 않는다./healthz/readiness 라야 「database 연결됨, migration도 완료됨」이다. 재시작 후 수십 초 동안 전자는 이미 200일 수 있고 후자는 아직 따라오지 못할 수 있는데,那就是 migration이 아직 돌고 있다는 뜻이다. 모니터링 스크립트를 쓸 때는 readiness를 쓰고 healthz를 쓰지 마라——전자만이 「이机器가 traffic을 받을 수 있는가」를 반영한다.
둘 다 200이 된 후, 실제 작업을 한 번 돌려본다:
- editor를 열고, 로그인되고, workflow 목록이 보이고, 흰 화면에 로딩만 도는 게 아니다.
- Code node가 포함된 workflow를 아무거나 실행해서 성공. 이 단계가 검증하는 것은 task runner인데, 앞에서 말했듯 자주 간과된다.
- workflow를 publish해서 실제로 한 번 돌게 하고, execution 기록에서 이 production execution이 보이고 상태가 성공인지 확인한다.
세 번째 항목은 생략하지 마라. 어떤 배포에서는 editor가 모두 정상인데 정해진 시간에 실행되지 않는다, 원인은 queue mode에서 worker가 연결되지 않은 것이고, 이런 문제는 실제로 한 번 돌려야만 드러난다.
인터페이스에 나오는 「서비스가 연결을 거부했습니다」
시작 실패 시에는 인터페이스에 아예 들어갈 수 없으므로, 이 절에서 말하는 것은 다른 경우다——n8n은 떴는데 workflow에서 연결하는 것들이 뜨지 않은 경우. 이 두故障의排查 방향은 완전히 반대이므로 섞지 마라.
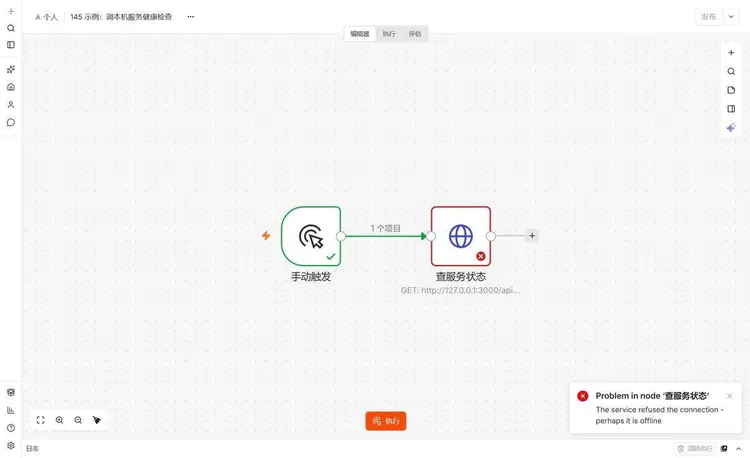
한 번 실행이 실패한 뒤, 캔버스上的 노드는 빨갛고, 오른쪽 아래에 팝업이 뜬다 Problem in node '查服务状态', 아래에 작은 글씨 한 줄 The service refused the connection - perhaps it is offline. 이 문장은 n8n이 번역한 사람 말이고, port도 말하지 않았고 protocol도 말하지 않았다.
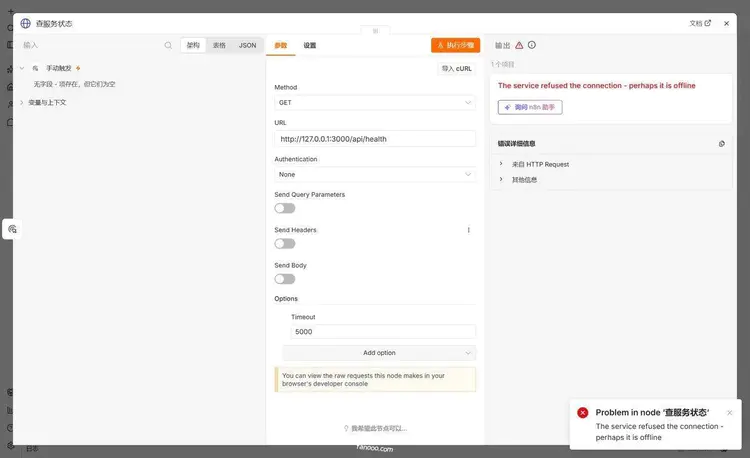
노드를 더블클릭하고, 오른쪽 출력 패널을 아래로 내리면 접힌 「오류 상세 정보」가 있는데, 펼쳐야 원본 정보를 볼 수 있다.
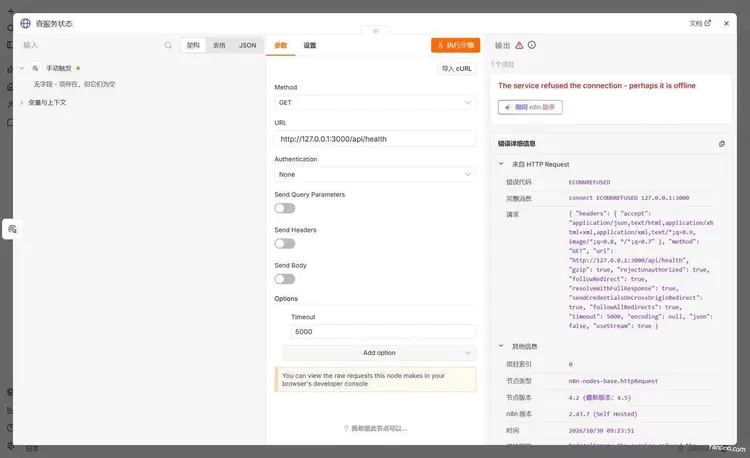
「오류 코드」 그 줄은 ECONNREFUSED, 「전체 메시지」는 connect ECONNREFUSED 127.0.0.1:3000. 여기까지 오면 시작할 때의 그 오류와 맞아떨어진다, 같은 오류 코드이고, 이번에는 노드 안에서 발생했을 뿐이다. 이 port를 가지고 nc -vz, 통하는지 바로 알 수 있다.
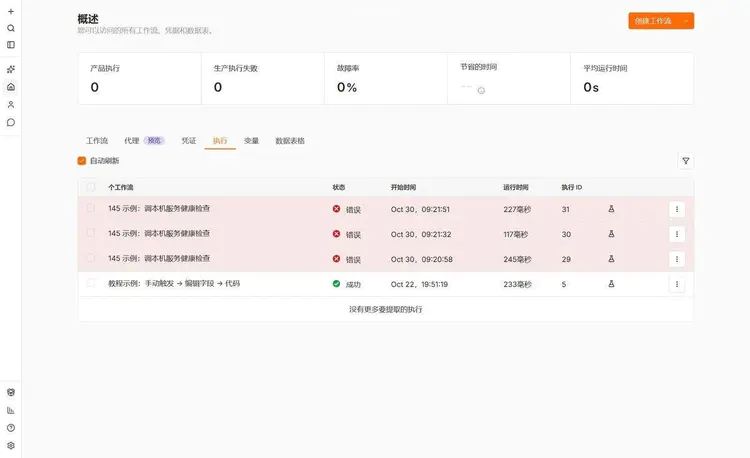
실행 기록에는 공짜 판별 기준이 하나 더 있다: 실행 시간. 내 이 세 번은 각각 227, 117, 245밀리초였다. TCP조차 핸드셰이크하지 못했을 때만 이렇게 빠르다; 상대가 연결은 되었지만 500을 반환하거나 timeout이면, 소요 시간은 수백 밀리초에서 수 초까지 다양하고, 심지어 네가 설정한 timeout에 닿을 수도 있다. 200밀리초 이내에 오류가 나면 바로 「port/주소/서비스 미시작」 쪽으로 생각하고, 「인터페이스 반환 내용이 잘못됨」 쪽으로 생각하는 것은 시간 낭비다.
여섯 가지 오류 원문 빠른 조회
| 오류 원문 | 어디서 막혔는지 | 처리 방향 |
|---|---|---|
n8n's port 5678 is already in use... |
세 번째 단락, port | ss -ltnp 'sport = :5678' pid를 찾아서 기존 것을 중지하거나 port를 변경 |
n8n webserver failed, exiting listen EADDRNOTAVAIL |
세 번째 단락, 주소 | 설정에 있는 IP가 본机에 없음,ip addr 확인 |
Error: listen EACCES: permission denied 0.0.0.0:80 |
세 번째 단락, 권한 | 1024 미만의 port는 권한이 필요하므로 port를 변경하거나 capability 추가 |
Initial database connection attempt N failed: connect ECONNREFUSED |
두 번째 단락, 데이터베이스 | 5회 재시도가 끝날 때까지 기다린 후, nc -vz host port |
DriverPackageNotInstalledError: SQLite package has not been found installed |
두 번째 단락, 의존성 | 补 sqlite3, 또는 n8n 재설치 |
EACCES: permission denied, mkdir '/.../.n8n' |
첫 번째 단락, 디렉터리 | 데이터 디렉터리 소유자가 잘못됨, owner를 수정하고 777은 사용하지 말 것 |
세 가지 보안 주의사항
문제 해결 중에 임시로 완화한 listening은 반드시 원래대로 되돌려 놓으세요.외부에서 서비스가 올라왔는지 한번 확인하기 위해 N8N_LISTEN_ADDRESS 를 0.0.0.0 로 바꾸거나 -p 5678:5678를 추가했다면, 확인 후 바로 잊어버리세요. n8n의 editor는 공인망에 노출되면 그 자체가 로그인 창이며, 스캔 스크립트 하나로 하루에 수천 번 시도할 수 있습니다. 제 이 장비는 127.0.0.1만 listening하고 공인망은 nginx 443으로 나가는 것이 상시 상태이며, 문제 해결을 위해 임시 상태로 바꾼 뒤 그대로 방치하지 마세요.
로그를 외부에 붙이기 전에 한 번 훑어보세요.시작 로그에는 완전한 webhook URL이 들어 있고, webhook 경로 자체가 자격 증명이라 경로만 확보하면 당신의 workflow에 데이터를 밀어넣을 수 있습니다. stack에는 설치 경로, 내부 주소, 데이터베이스 호스트명이 들어 있습니다. 그룹에 붙이거나 포럼에 도움을 요청하기 전에 이것들을 바꾸고 나서 붙이세요.
데이터베이스 비밀번호를 command line에 적지 마세요.docker run -e DB_POSTGRESDB_PASSWORD=xxx shell history에 남고 docker inspect 의 출력에도 나타나서, 같은 장비에서 docker 명령을 실행할 수 있는 사람이면 누구나 볼 수 있습니다. --env-file를 사용하거나 systemd의 EnvironmentFile=를 사용하고, 파일 권한은 600으로 하세요. 앞서 붙인 unit이 바로 그렇게 작성되어 있으며, 비밀번호는 /etc/n8n/instance-ai.env 안에 있고 unit 안에는 없습니다.
소결
시작 실패는 다양해 보이지만 사실 네 단계입니다: 키, 데이터베이스, 리스닝, 마이그레이션. 로그가 어느 줄에서 멈추는지가 어떤 명령을 입력해야 하는지를 결정합니다, 추측은 소용없습니다—그 "혹시 이미 다른 n8n이 실행 중인가요"라는 말은 순전히 사람을 속이는 것입니다.
세 개의 명령이면 충분합니다:ss -ltnp 'sport = :端口' 점유자를 찾고,nc -vz host 端口 연결을 검증하고,curl /healthz/readiness 준비 상태를 검증합니다. 나머지는 모두 오류 원문을 보고 이 글의 표를 대조하면 됩니다.
마지막 한마디 경험:n8n ready on 和 Editor is now accessible via 사이의 그 구간이 가장 쉽게 이미 끝났다고 착각하게 됩니다. 마이그레이션이 끝나기 전에 재시작하거나 아예 전원을 끄는 것은 제가 본 가장 대가가 큰 "사소한 조작"입니다.
이어서 계속
이전 글은《첫 번째 워크플로: 수동 트리거 → 필드 편집 → 코드》이며, 처음부터 하나의 흐름을 구축하려면 그 글을 보세요. 아직 설치하지 않았다면《n8n 설치 방법》을 보고, 인터페이스가 익숙하지 않다면《인터페이스 가이드》를 참고하세요. 산발적인 장애 기록은 제가 정리해 두었습니다.문제 해결페이지, 전체 강좌의 목차는여기。
참고 자료
- Monitor n8n:
/healthz프로세스 생존 여부만 확인,/healthz/readiness데이터베이스가 연결되고 마이그레이션이 완료되어야 함 - Deployment 환경 변수:
N8N_PORT기본 5678,N8N_LISTEN_ADDRESS기본::、N8N_USER_FOLDER의 용도 - Database 환경 변수:
DB_TYPE기본 sqlite,DB_POSTGRESDB_PORT기본 5432, 그리고 실행 중 연결 끊김 시 자동 복구 파라미터 - Logs 환경 변수:
N8N_LOG_OUTPUT기본 console, file로 설정하면 로그가 기록되는 위치<n8n 目录>/logs/n8n.log - Use the command line:
n8n start、n8n export:workflow이러한 서버 명령은 대부분 n8n이 실행 중이지 않아도 됩니다 - Install with Docker: 공식 run 명령의 port mapping과
/home/node/.n8n卷 - Install with npm: Node 버전 범위 20.19 ~ 24.x
- Node.js errors:
EADDRINUSE、ECONNREFUSED、EACCES、EADDRNOTAVAIL각각의 정의
최종 업데이트: 2026년 10월 30일, n8n 2.43.7 기준.



